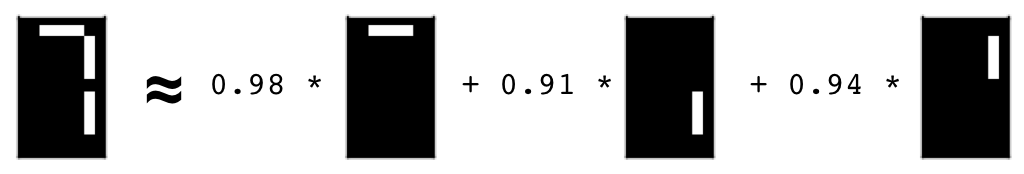非負値行列因子分解(NMF)

Pythonで学ぶ教師なし学習

Benjamin Wilson

Director of Research at lateral.io

非負値行列因子分解

  • NMF =「非負値行列因子分解」
  • 次元削減手法
  • NMFモデルは解釈しやすい(PCAとは異なる)
  • 解釈しやすい = 他の人にも説明しやすい
  • ただし、すべてのサンプル特徴量が非負(0以上)である必要がある
Pythonで学ぶ教師なし学習

解釈しやすいパーツ

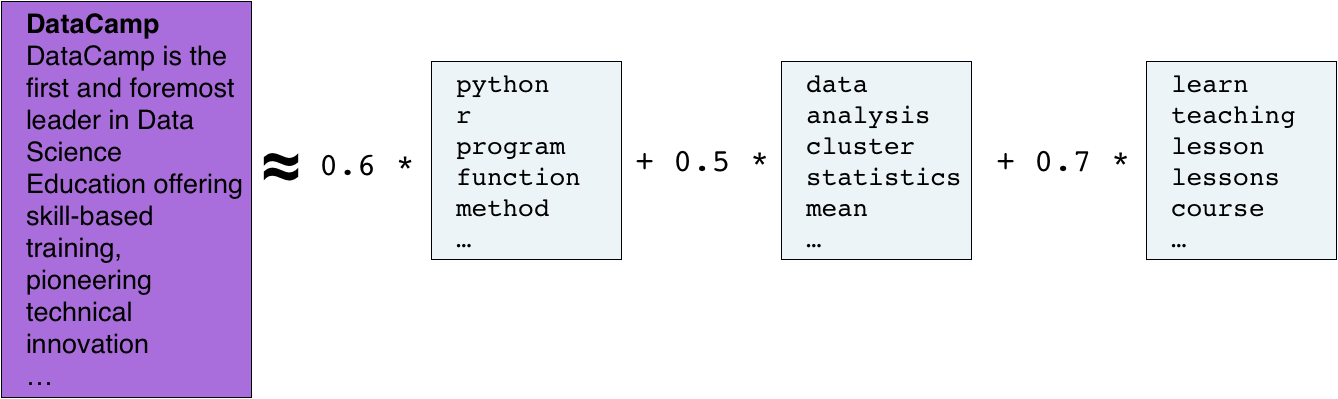
  • NMFは、ドキュメントをトピック(またはテーマ)別に組み合わせる

テキストボックス: DataCampは、データサイエンス教育の分野で最先端を行くリーダーであり、スキルベースのトレーニングと革新的な技術を提供しています… 約等号 0.6 × テキストボックス(program、r、Python、function、method)、+ 0.5 × テキストボックス(データ、analysis、cluster、statistics、mean)、+ 0.7 × テキストボックス(teaching、learn、lesson、lessons、コース)

Pythonで学ぶ教師なし学習

解釈しやすいパーツ

  • NMFは画像を共通のパターンで組み合わせて表す

3本のストライプのあるボックス ≒ 0.98 × 1本ストライプのボックス + 0.91 × 別のストライプのボックス + 0.95 × 別のストライプのボックス

Pythonで学ぶ教師なし学習

scikit-learnのNMFを使う

  • fit() / transform() パターンに従う
  • 成分数を指定する必要あり(例:NMF(n_components=2)
  • NumPy配列およびcsr_matrixに対応
Pythonで学ぶ教師なし学習

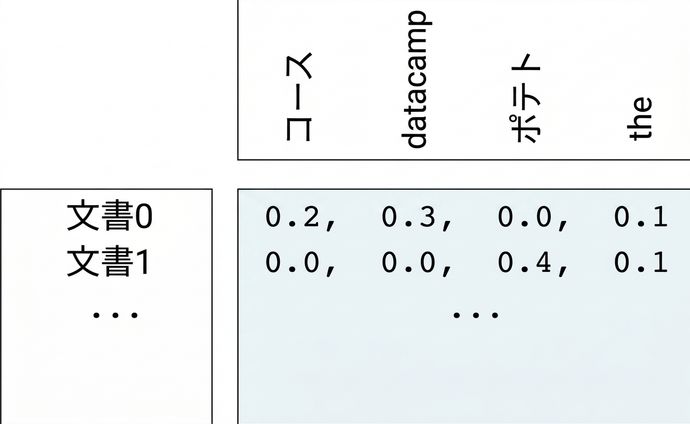
単語出現頻度の配列の例

  • 単語出現頻度の配列、4語、多数のドキュメント
  • 各ドキュメント内の単語出現度を「tf-idf」で測定
    • 「tf」=ドキュメント内の単語の出現頻度
    • 「idf」は頻出単語の重要度を下げる

単語出現頻度の配列

Pythonで学ぶ教師なし学習

NMFの使用例

  • samples = 単語出現頻度配列
from sklearn.decomposition import NMF

model = NMF(n_components=2)
model.fit(samples)
NMF(n_components=2)
nmf_features = model.transform(samples)
Pythonで学ぶ教師なし学習

NMFの成分

  • NMFには成分がある
  • PCAに主成分があるのと同様
  • 成分の次元 = サンプルの次元
  • 成分は非負
print(model.components_)
[[ 0.01  0.    2.13  0.54]
 [ 0.99  1.47  0.    0.5 ]]
Pythonで学ぶ教師なし学習

NMFの特徴量

  • NMFの特徴量も非負
  • サンプルデータの再現に使われる
  • 特徴量の値を成分と組み合わせる
print(nmf_features)
[[ 0.    0.2 ]
 [ 0.19  0.  ]
  ...
 [ 0.15  0.12]]
Pythonで学ぶ教師なし学習

サンプルの再現

print(samples[i,:])
[ 0.12  0.18  0.32  0.14]
print(nmf_features[i,:])
[ 0.15  0.12]
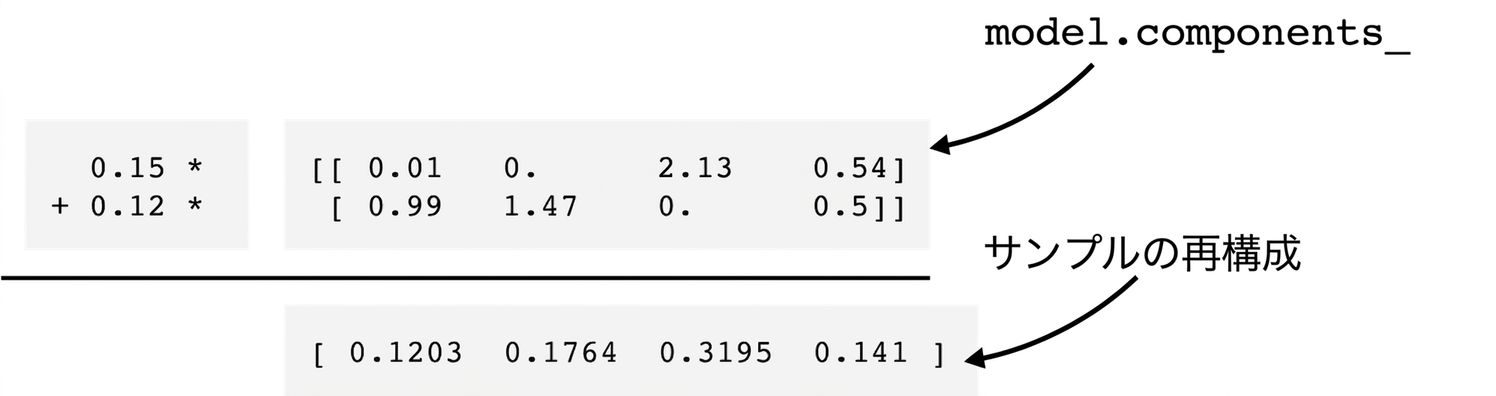
NMFの成分を特徴量の値で乗算し、合計

Pythonで学ぶ教師なし学習

サンプルの再現

  • 成分に特徴量の値を掛けて、足し合わせる
  • 行列の積としても表現可能
  • 「NMF」におけるMF(Matrix Factorization=行列因子分解)の部分
Pythonで学ぶ教師なし学習

NMFは非負のデータのみに適合

  • 各ドキュメント内の単語出現頻度
  • 画像を非負の配列として数値化
  • 音声のスペクトログラム
  • ECサイトでの購入履歴
  • その他、多くの例がある
Pythonで学ぶ教師なし学習

練習しましょう!

Pythonで学ぶ教師なし学習

Preparing Video For Download...