Pythonで学ぶ教師なし学習
Benjamin Wilson
Director of Research at lateral.io
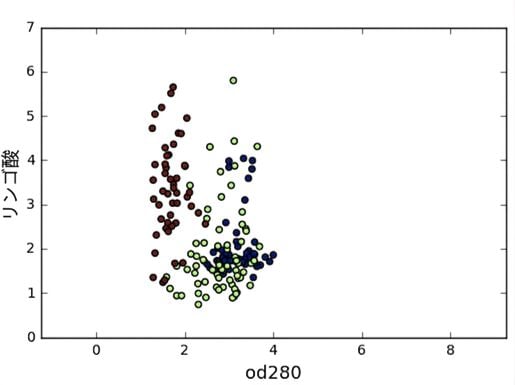
3種類の赤ワインからの178サンプル: バローロ、グリニョリーノ、バルベーラ
特徴量:アルコール含有量などの化学組成物
「色の濃さ」などの視覚的特性
from sklearn.cluster import KMeans
model = KMeans(n_clusters=3)
labels = model.fit_predict(samples)
df = pd.DataFrame({'labels': labels, 'varieties': varieties}) ct = pd.crosstab(df['labels'], df['varieties'])print(ct)
varieties Barbera Barolo Grignolino
labels
0 29 13 20
1 0 46 1
2 19 0 50
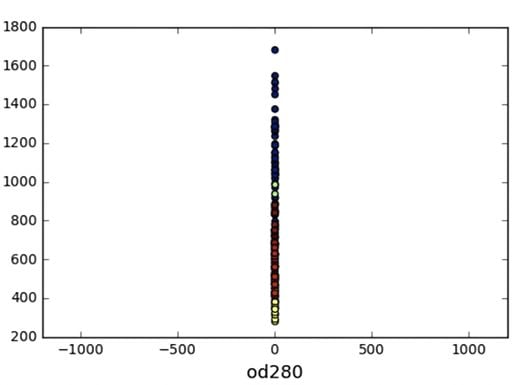
ワインの特徴量ごとに分散が大きく異なる
特徴量の分散=その値のばらつきの度合い
feature variance
alcohol 0.65
malic_acid 1.24
...
od280 0.50
proline 99166.71

ワインの特徴量は分散が大きく異なる
特徴量の分散=その値のばらつきの度合い
feature variance
alcohol 0.65
malic_acid 1.24
...
od280 0.50
proline 99166.71

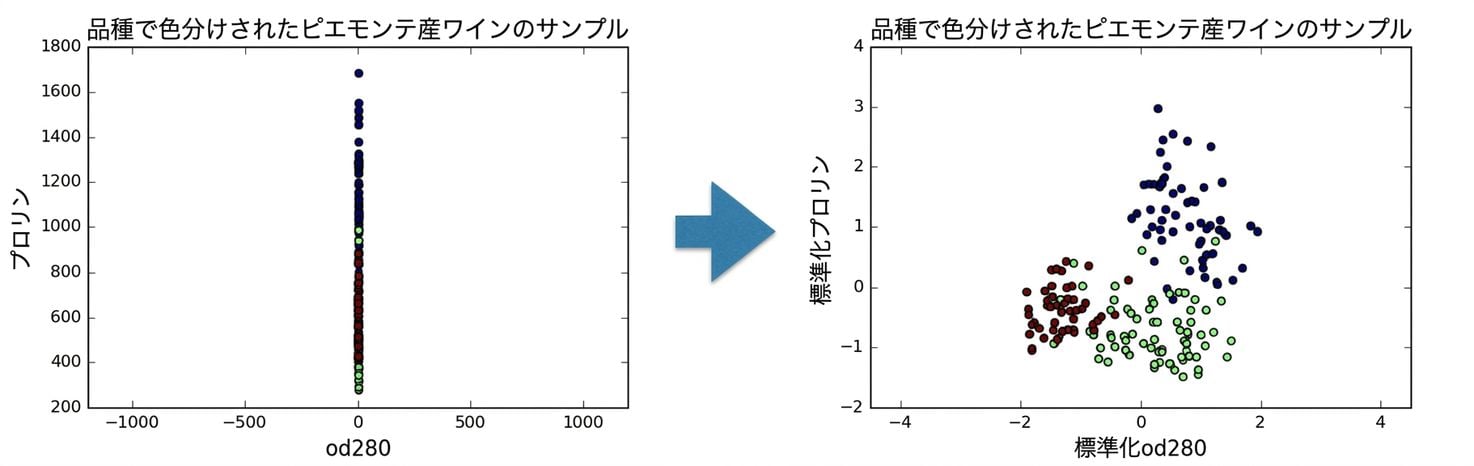
K平均法では、特徴量の分散 = クラスタリングへの影響度
StandardScalerは各特徴量を平均0、分散1になるように変換
特徴量を「標準化」する

from sklearn.preprocessing import StandardScalerscaler = StandardScaler()scaler.fit(samples) StandardScaler(copy=True, with_mean=True, with_std=True)samples_scaled = scaler.transform(samples)
StandardScalerとKMeansは似たメソッドを持つ
StandardScalerはfit() / transform()を使用
-KMeansはfit() / predict()を使用
2つのステップが必要:StandardScaler → KMeans
複数のステップを組み合わせるにはsklearnパイプラインを使用
データが一つのステップから次のステップへ流れる
from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans scaler = StandardScaler() kmeans = KMeans(n_clusters=3)from sklearn.pipeline import make_pipelinepipeline = make_pipeline(scaler, kmeans)pipeline.fit(samples)
Pipeline(steps=...)
labels = pipeline.predict(samples)
【標準化あり】
varieties Barbera Barolo Grignolino
labels
0 0 59 3
1 48 0 3
2 0 0 65
【標準化なし(悪い結果)】
varieties Barbera Barolo Grignolino
labels
0 29 13 20
1 0 46 1
2 19 0 50
StandardScalerは「前処理」ステップ
MaxAbsScalerやNormalizerなどの他の手法も
Pythonで学ぶ教師なし学習