クラスタリングの評価

Pythonで学ぶ教師なし学習

Benjamin Wilson

Director of Research at lateral.io

クラスタリングの評価

  • クラスターと実際のアヤメの品種を比較する
  • しかし、照合する正しいデータがない場合は?
  • クラスタリングの品質を測定する
  • クラスタをいくつにするかの判断に役立つ
Pythonで学ぶ教師なし学習

アヤメ:クラスタと品種

  • K平均法でサンプルが3つのクラスタに分かれた
  • クラスターは品種に対応しているか?
species  setosa  versicolor  virginica
labels
0             0           2         36
1            50           0          0
2             0          48         14
Pythonで学ぶ教師なし学習

pandasでクロス集計

  • クラスターと品種は「クロス集計」
  • pandasライブラリを使用
  • 各サンプルの品種をspeciesというリストとして指定
print(species)
['setosa', 'setosa', 'versicolor', 'virginica', ... ]
Pythonで学ぶ教師なし学習

ラベルと品種の照合

import pandas as pd
df = pd.DataFrame({'labels': labels, 'species': species})
print(df)
     labels     species
0         1      setosa
1         1      setosa
2         2  versicolor
3         2   virginica
4         1      setosa
...
Pythonで学ぶ教師なし学習

ラベルと品種のクロス集計

ct = pd.crosstab(df['labels'], df['species'])
print(ct)
species  setosa  versicolor  virginica
labels
0             0           2         36
1            50           0          0
2             0          48         14

照合できる品種情報がない場合、クラスタリングをどのように評価するか?

Pythonで学ぶ教師なし学習

クラスタリング品質の評価

  • サンプルとそのクラスタラベルのみを使用

  • 良いクラスタリングは、密集したクラスタ

  • 各クラスタ内のサンプルがまとまっている

Pythonで学ぶ教師なし学習

クラスタリングの質の指標:誤差平方和(SSE)

  • クラスターの分散度を測定(低いほど良い)
  • 各サンプルからクラスタのセントロイドまでの距離
  • fit()の後、inertia_属性として取得できる
  • k-meansはSSEが最小になるように配置する
from sklearn.cluster import KMeans

model = KMeans(n_clusters=3)
model.fit(samples)
print(model.inertia_)
78.9408414261
Pythonで学ぶ教師なし学習

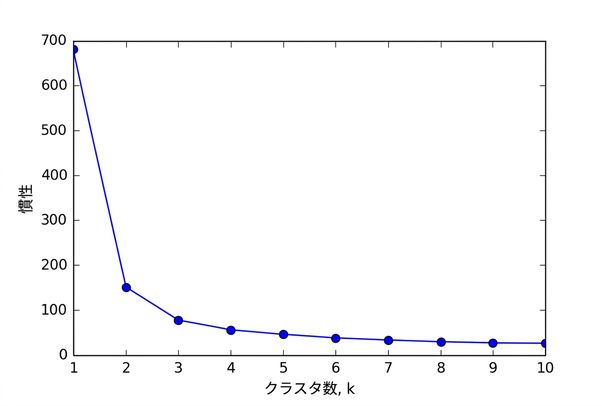
クラスター数

  • アヤメのデータを異なるクラスタ数にした場合
  • クラスター数が多いほど、SSEは低くなる
  • 最適なクラスタ数は?

クラスタ数とSSEの折れ線グラフ

Pythonで学ぶ教師なし学習

クラスタ数の選び方

  • 良いクラスタリングは、密集したクラスタ(=SSEが低い)
  • ただし、クラスタ数が多すぎるのも良くない
  • プロットの「エルボー」ポイントを選ぶ
  • SSE減少がゆるやかになり始めるところ
  • 例:アヤメのデータセットの場合、3が適切

クラスタ数とSSEの折れ線グラフ

Pythonで学ぶ教師なし学習

練習しましょう!

Pythonで学ぶ教師なし学習

Preparing Video For Download...