LangChainでRAG用ドキュメントを読み込む

LangChainで学ぶ検索拡張生成(RAG)

Meri Nova

Machine Learning Engineer

講師を紹介します…
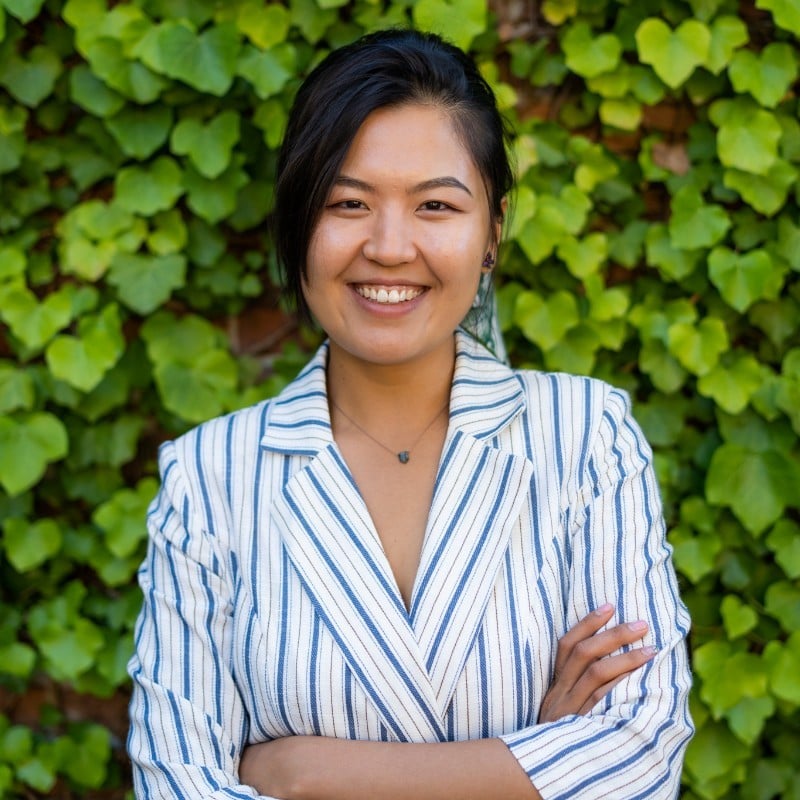
Meri Nova
  • Break Into Dataの創業者
  • 機械学習エンジニア
  • Linkedin・YouTubeコンテンツクリエイター

Meriの写真

LangChainで学ぶ検索拡張生成(RAG)

検索拡張生成(RAG)

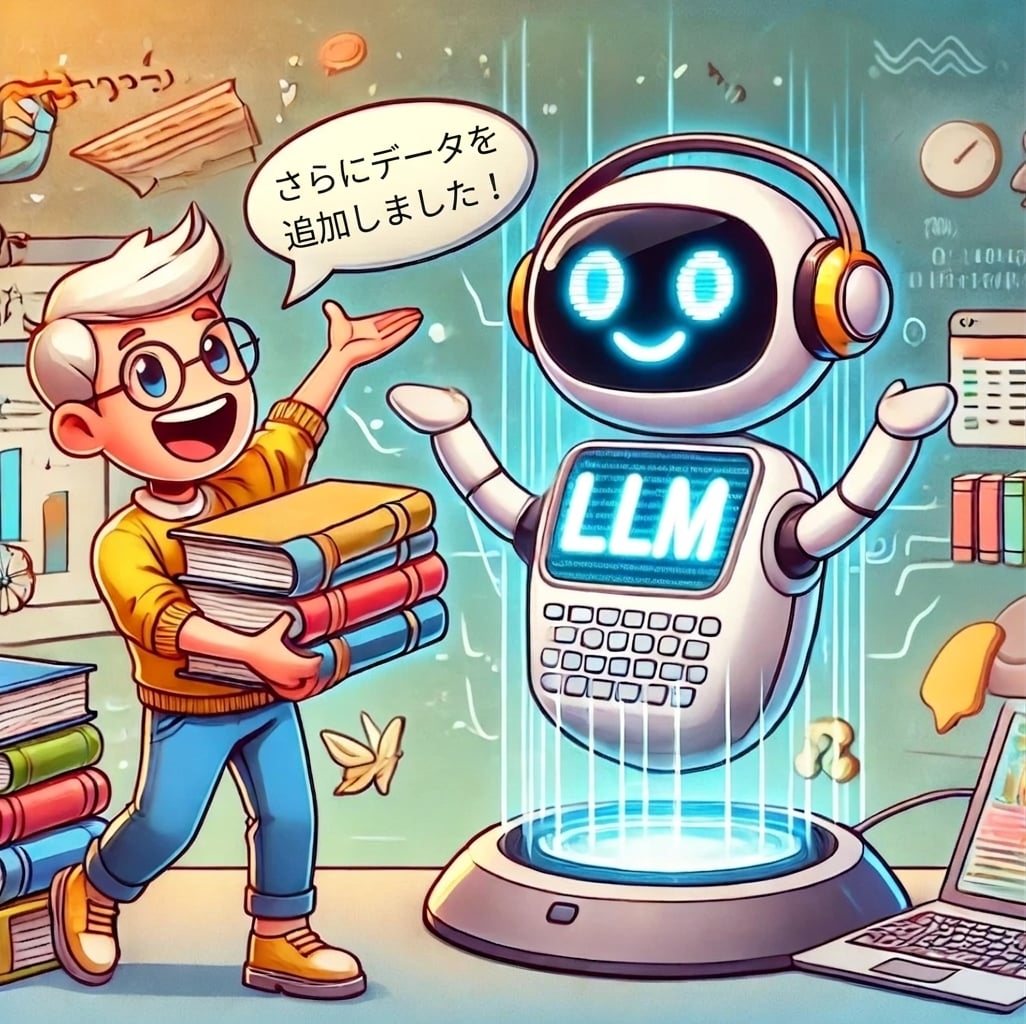
  • LLMの制限:ナレッジの限界

RAG: 外部データとLLMの統合

人がLLMに追加情報を渡している様子。

1 DALL·E 3を使って生成
LangChainで学ぶ検索拡張生成(RAG)

RAGの基本的な流れ

1人のユーザー。

LangChainで学ぶ検索拡張生成(RAG)

RAGの基本的な流れ

ユーザーのクエリがベクターデータベースに送信される様子。

LangChainで学ぶ検索拡張生成(RAG)

RAGの基本的な流れ

ベクトルデータベースから関連ドキュメントを取得。

LangChainで学ぶ検索拡張生成(RAG)

RAGの基本的な流れ

取得したドキュメントがモデルプロンプトに追加される。

LangChainで学ぶ検索拡張生成(RAG)

RAGの基本的な流れ

プロンプトがLLMに送信され、出力がユーザーに返される。

LangChainで学ぶ検索拡張生成(RAG)

検索用データの準備

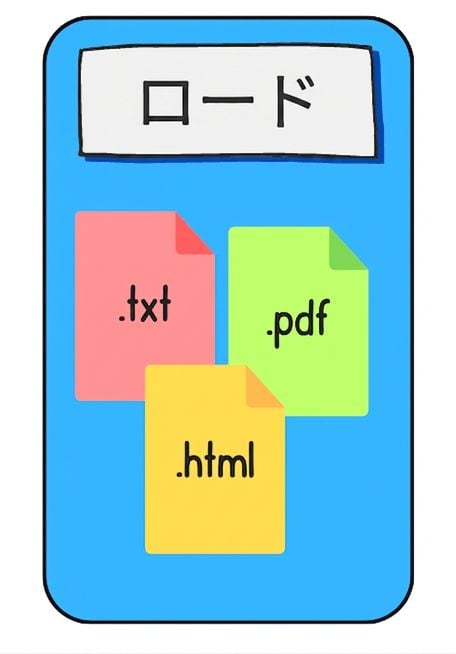
ドキュメントを読み込み中。

LangChainで学ぶ検索拡張生成(RAG)

検索用データの準備

ドキュメントの分割。

LangChainで学ぶ検索拡張生成(RAG)

検索用データの準備

ドキュメントチャンクがエンベディングされる。

LangChainで学ぶ検索拡張生成(RAG)

検索用データの準備

ドキュメントチャンクが保存される。

LangChainで学ぶ検索拡張生成(RAG)

ドキュメントローダー

  • ドキュメントをAIシステムに統合
  • 多くのファイル形式に対応
  • 第三者機関のドキュメントローダー
  • CSVLoader
  • PyPDFLoader
  • UnstructuredHTMLLoader

ドキュメントを読み込み中。

LangChainで学ぶ検索拡張生成(RAG)

CSVファイルの読み込み

from langchain_community.document_loaders.csv_loader import CSVLoader

csv_loader = CSVLoader(file_path='path/to/your/file.csv')

documents = csv_loader.load() print(documents)
[Document(page_content='Team: Nationals\n"Payroll (millions)": 81.34\n"Wins": 98',
          metadata={'source': 'path/to/your/file.csv', 'row': 0}),
 Document(page_content='Team: Reds\n"Payroll (millions)": 82.20\n"Wins": 97',
          metadata={'source': 'path/to/your/file.csv', 'row': 1}),
 Document(page_content='Team: Yankees\n"Payroll (millions)": 197.96\n"Wins": 95',
          metadata={'source': 'path/to/your/file.csv', 'row': 2})]
LangChainで学ぶ検索拡張生成(RAG)

PDFファイルの読み込み

from langchain_community.document_loaders import PyPDFLoader

pdf_loader = PyPDFLoader('rag_paper.pdf')
documents = pdf_loader.load()
print(documents)
[Document(page_content='Retrieval-Augmented Generation for\nKnowledge-Intensive...',
          metadata={'source': 'Rag Paper.pdf', 'page': 0})]
LangChainで学ぶ検索拡張生成(RAG)

HTMLファイルの読み込み

from langchain_community.document_loaders import UnstructuredHTMLLoader

html_loader = UnstructuredHTMLLoader(file_path='path/to/your/file.html')

documents = html_loader.load() first_document = documents[0]
print("Content:", first_document.page_content) print("Metadata:", first_document.metadata)
Content: Welcome to Our Website
Metadata: {'source': 'path/to/your/file.html', 'section': 0}
LangChainで学ぶ検索拡張生成(RAG)

お疲れさまでした!

LangChainで学ぶ検索拡張生成(RAG)

Preparing Video For Download...