RAGの評価
LangChainで学ぶ検索拡張生成(RAG)

Meri Nova
Machine Learning Engineer
RAGの性能評価ポイント
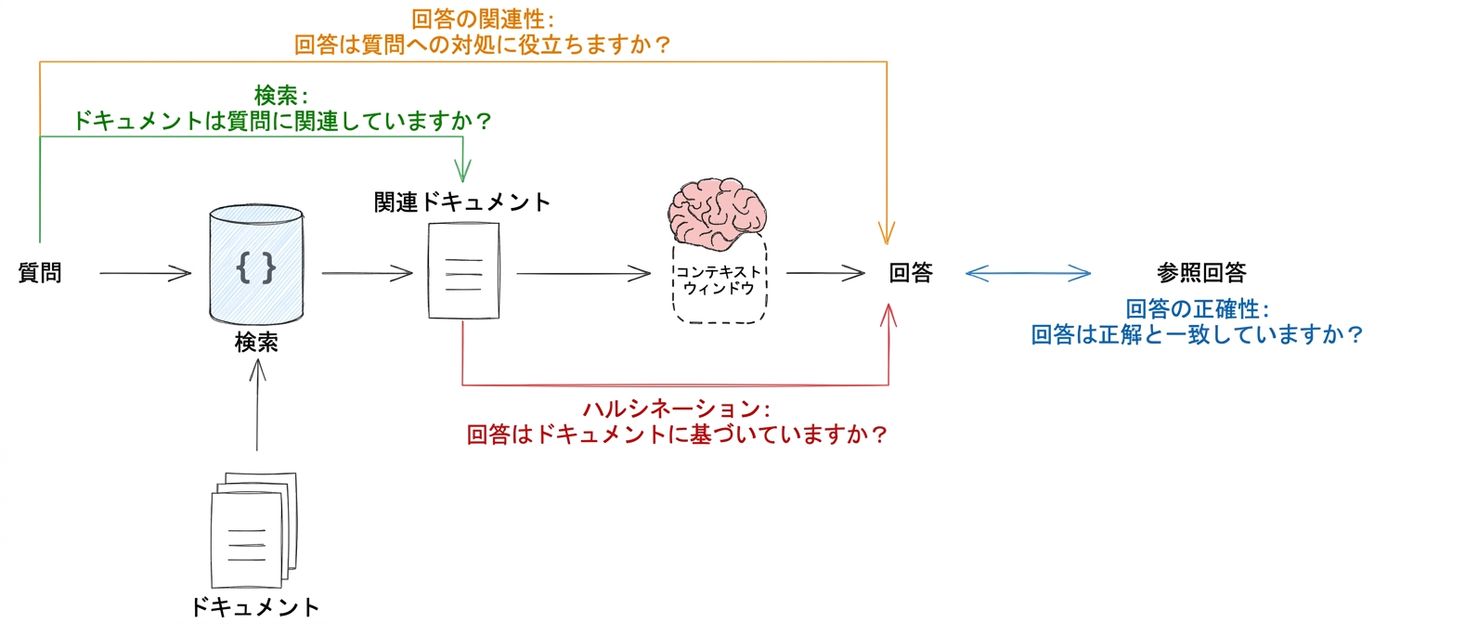
1 画像提供: LangSmith
出力の正確性:文字列評価
query = "What are the main components of RAG architecture?"
predicted_answer = "Training and encoding"
ref_answer = "Retrieval and Generation"
出力の正確性:文字列評価
prompt_template = """You are an expert professor specialized in grading students' answers to questions.
You are grading the following question:{query}
Here is the real answer:{answer}
You are grading the following predicted answer:{result}
Respond with CORRECT or INCORRECT:
Grade:"""

prompt = PromptTemplate(
    input_variables=["query", "answer", "result"],
    template=prompt_template
)

eval_llm = ChatOpenAI(temperature=0, model="gpt-4o-mini", openai_api_key='...')
出力の正確性:文字列評価
from langsmith.evaluation import LangChainStringEvaluator qa_evaluator = LangChainStringEvaluator( "qa", config={ "llm": eval_llm, "prompt": PROMPT } )score = qa_evaluator.evaluator.evaluate_strings( prediction=predicted_answer, reference=ref_answer, input=query )
出力の正確性:文字列評価
print(f"Score: {score}")
Score: {'reasoning': 'INCORRECT', 'value': 'INCORRECT', 'score': 0}
query = "What are the main components of RAG architecture?"
predicted_answer = "Training and encoding"
ref_answer = "Retrieval and Generation"
Ragasの枠組み
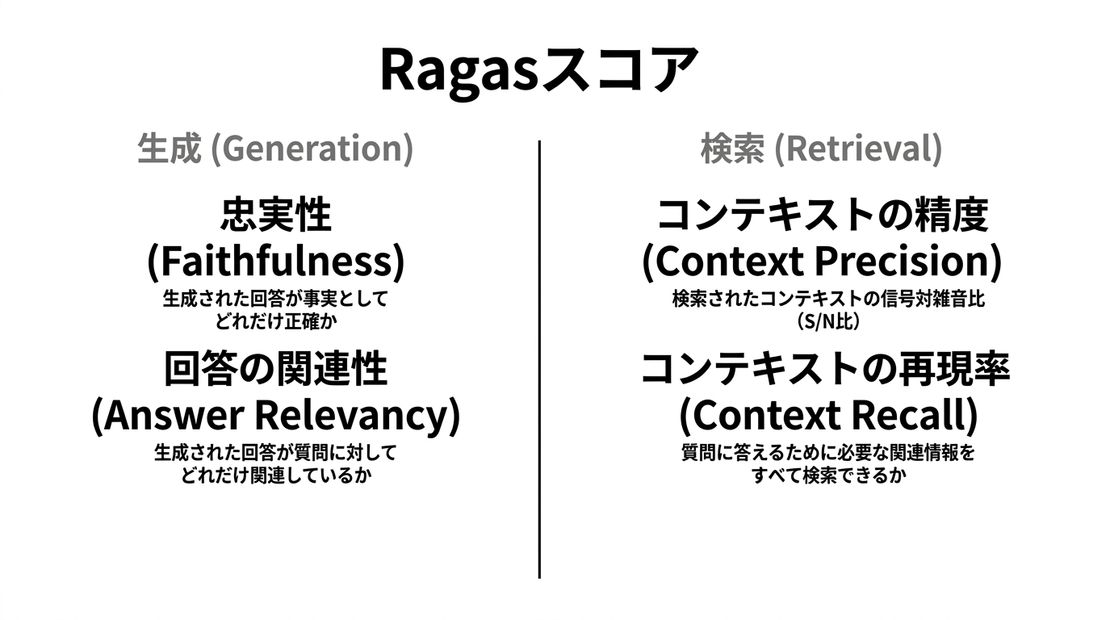
1 画像提供: Ragas
忠実性(Faithfulness)
- 生成された出力がコンテキストに忠実か
$$ \text{Faithfulness} = \frac{\text{コンテキストから推測できる主張の数}}{\text{主張の総数}} $$
(0, 1)に正規化
忠実性の評価
from langchain_openai import ChatOpenAI, OpenAIEmbeddingsfrom ragas.integrations.langchain import EvaluatorChain from ragas.metrics import faithfulnessllm = ChatOpenAI(model="gpt-4o-mini", api_key="...") embeddings = OpenAIEmbeddings(model="text-embedding-3-small", api_key="...")faithfulness_chain = EvaluatorChain( metric=faithfulness, llm=llm, embeddings=embeddings )
忠実性の評価
eval_result = faithfulness_chain({"question": "How does the RAG model improve question answering with LLMs?","answer": "The RAG model improves question answering by combining the retrieval of documents...","contexts": [ "The RAG model integrates document retrieval with LLMs by first retrieving relevant passages...", "By incorporating retrieval mechanisms, RAG leverages external knowledge sources, allowing the...", ]})print(eval_result)
'faithfulness': 1.0
コンテキスト精度(Context precision)
- 取得したドキュメントが質問にどれだけ関連しているか
(0, 1)に正規化 →1= 関連性が高い
from ragas.metrics import context_precision

llm = ChatOpenAI(model="gpt-4o-mini", api_key="...")
embeddings = OpenAIEmbeddings(model="text-embedding-3-small", api_key="...")

context_precision_chain = EvaluatorChain(
    metric=context_precision,
    llm=llm,
    embeddings=embeddings
)
コンテキスト精度の評価
eval_result = context_precision_chain({ "question": "How does the RAG model improve question answering with large language models?", "ground_truth": "The RAG model improves question answering by combining the retrieval of...", "contexts": [ "The RAG model integrates document retrieval with LLMs by first retrieving...", "By incorporating retrieval mechanisms, RAG leverages external knowledge sources...", ] })print(f"Context Precision: {eval_result['context_precision']}")
Context Precision: 0.99999999995
お疲れさまでした!
LangChainで学ぶ検索拡張生成(RAG)

