コードファイルの読み込みと分割

LangChainで学ぶ検索拡張生成(RAG)

Meri Nova

Machine Learning Engineer

さまざまなドキュメントローダー

さまざまなファイル形式の例。

LangChainで学ぶ検索拡張生成(RAG)

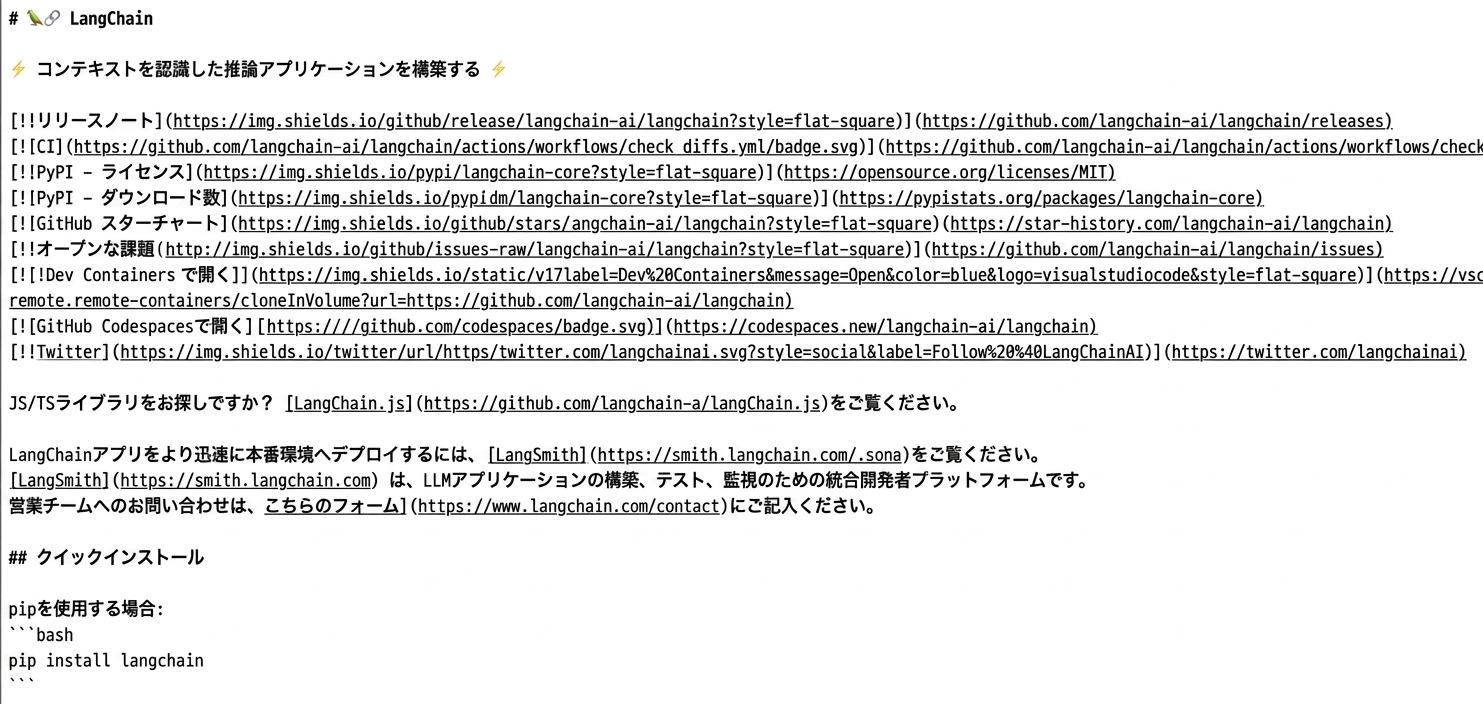
LangChainのGitHubリポジトリでREADMEファイルを作成するために使用された生Markdownデータ

LangChainで学ぶ検索拡張生成(RAG)

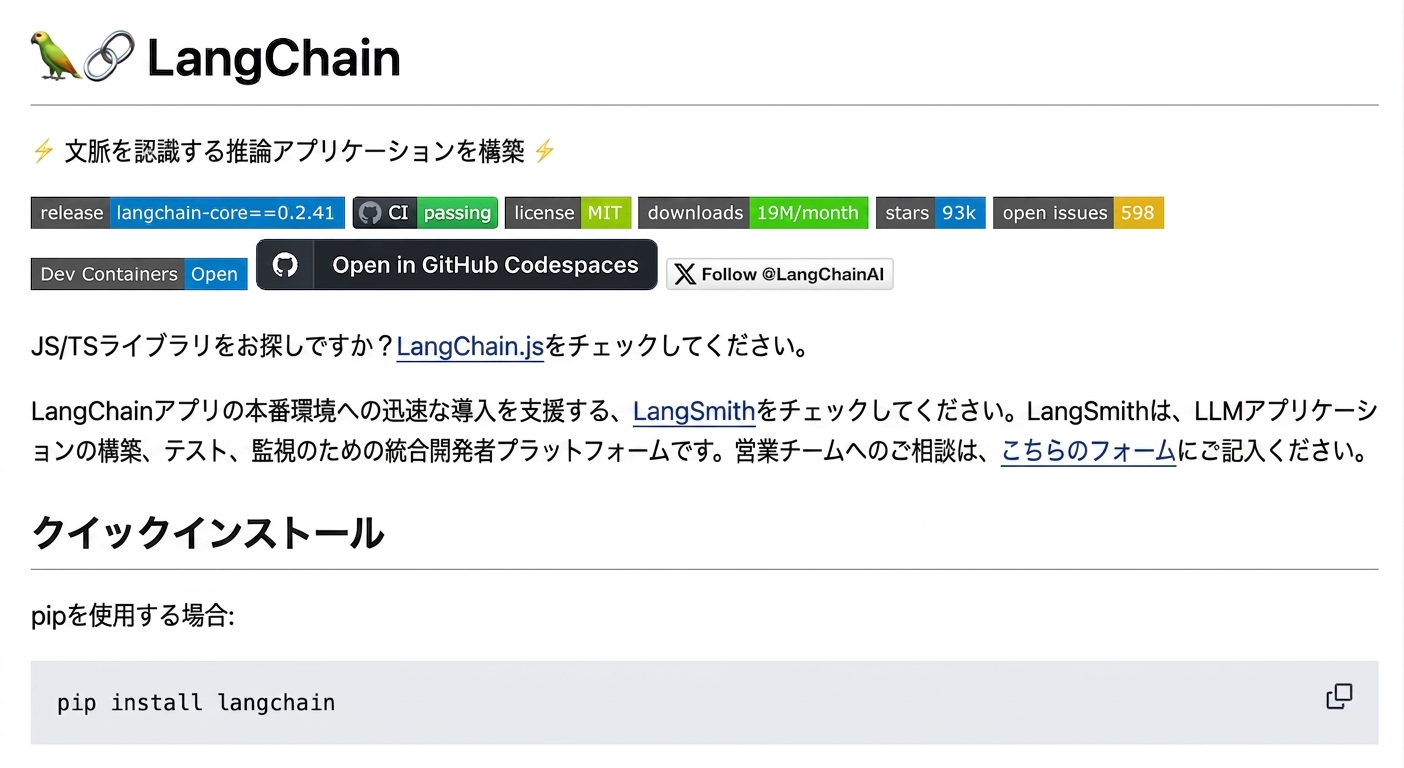
LangChainのGitHub README.mdファイルからレンダリングされたmarkdown

LangChainで学ぶ検索拡張生成(RAG)

Markdownファイル(.md)の読み込み

from langchain_community.document_loaders import UnstructuredMarkdownLoader

loader = UnstructuredMarkdownLoader("README.md")
markdown_content = loader.load() print(markdown_content[0])
Document(page_content='# Discord Text Classification ![Python Version](https...'
         metadata={'source': 'README.md'})
LangChainで学ぶ検索拡張生成(RAG)

Pythonファイル(.py)の読み込み

from abc import ABC, abstractmethod

class LLM(ABC):
  @abstractmethod
  def complete_sentence(self, prompt):
    pass

...
  • コードの作成や修正、ドキュメント作成などを行うRAGアプリに統合
  • import、クラス、関数など
from langchain_community.document_loaders \
    import PythonLoader

loader = PythonLoader('chatbot.py')

python_data = loader.load() print(python_data[0])
Document(page_content='from abc import ABC, ...

class LLM(ABC):
  @abstractmethod
...',
metadata={'source': 'chatbot.py'})
LangChainで学ぶ検索拡張生成(RAG)

コードファイルの分割

python_splitter = RecursiveCharacterTextSplitter(
    chunk_size=150, chunk_overlap=10
)

chunks = python_splitter.split_documents(python_data) for i, chunk in enumerate(chunks[:3]): print(f"Chunk {i+1}:\n{chunk.page_content}\n")
LangChainで学ぶ検索拡張生成(RAG)
Chunk 1:
from abc import ABC, abstractmethod

class LLM(ABC):
  @abstractmethod
  def complete_sentence(self, prompt):
    pass

Chunk 2:
class OpenAI(LLM):
  def complete_sentence(self, prompt):
    return prompt + " ... OpenAI end of sentence."

class Anthropic(LLM):

Chunk 3:
def complete_sentence(self, prompt):
    return prompt + " ... Anthropic end of sentence."

LangChainで学ぶ検索拡張生成(RAG)

言語による分割

  • separators
    • ["\n\n", "\n", " ", ""]
    • ["\nclass ", "\ndef ", "\n\tdef ", "\n\n", " ", ""]
from langchain_text_splitters import RecursiveCharacterTextSplitter, Language

python_splitter = RecursiveCharacterTextSplitter.from_language(

language=Language.PYTHON, chunk_size=150, chunk_overlap=10
)
chunks = python_splitter.split_documents(data)
for i, chunk in enumerate(chunks[:3]): print(f"Chunk {i+1}:\n{chunk.page_content}\n")
LangChainで学ぶ検索拡張生成(RAG)
Chunk 1:
from abc import ABC, abstractmethod

Chunk 2:
class LLM(ABC):
  @abstractmethod
  def complete_sentence(self, prompt):
    pass

Chunk 3:
class OpenAI(LLM):
  def complete_sentence(self, prompt):
LangChainで学ぶ検索拡張生成(RAG)

お疲れさまでした!

LangChainで学ぶ検索拡張生成(RAG)

Preparing Video For Download...