テキスト分割・エンベディング・保存

LangChainで学ぶ検索拡張生成(RAG)

Meri Nova

Machine Learning Engineer

検索用データの準備

ドキュメントを読み込み中。

LangChainで学ぶ検索拡張生成(RAG)

検索用データの準備

ドキュメントの分割。

LangChainで学ぶ検索拡張生成(RAG)

検索用データの準備

ドキュメントチャンクがエンベディングされる。

LangChainで学ぶ検索拡張生成(RAG)

検索用データの準備

ドキュメントチャンクが保存される。

LangChainで学ぶ検索拡張生成(RAG)

検索用データの準備

分割ステップがRAG開発ワークフローで強調表示されている。

LangChainで学ぶ検索拡張生成(RAG)

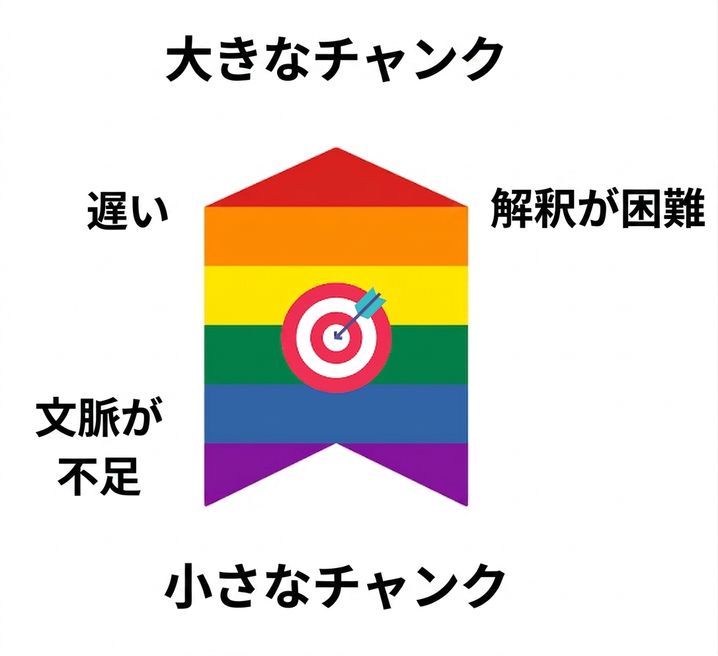
chunk_size

理想的なチャンクサイズは中間に位置します。大きすぎるチャンクは検索が遅くなり、解釈が難しくなることがあり、小さすぎるチャンクは十分な文脈を含まない場合があります。

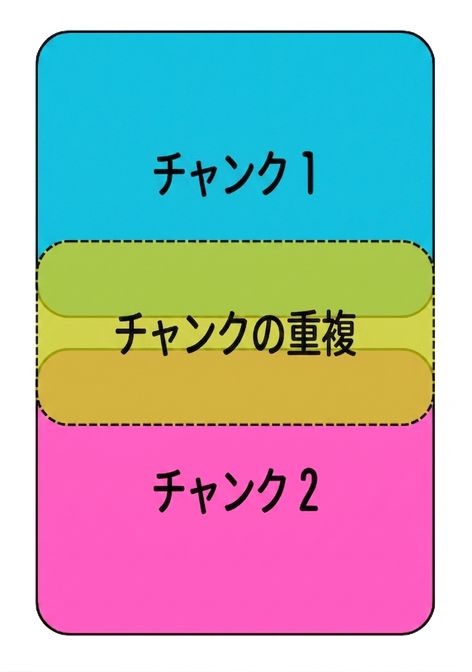
chunk_overlap

  • 区切り部分を超えた情報も含める

2つのチャンクと、両方に重なる領域が強調されている。

LangChainで学ぶ検索拡張生成(RAG)

CharacterTextSplitter

from langchain_text_splitters import CharacterTextSplitter

text = """Machine learning is a fascinating field.\n\nIt involves algorithms and models that can learn from data. These models can then make predictions or decisions without being explicitly programmed to perform the task.\nThis capability is increasingly valuable in various industries, from finance to healthcare.\n\nThere are many types of machine learning, including supervised, unsupervised, and reinforcement learning.\nEach type has its own strengths and applications."""
text_splitter = CharacterTextSplitter( separator="\n\n", chunk_size=100, chunk_overlap=10 )
LangChainで学ぶ検索拡張生成(RAG)

CharacterTextSplitter

chunks = text_splitter.split_text(text)

print(chunks) print([len(chunk) for chunk in chunks])
['Machine learning is a fascinating field.',
 'It involves algorithms and models that can learn from data. These models can...',
 'There are many types of machine learning, including supervised, unsupervised...']

[40, 260, 155]
  • コンテキストが欠ける場合がある
  • chunk_sizeを超える場合もある
LangChainで学ぶ検索拡張生成(RAG)

RecursiveCharacterTextSplitter

from langchain_text_splitters import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(

separators=["\n\n", "\n", " ", ""],
chunk_size=100, chunk_overlap=10
)
LangChainで学ぶ検索拡張生成(RAG)

RecursiveCharacterTextSplitter

chunks = splitter.split_text(text)

print(chunks)
print([len(chunk) for chunk in chunks])
['Machine learning is a fascinating field.',
 'It involves algorithms and models that can learn from data. These models ...',
 'or decisions without being explicitly programmed to perform the task.',
 'This capability is increasingly valuable in various industries, from ...',
 'There are many types of machine learning, including supervised, ...',
 'learning.',
 'Each type has its own strengths and applications.']
[40, 98, 69, 91, 95, 9, 49]
LangChainで学ぶ検索拡張生成(RAG)

ドキュメントの分割

from langchain_community.document_loaders import PyPDFLoader

loader = PyPDFLoader("research_paper.pdf")
documents = loader.load()

splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)

chunks = splitter.split_documents(documents)
LangChainで学ぶ検索拡張生成(RAG)

ドキュメントの分割

print(chunks)

print([len(chunk.page_content) for chunk in chunks])
[Document(metadata={'source': 'Rag Paper.pdf', 'page': 0}, page_content='...'),
 Document(metadata={'source': 'Rag Paper.pdf', 'page': 0}, page_content='...'),
 Document(metadata={'source': 'Rag Paper.pdf', 'page': 0}, page_content='...')]

[928, 946, 921,...]
LangChainで学ぶ検索拡張生成(RAG)

エンベディングと保存

エンベディングと保存のステップが強調されている。

LangChainで学ぶ検索拡張生成(RAG)

エンベディングとは

文がエンベディングモデルに入力される。

LangChainで学ぶ検索拡張生成(RAG)

エンベディングとは

エンベディングモデルは、テキストを数値ベクトルに変換する。

LangChainで学ぶ検索拡張生成(RAG)

エンベディングとは

エンベディングとは

LangChainで学ぶ検索拡張生成(RAG)

エンベディングとは

エンベディングとは

LangChainで学ぶ検索拡張生成(RAG)

チャンクのエンベディングと保存

  • OpenAIでエンベディング、ChromaDBで保存
from langchain_openai import OpenAIEmbeddings
from langchain_chroma import Chroma

embedding_model = OpenAIEmbeddings(
    api_key=openai_api_key,
    model="text-embedding-3-small"
)


vector_store = Chroma.from_documents( documents=chunks, embedding=embedding_model )
LangChainで学ぶ検索拡張生成(RAG)

お疲れさまでした!

LangChainで学ぶ検索拡張生成(RAG)

Preparing Video For Download...