PySparkで学ぶBig Data入門
Upendra Devisetty
Science Analyst, CyVerse
Resilient Distributed Datasets
Resilient: 障害に耐える能力
Distributed: 複数マシンに分散
Datasets: 分割されたデータの集合(配列、表、タプル など)
既存のオブジェクト集合を並列化
外部データセット:
HDFS 上のファイル
Amazon S3 バケット内のオブジェクト
テキストファイルの各行
既存の RDD から作成
parallelize()
numRDD = sc.parallelize([1,2,3,4])
helloRDD = sc.parallelize("Hello world")
type(helloRDD)
<class 'pyspark.rdd.PipelinedRDD'>
textFile()
fileRDD = sc.textFile("README.md")
type(fileRDD)
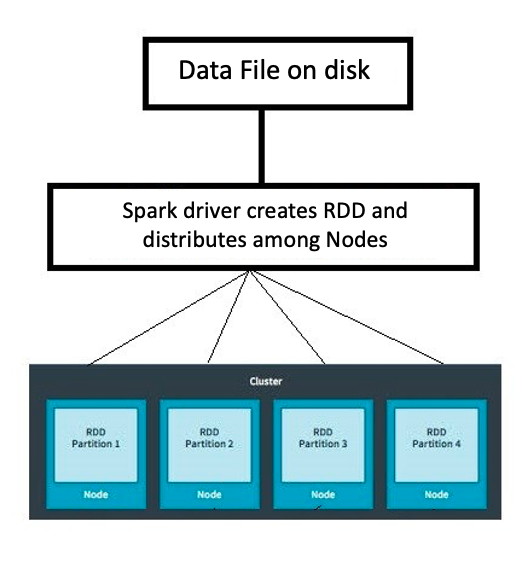
パーティションは大規模分散データセットの論理的分割です
parallelize() メソッド
numRDD = sc.parallelize(range(10), minPartitions = 6)
fileRDD = sc.textFile("README.md", minPartitions = 6)
getNumPartitions()