PySpark の RDD 操作
PySparkで学ぶBig Data入門

Upendra Devisetty
Science Analyst, CyVerse
PySpark 操作の概要
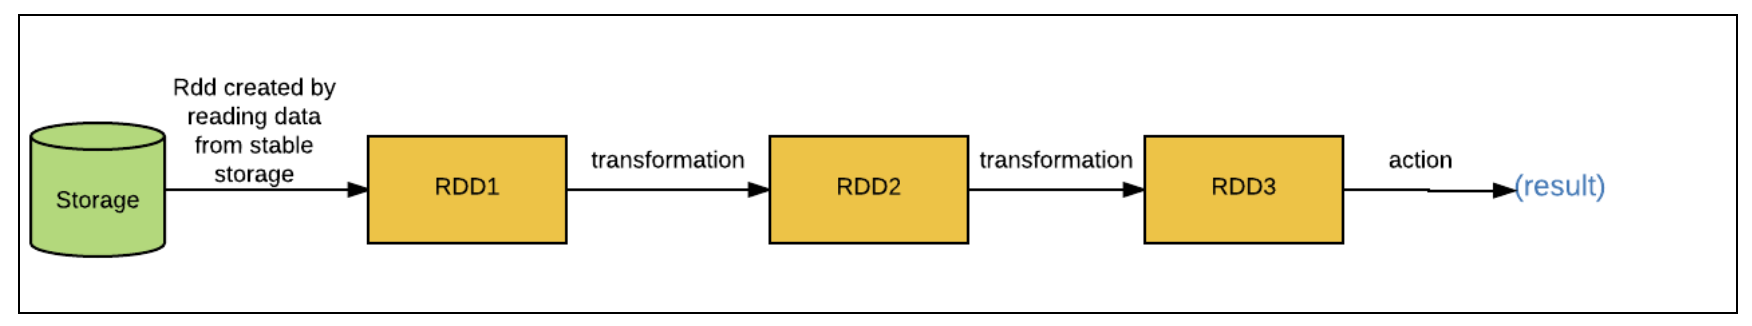
- 変換は新しい RDD を作成します
- アクションは RDD 上で計算を実行します
RDD 変換
- 変換は遅延評価に従います
基本的な RDD 変換
map(),filter(),flatMap(),union()
map() 変換
- map() は RDD の全要素に関数を適用します
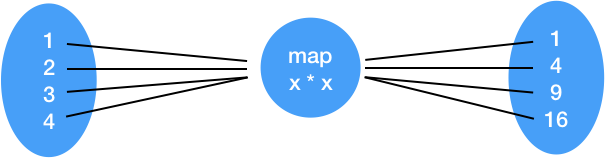
RDD = sc.parallelize([1,2,3,4])
RDD_map = RDD.map(lambda x: x * x)
filter() 変換
- filter 変換は条件を満たす要素だけの新しい RDD を返します
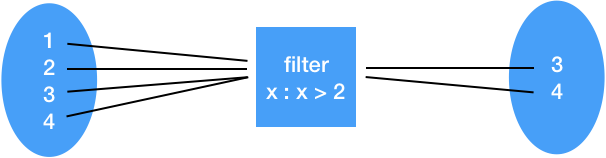
RDD = sc.parallelize([1,2,3,4])
RDD_filter = RDD.filter(lambda x: x > 2)
flatMap() 変換
- flatMap() は各要素から複数の値を返します
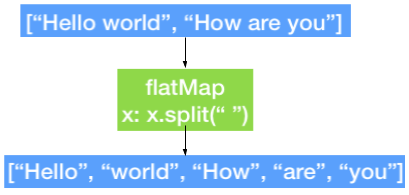
RDD = sc.parallelize(["hello world", "how are you"])
RDD_flatmap = RDD.flatMap(lambda x: x.split(" "))
union() 変換
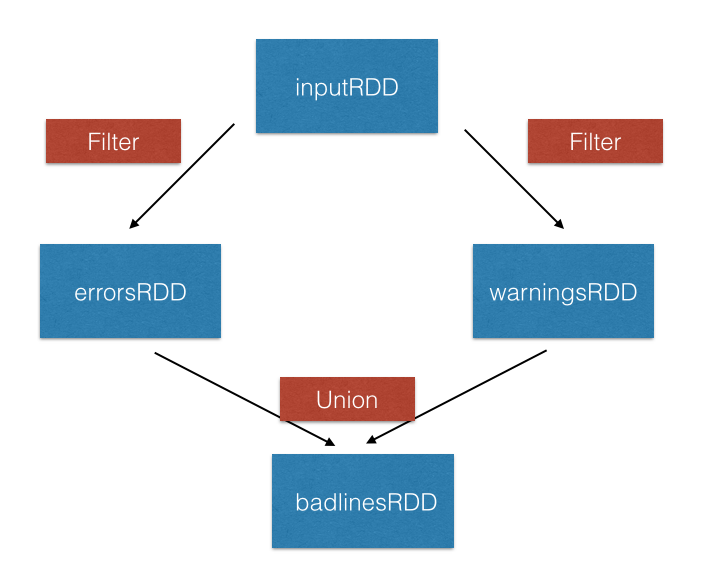
inputRDD = sc.textFile("logs.txt")
errorRDD = inputRDD.filter(lambda x: "error" in x.split())
warningsRDD = inputRDD.filter(lambda x: "warnings" in x.split())
combinedRDD = errorRDD.union(warningsRDD)

