PySparkで学ぶBig Data入門
Upendra Devisetty
Science Analyst, CyVerse
量、種類、速度
量 (Volume): データの大きさ
種類 (Variety): さまざまなソースと形式
速度 (Velocity): データの発生・処理速度
クラスター計算: 複数マシンのリソースを集約
並列計算: 単一マシン上で同時実行
分散計算: ネットワーク化ノードで並列実行
バッチ処理: 作業を小さく分割し各マシンで実行
リアルタイム処理: 即時に処理
Hadoop/MapReduce: Java製のスケーラブルで耐障害性のあるフレームワーク
オープンソース
バッチ処理
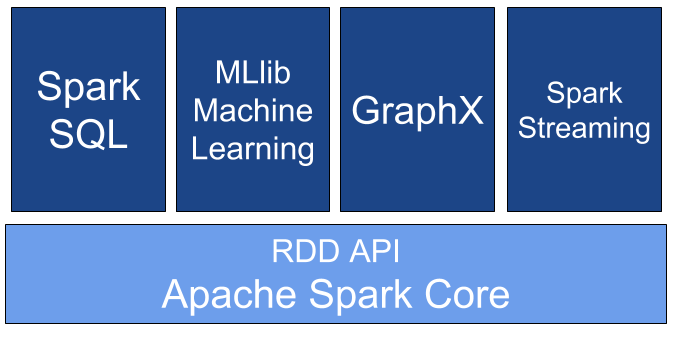
Apache Spark: 汎用で超高速なクラスター計算基盤
バッチとリアルタイムの両方に対応
注: 現在は Apache Spark の方が Hadoop/MapReduce より一般的
分散クラスター計算フレームワーク
大規模データをメモリ内で効率計算
超高速なデータ処理基盤
Java、Scala、Python、R、SQL をサポート
ローカルモード: ノートPCなど1台のマシン
クラスターモード: あらかじめ用意された複数マシン
ワークフロー: ローカル -> クラスター
コード変更は不要