RAG対ファインチューニング

LLMOps の概念

Max Knobbout, PhD

Applied Scientist, Uber

LLMのライフサイクル RAG対ファインチューニング
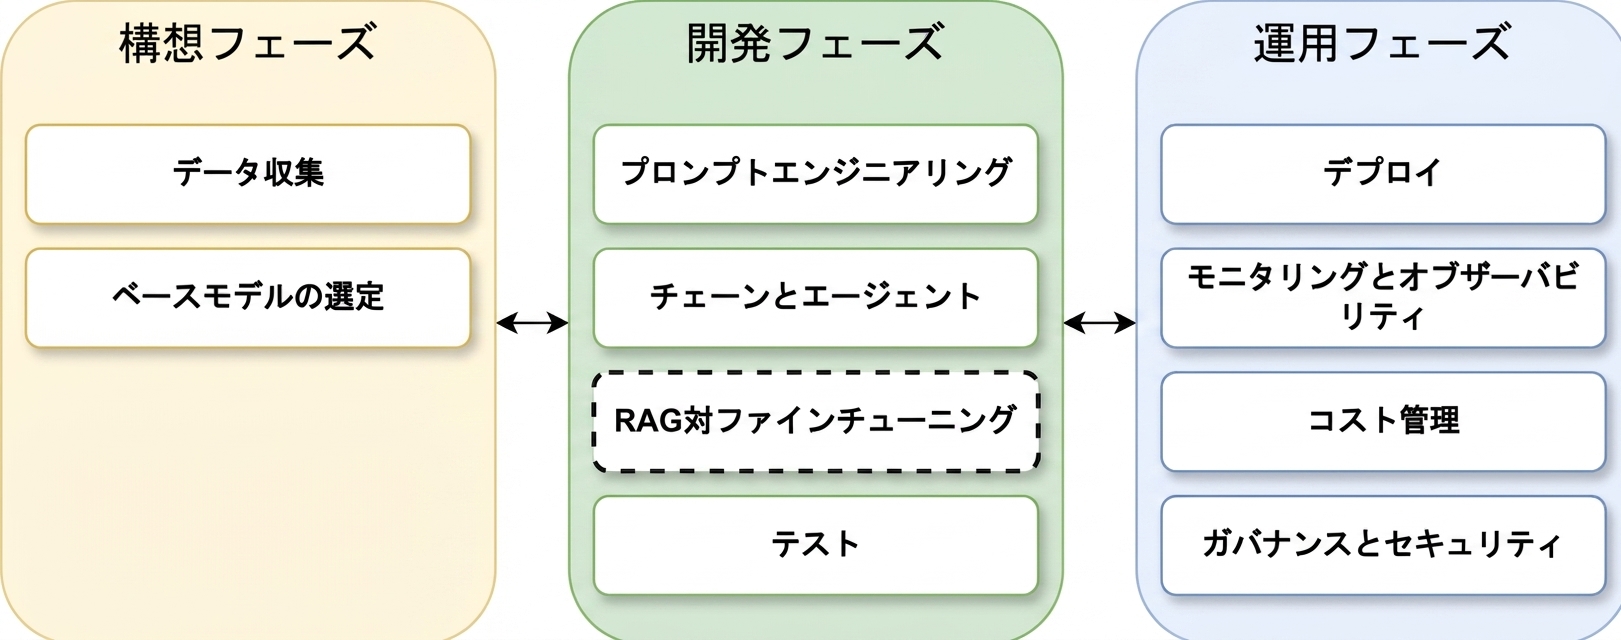
LLMアプリケーションのライフサイクル各フェーズの概要

LLMOps の概念

検索拡張生成(RAG)

バナナを使ってタブレットを動かす遊び心のあるイラスト

  • LLMの推論能力と外部知識を組み合わせること。
  • 連鎖状の3つのステップ:

    1. 関連文書を取得
    2. 例を追加してプロンプトを補強する
    3. 生成出力
  • ベクトルデータベースを使用して実装されることが多いです。

LLMOps の概念

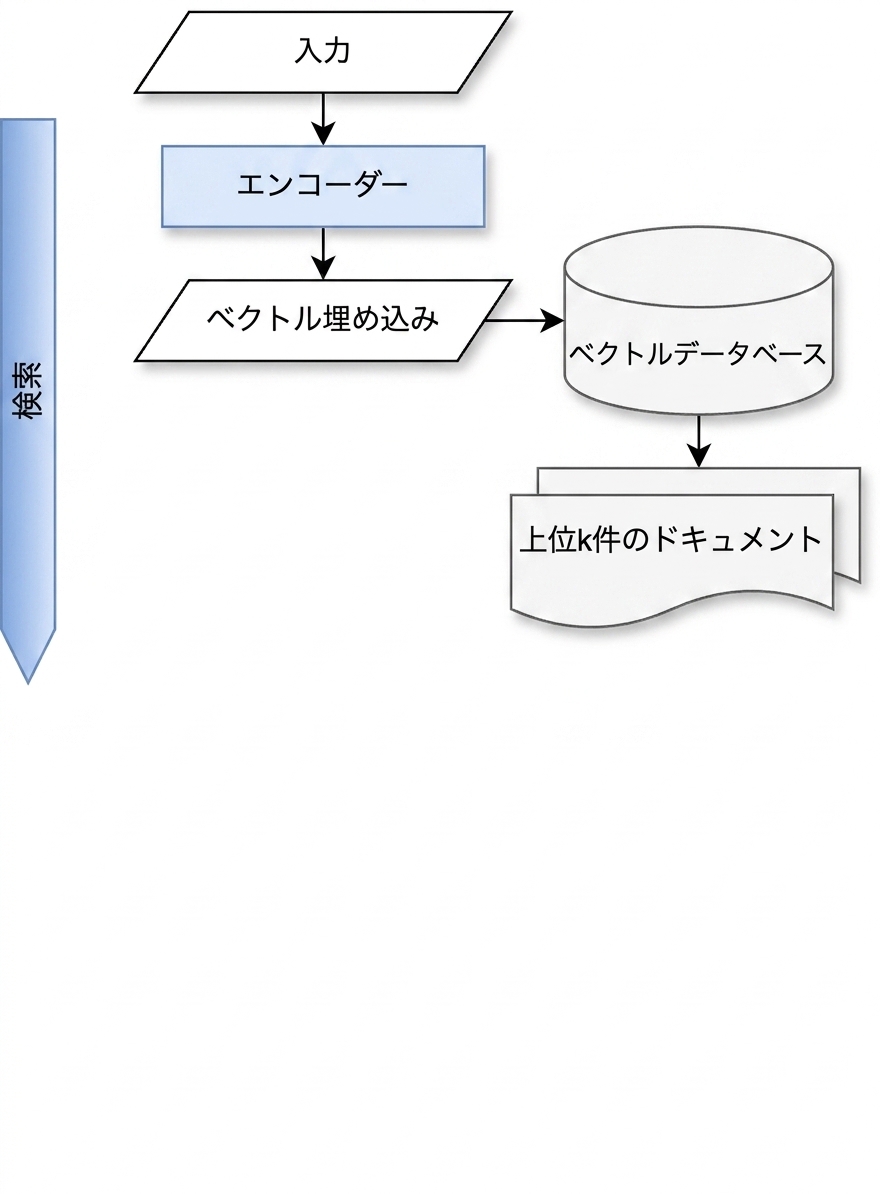
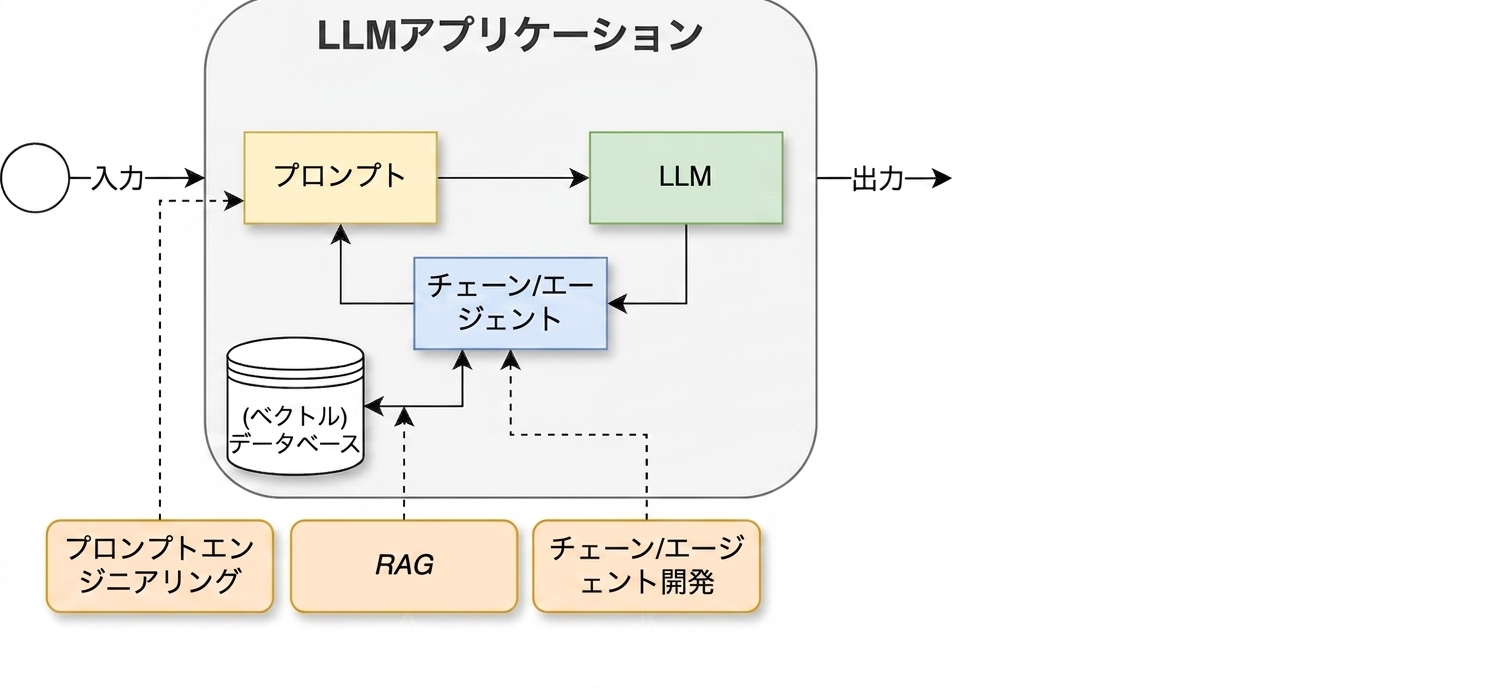
ベクトルデータベースを用いたRAGチェーン

  1. 取得:
    • 入力を埋め込みに変換
    • ベクトルデータベースを検索
    • 最も類似したドキュメントを取得する

取得チェーン

LLMOps の概念

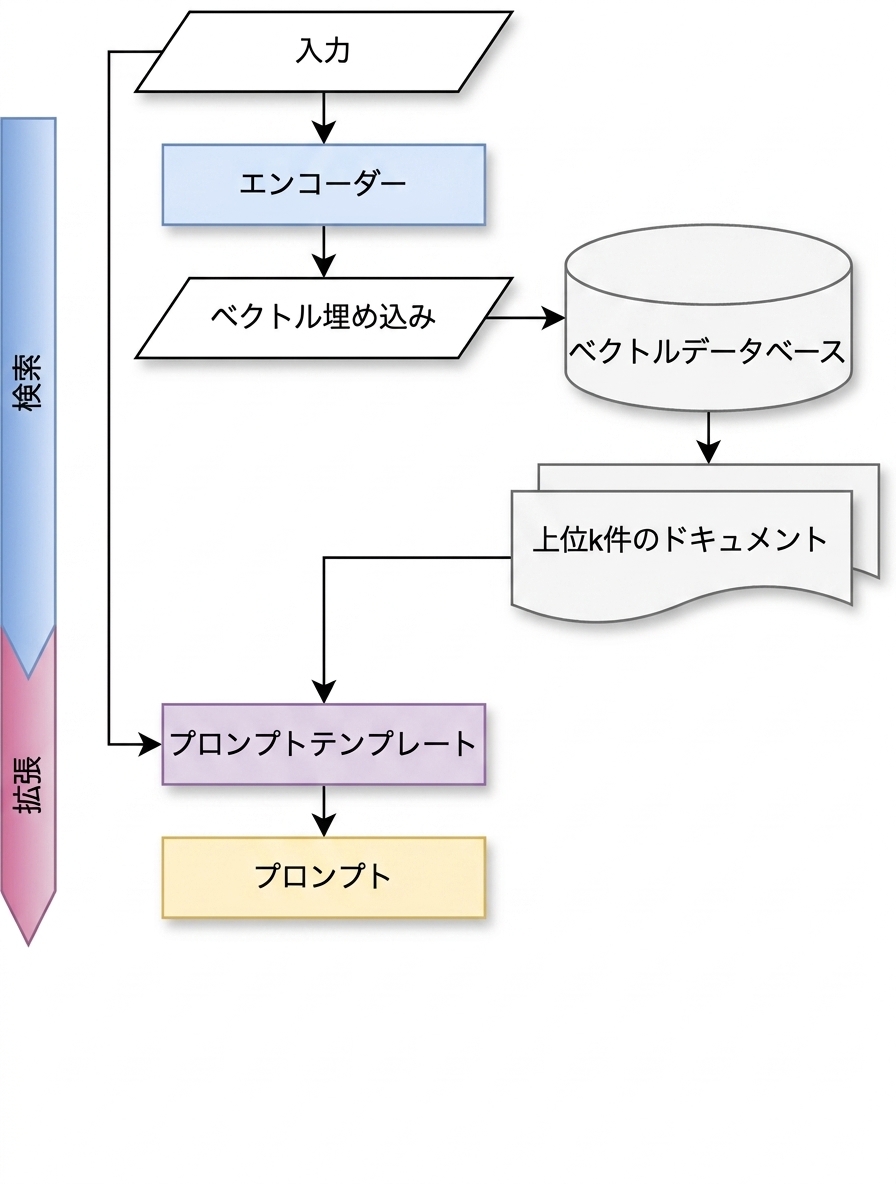
ベクトルデータベースを用いたRAGチェーン

  1. 取得:
    • 入力からエンベディングを生成する
    • ベクトルデータベースを検索
    • 最も類似したドキュメントを取得する
  2. 拡張:
    • 入力をドキュメントと組み合わせて最終的なプロンプトを作成

拡張チェーン

LLMOps の概念

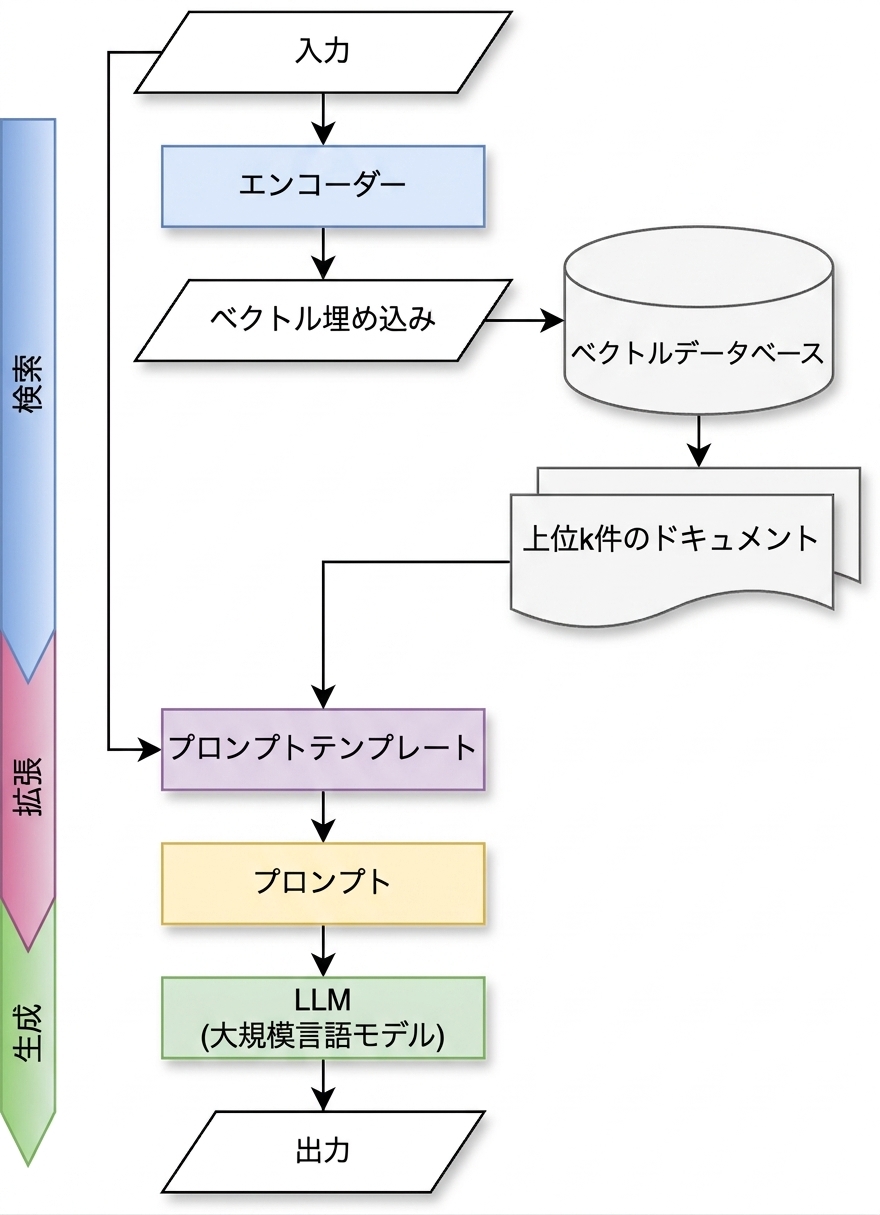
ベクトルデータベースを用いたRAGチェーン

  1. 取得:
    • 入力からエンベディングを生成する
    • ベクトルデータベースを検索
    • 最も類似したドキュメントを取得する
  2. 拡張:
    • 入力をトップkドキュメントと組み合わせ、拡張プロンプトを作成する
  3. 生成:
    • プロンプトを使用して出力を作成する

多くの実装選択肢と埋め込みモデル。実験してテストしてください!

チェーンを生成

LLMOps の概念

ファインチューニング(Fine-tuning)

細かく仕立てられたスーツを着たカートゥーンの遊び心ある画像

  • LLMの重みを調整する
  • 特定のタスクとドメインに拡張する:
    • 異なる言語
    • 特殊フィールド
LLMOps の概念

ファインチューニング(Fine-tuning)

教師ありファインチューニング (転移学習)

必要なデータの種類 📂:

  • デモ用データ(入力と期待される出力)

人間のフィードバックによる強化学習(RLHF)

必要なデータの種類 📂:

  • ランキングまたは品質スコア(いいね・よくないねに基づく)

アプローチ 🔍:

  • モデルの(一部の)再学習を行う

アプローチ 🔍:

  • 追加の報酬モデルを訓練する
  • オリジナルLLMを最適化してこれを最大化する
LLMOps の概念

RAGまたはファインチューニング

RAG
  • 事実知識を使用する場合
  • ✅ LLMの機能を維持し、実装が容易で、常に最新の状態を保てます
  • ❌ 追加のコンポーネントを加え、慎重なエンジニアリングを必要とする

バナナを使ってタブレットに電力を供給する遊び心のある漫画

遊び心のある、仕立て直しされたスーツを着た漫画の画像

ファインチューニング
  • 新しいドメインに特化する際に使用
  • ✅ 完全に制御でき、追加のコンポーネントはありません
  • ❌ ラベル付きデータと専門知識が必要、バイアス増幅、破滅的忘却
LLMOps の概念

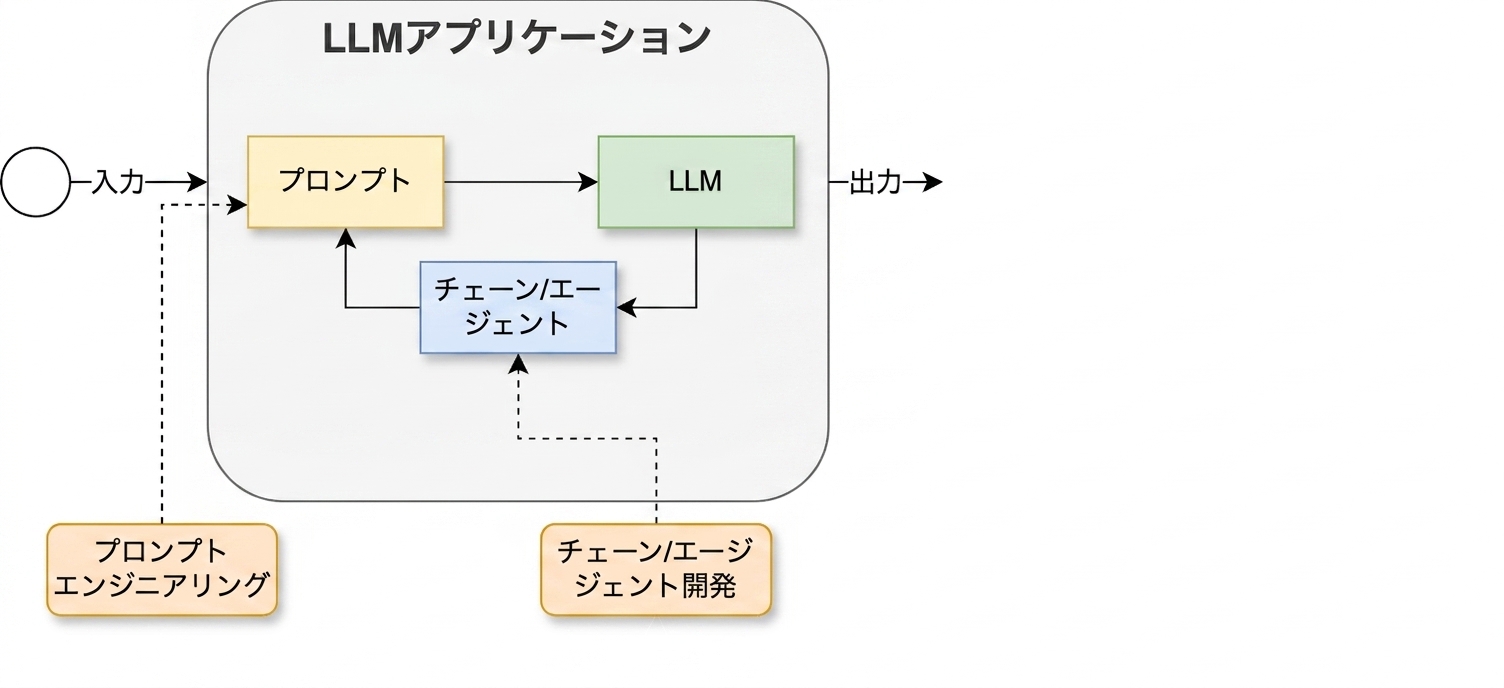
開発サイクル

チェーンとエージェント開発のアクティビティを追加した開発サイクル

LLMOps の概念

開発サイクル

RAGのアクティビティを追加した開発サイクル

LLMOps の概念

開発サイクル

ファインチューニングのアクティビティを追加した開発サイクル

LLMOps の概念

練習しましょう!

LLMOps の概念

Preparing Video For Download...