statsmodels を使った中級 Regression
Maarten Van den Broeck
Content Developer at DataCamp
シンプソンのパラドックスとは、データセット全体でのモデルの傾向が、部分集合ごとのモデルの傾向と大きく異なる現象です。
傾向 = 傾き係数
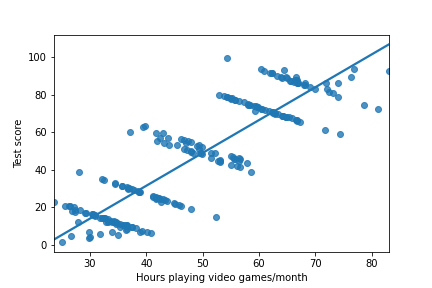
mdl_whole = ols("y ~ x",
                 data=simpsons_paradox).fit()

print(mdl_whole.params)
Intercept           -38.554
x                     1.751
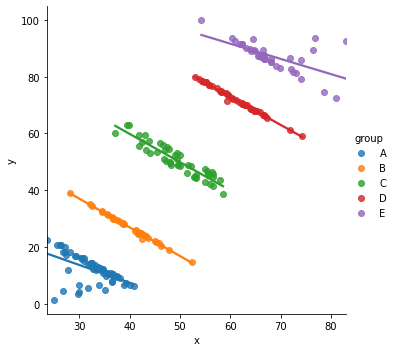
mdl_by_group = ols("y ~ group + group:x + 0",
                   data = simpsons_paradox).fit()

print(mdl_by_group.params)
  groupA    groupB    groupC    groupD    groupE
 32.5051   67.3886   99.6333  132.3932  123.8242
groupA:x  groupB:x  groupC:x  groupD:x  groupE:x
 -0.6266   -1.0105   -0.9940   -0.9908   -0.5364
sns.regplot(x="x",
            y="y",
            data=simpsons_paradox,
            ci=None)
sns.lmplot(x="x",
           y="y",
           data=simpsons_paradox,
           hue="group",
           ci=None)
可能であれば、データセットをプロットしてみましょう。
最適なモデルは一般的に一つに決まりません–それはデータセットや、答えようとしている問いによって異なります。
モデリングを始める前に、問いを明確にしましょう。