Machine Learning with PySpark
Andrew Collier
Data Scientist, Fathom Data
cars.select('mass', 'cyl', 'consumption').show(5)
+------+---+-----------+
|  mass|cyl|consumption|
+------+---+-----------+
|1451.0|  6|       9.05|
|1129.0|  4|       6.53|
|1399.0|  4|       7.84|
|1147.0|  4|       7.84|
|1111.0|  4|       9.05|
+------+---+-----------+
モデルを構築するオブジェクト。パイプラインでも可。
regression = LinearRegression(labelCol='consumption')
モデル性能を評価するオブジェクト。
evaluator = RegressionEvaluator(labelCol='consumption')
from pyspark.ml.tuning import CrossValidator, ParamGridBuilder
パラメータ値のグリッド(ここでは空)。
params = ParamGridBuilder().build()
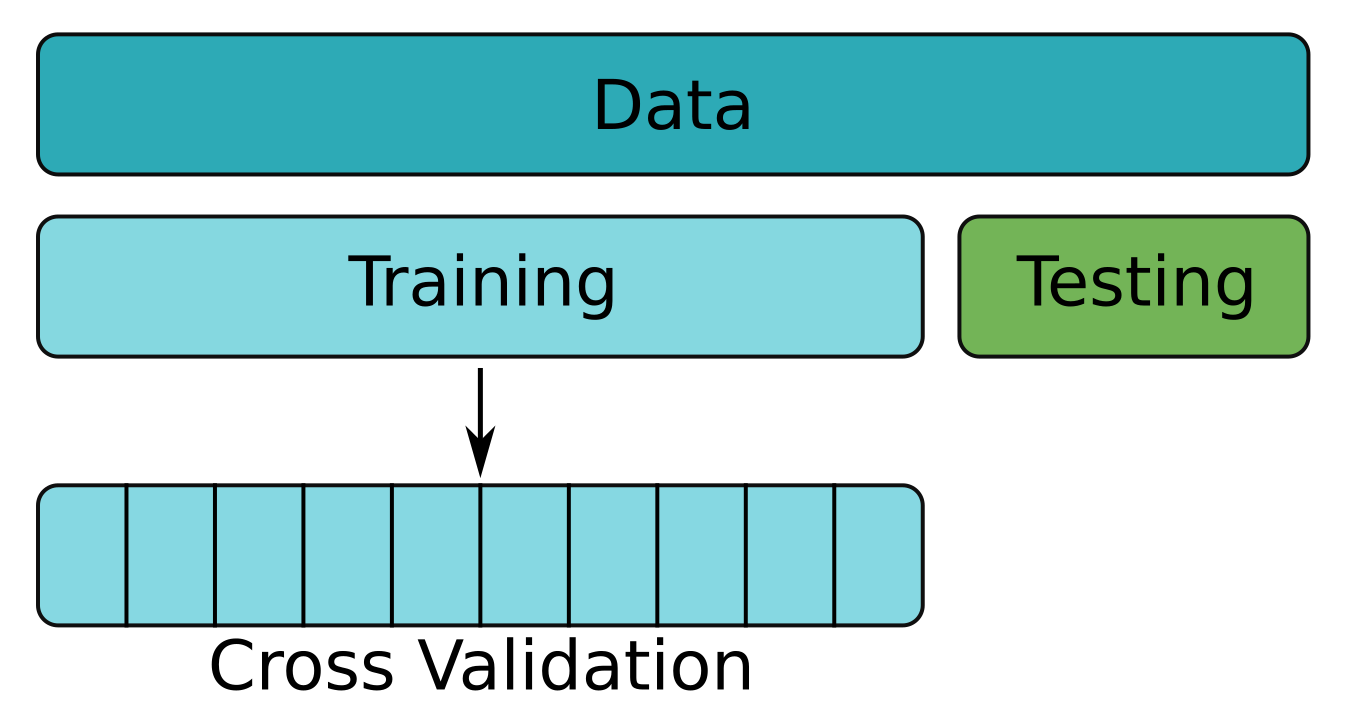
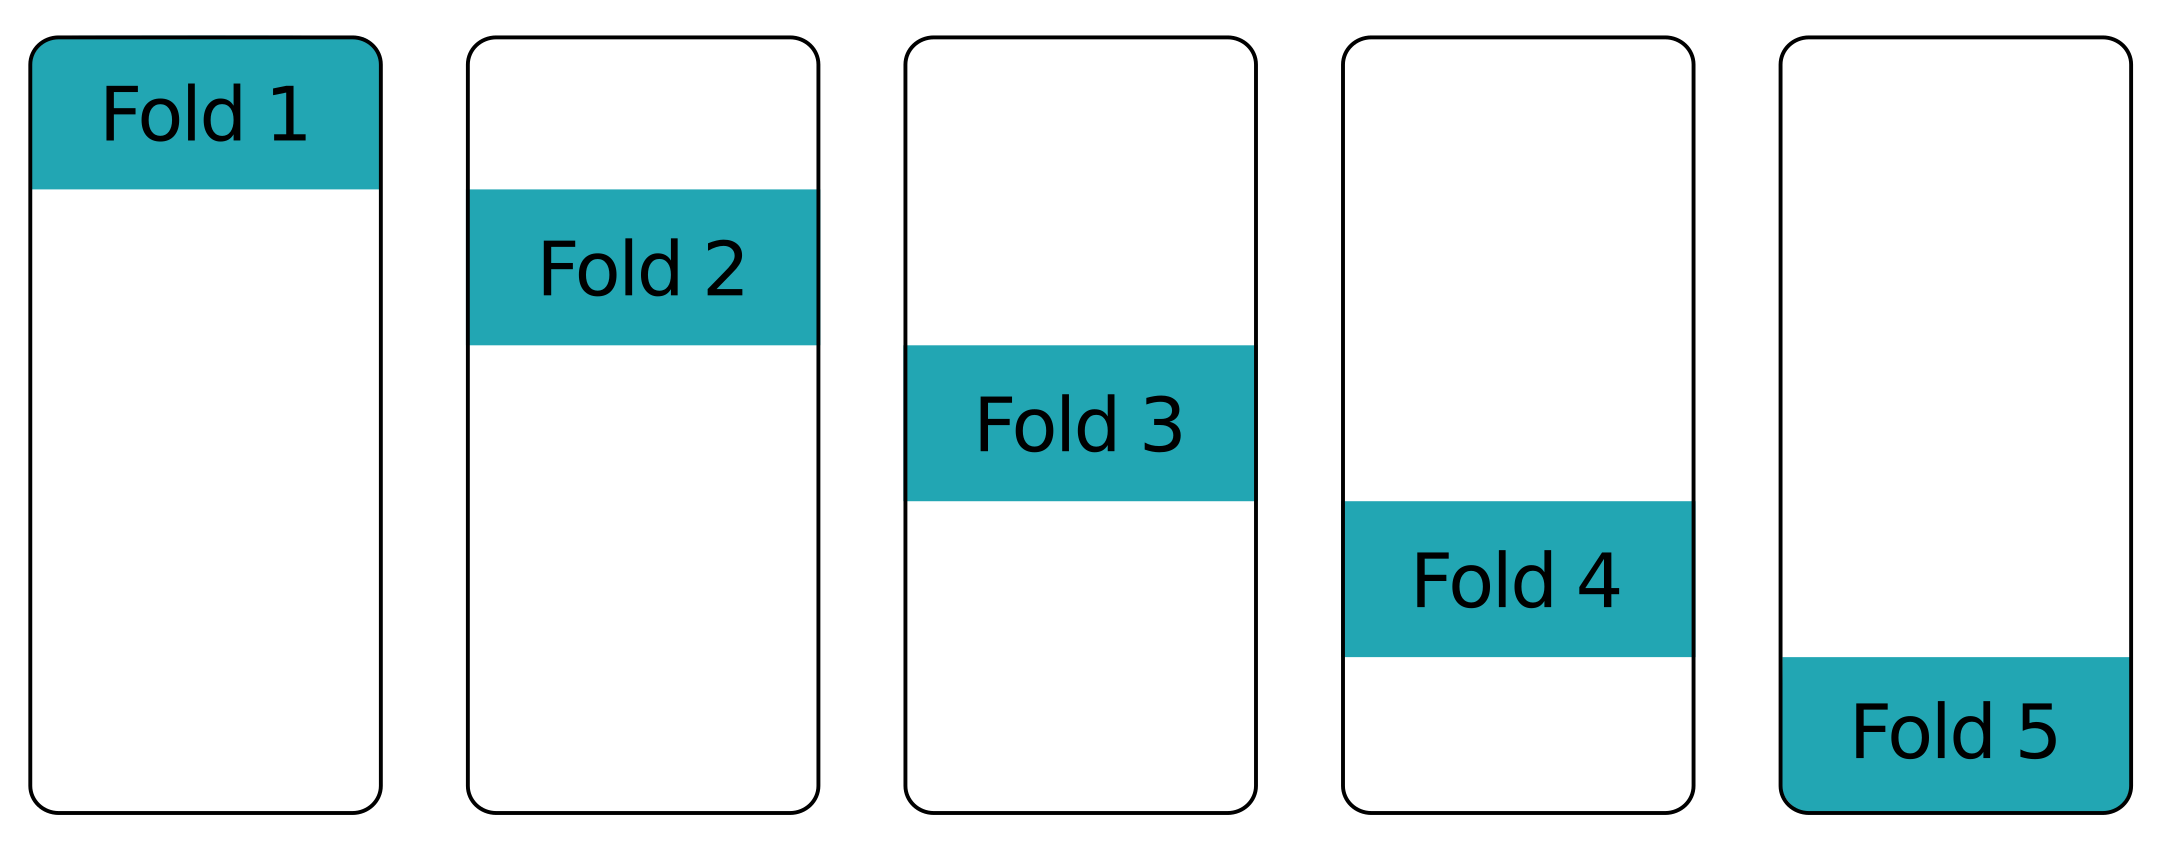
交差検証オブジェクト。
cv = CrossValidator(estimator=regression,
                    estimatorParamMaps=params,
                    evaluator=evaluator,
                    numFolds=10, seed=13)
学習データに交差検証を適用します。
cv = cv.fit(cars_train)
フォールド平均のRMSEは?
cv.avgMetrics
[0.800663722151572]
元のテストデータで予測します。
evaluator.evaluate(cv.transform(cars_test))
# テストデータのRMSE
0.745974203928479
交差検証のRMSEよりもかなり小さい。
# 交差検証のRMSE
0.800663722151572
単純な学習・テスト分割だけだと、性能を楽観的に見積もるおそれがあります。