Pythonでのハイパーパラメータチューニング
Alex Scriven
Data Scientist
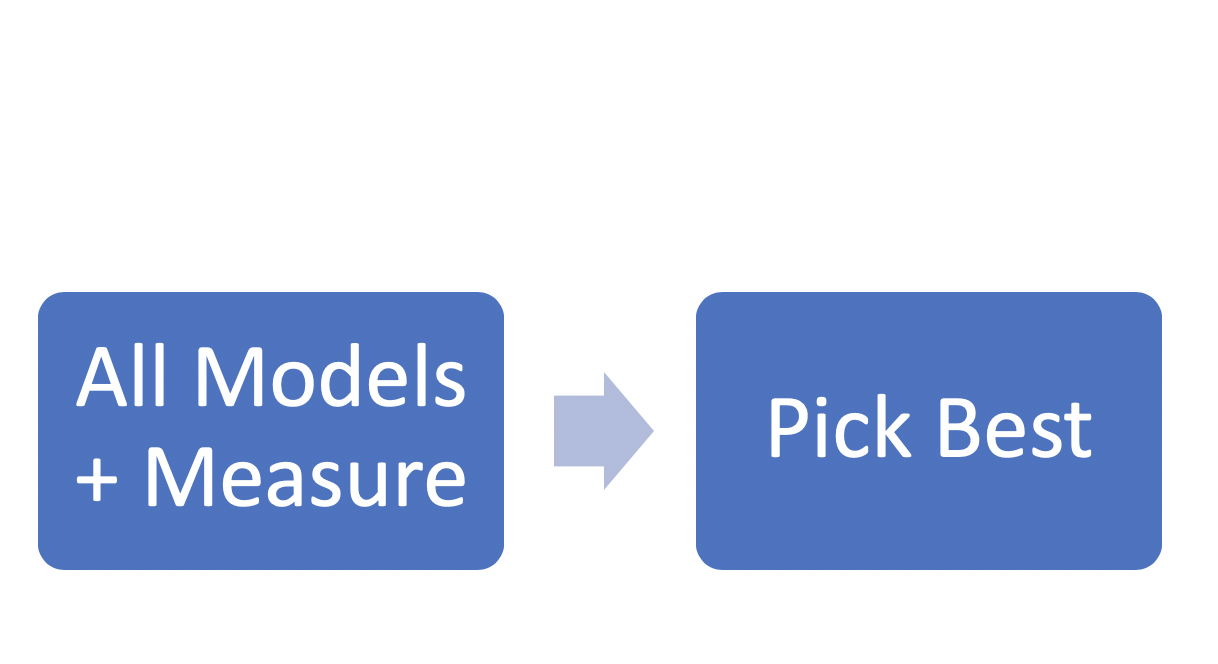
これまで行ったのはすべて非情報探索です。
非情報探索:ハイパーパラメータ調整の各反復が、前回の結果から学習しないこと。
これにより並列化できますが、効率的とは言えません。
ここまでの流れ:

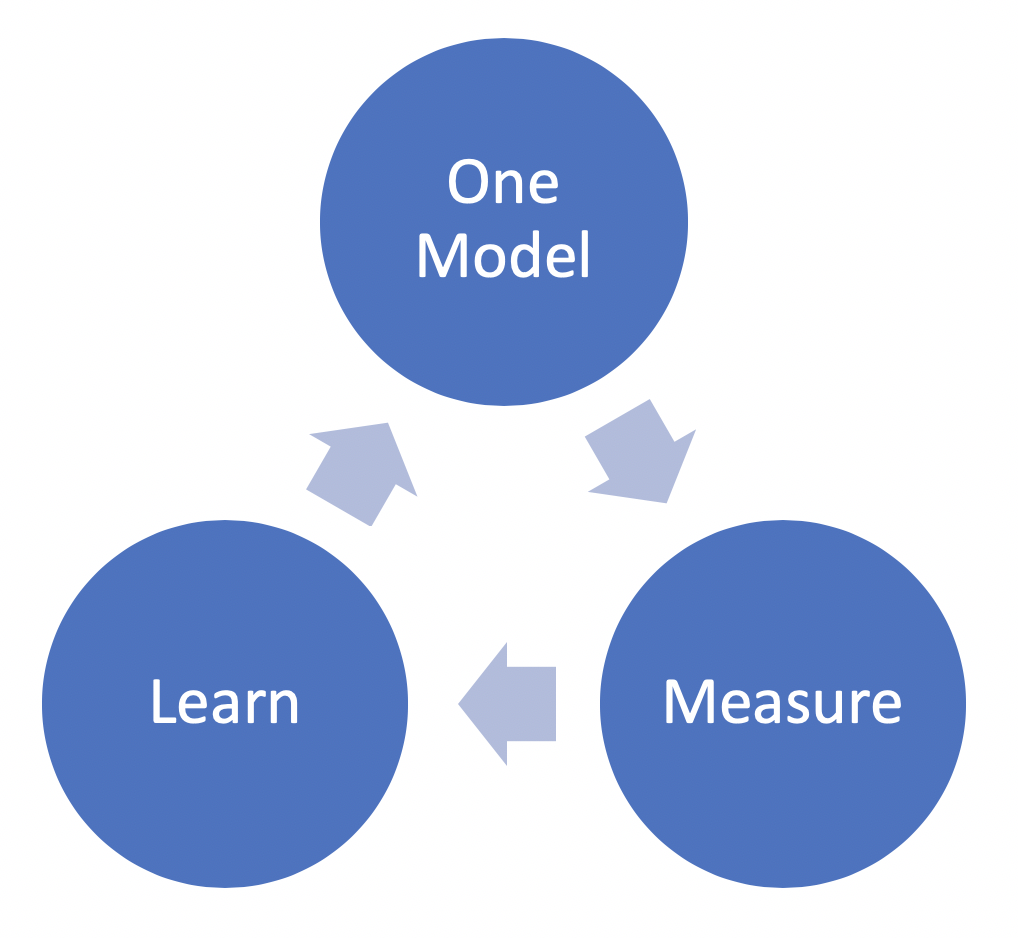
別の方法:

基本的な情報探索の方法:
最初は粗くランダムに進め、反復的に範囲を絞ります。
手順:
(3)の前にランダムサーチを追加しても構いません。
粗から細のチューニングの利点:
成果の出ない探索空間に時間を浪費しません。
注:単一モデルではなくバッチ単位での情報活用です。
次のハイパーパラメータ範囲を例にします。
max_depth_list 1〜65min_sample_list 3〜17learn_rate_list 0.01〜150の間で150個の値可能なモデルは何通りでしょうか。
combinations_list = [list(x) for x in product(max_depth_list, min_sample_list, learn_rate_list)]
print(len(combinations_list))
134400
まずは500通りだけランダムサーチします。
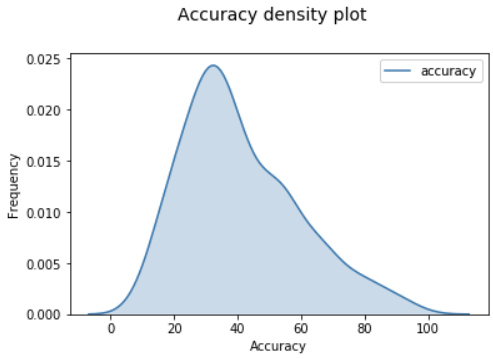
精度スコアを可視化します。

良いモデルはどれでしょうか。
上位結果:
| max_depth | min_samples_leaf | learn_rate | accuracy |
|---|---|---|---|
| 10 | 7 | 0.01 | 96 |
| 19 | 7 | 0.023355705 | 96 |
| 30 | 6 | 1.038389262 | 93 |
| 27 | 7 | 1.11852349 | 91 |
| 16 | 7 | 0.597651007 | 91 |
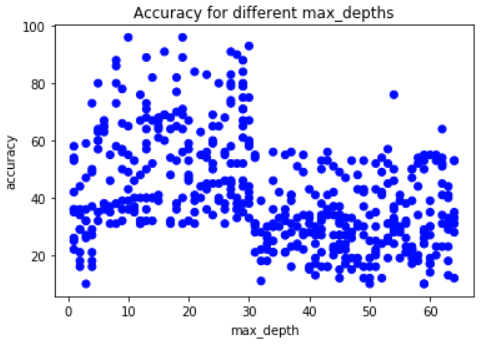
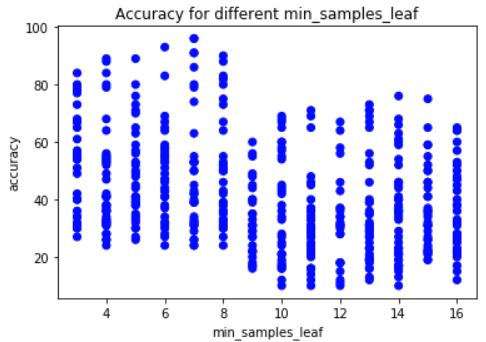
max_depth と精度の関係を可視化します。

min_samples_leaf は8未満が良好

learn_rate は1.3超で悪化
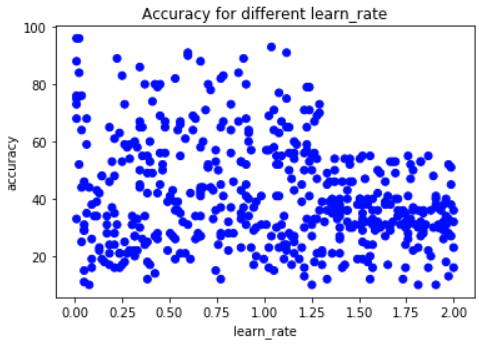
1回目で分かったこと:
max_depth は8〜30learn_rate は1.3未満min_samples_leaf は8未満が良さそう次は? 得られた知見でランダムまたはグリッドサーチを再実行。
注意:これは二変量の分析のみです。1枚のグラフで3つ以上のハイパーパラメータも可視化できますが、本コースの範囲外です。
Pythonでのハイパーパラメータチューニング