Pythonでのハイパーパラメータチューニング
Alex Scriven
Data Scientist
グリッドサーチとよく似ています:
ただし ランダムに グリッドのマスを選びます。
Bengio & Bergstra (2012):
本論文は、理論と実証の両面から、ハイパーパラメータ最適化ではランダム試行がグリッドより効率的であることを示す。
主な理由は2つ:
グリッドサーチ:

緑のマスに当たる確率を95%にするには、何モデル試す必要がある?
ベストなモデル:
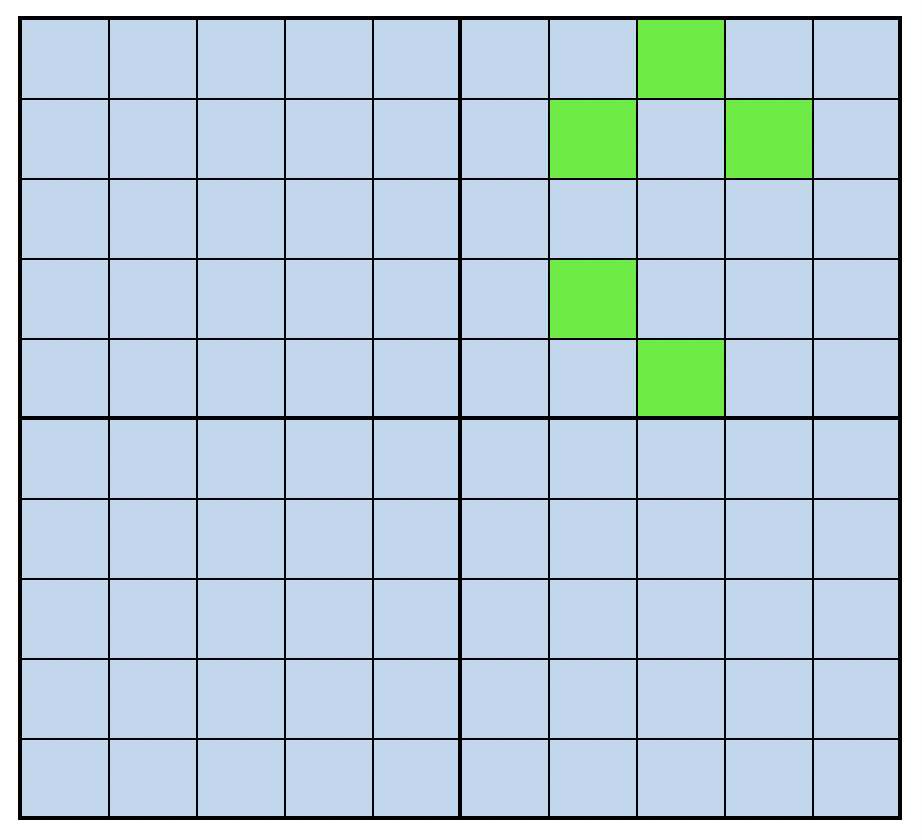
ハイパーパラメータを一様にランダム抽出するとき、すべての試行で外す確率を考えて、その起こりにくさを示します。
試行1 = 成功0.05、外すのは (1 - 0.05)。
一般に、n 回の試行で望む点をすべて外す確率は (1-0.05)^n。
その領域に入る確率を高く(95%)するには試行回数はいくつ必要?
どういう意味か?
注意:
最大値は設定したグリッドの質に依存します。
グリッドサーチと公平に比較するには、同じモデリング「予算」を使うこと。
ハイパーパラメータの組合せからランダム標本を自作できます:
# Set some hyperparameter lists
learn_rate_list = np.linspace(0.001,2,150)
min_samples_leaf_list = list(range(1,51))
# Create list of combinations
from itertools import product
combinations_list = [list(x) for x in
product(learn_rate_list, min_samples_leaf_list)]
# Select 100 models from our larger set
random_combinations_index = np.random.choice(
range(0,len(combinations_list)), 100,
replace=False)
combinations_random_chosen = [combinations_list[x] for x in
random_combinations_index]
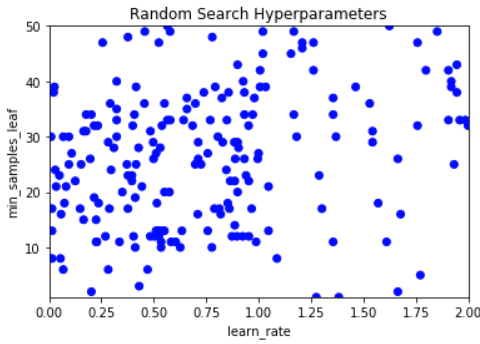
X・Y軸にハイパーパラメータを取り、ランダムサーチの被覆も可視化できます。

散布は広いが、密な被覆はない点に注目。
Pythonでのハイパーパラメータチューニング