Pythonでのハイパーパラメータチューニング
Alex Scriven
Data Scientist
GridSearchCV の出力を分析します。
GridSearchCV のプロパティは3グループに分かれます:
cv_results_best_index_, best_params_, best_score_scorer_, n_splits_, refit_time_
プロパティはドット記法で参照します。
例:
grid_search_object.property
property には取得したいプロパティ名を指定します。
cv_results_ プロパティ:
DataFrame に読み込んで表示・分析します。
cv_results_df = pd.DataFrame(grid_rf_class.cv_results_)
print(cv_results_df.shape)
(12, 23)
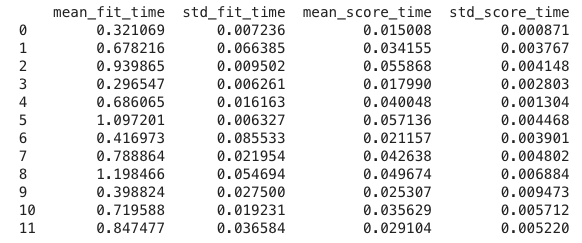
time 列は、モデルの学習(と採点)に要した時間を示します。
5 分割の交差検証では 5 回実行し、平均と標準偏差(秒)を保存します。
param_ 列は、その行で試した各パラメータを保持します(パラメータごとに1列)。
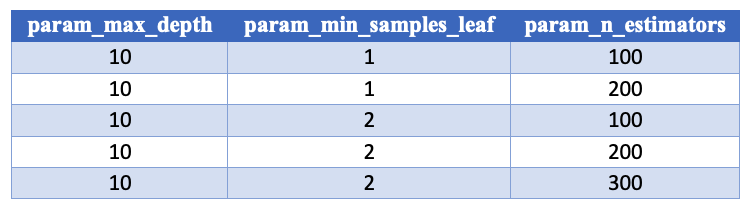
params 列には、すべてのパラメータの辞書が入ります:
pd.set_option("display.max_colwidth", -1)
print(cv_results_df.loc[:, "params"])
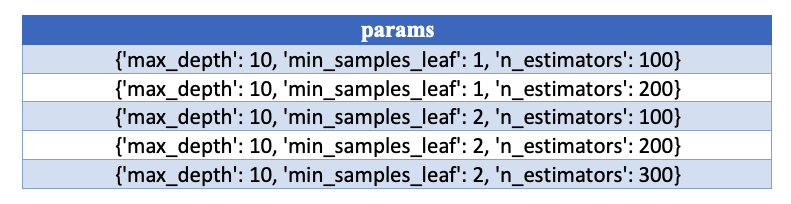
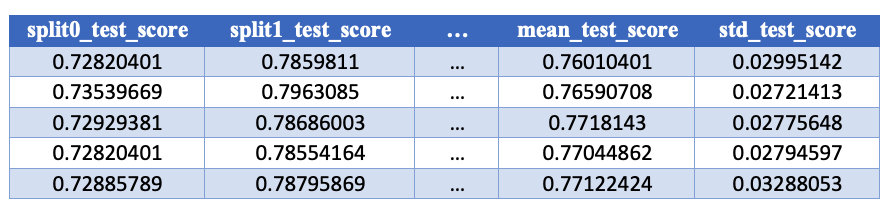
test_score 列群には、各分割のテストスコアと要約統計が入ります:

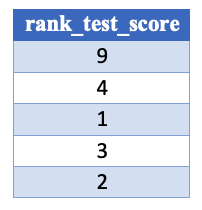
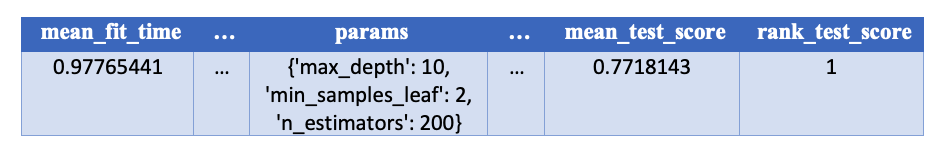
rank 列は mean_test_score を良い順に並べます:

rank_test_score 列を使えば、cv_results_ から最良のグリッドを簡単に取得できます。
best_row = cv_results_df[cv_results_df["rank_test_score"] == 1]
print(best_row)
その後、test_score 列群は training_scores に対しても繰り返されます。
注意点:
訓練スコア列を含めるには return_train_score を True にする必要があります。
訓練スコアには順位付け列はありません。重視するのはテスト性能だからです。
最良のグリッドについては、次の3つで要約されます。
best_params_: 最高スコアを出したパラメータ辞書。
best_score_: その最高スコア。
best_index_: cv_results_.rank_test_score の最良行のインデックス。
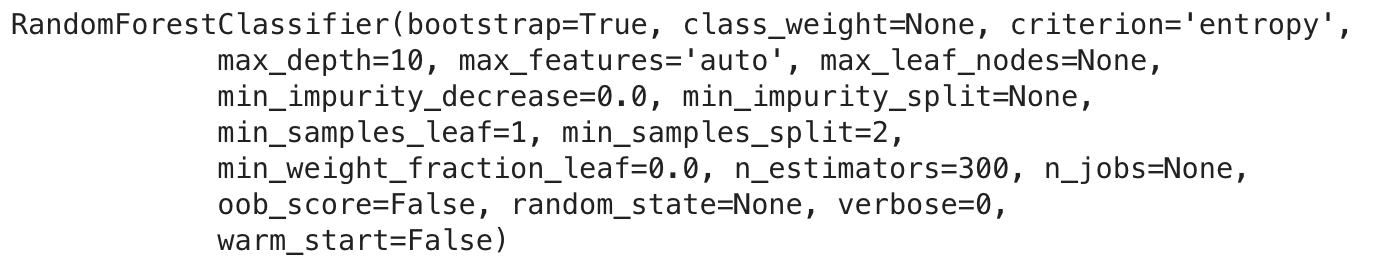
best_estimator_ は、最良パラメータで学習した推定器です。
ここでは Random Forest 推定器です:
type(grid_rf_class.best_estimator_)
sklearn.ensemble.forest.RandomForestClassifier
このオブジェクトをそのまま推定器として使うこともできます。
print(grid_rf_class.best_estimator_)

次のプロパティに追加情報があります:
scorer_保持アウトデータに使った評価関数。(ここでは AUC)
n_splits_交差検証の分割数。(ここでは 5)
refit_time_全データで最良モデルを再学習するのに要した秒数。
Pythonでのハイパーパラメータチューニング