ハイパーパラメータの値

Pythonでのハイパーパラメータチューニング

Alex Scriven

Data Scientist

ハイパーパラメータの値


まず調整すべき重要なハイパーパラメータがあります。

では、どの“値”を試すべきでしょうか?

  • アルゴリズムやハイパーパラメータごとに異なる
  • ベストプラクティスやヒントはある程度存在

主要なヒントを見ていきましょう。

Pythonでのハイパーパラメータチューニング

競合するハイパーパラメータ選択

競合するハイパーパラメータ設定に注意します。

  • LogisticRegression() の solver と penalty には競合する組合せがあります。
The 'newton-cg', 'sag' and 'lbfgs' solvers support only l2 penalties.

明示されずに「無視」される場合もあります(ElasticNet の normalize など):

This parameter is ignored when fit_intercept is set to False

必ず Scikit-learn のドキュメントを確認しましょう。

Pythonでのハイパーパラメータチューニング

不適切なハイパーパラメータ値


“妙な”値の設定に注意しましょう:

  • 木の本数が極端に少ないランダムフォレスト
    • 木が2本で「フォレスト」と言えますか?
  • KNN の近傍数が 1
    • 1人の「投票」だけの平均は頑健ではありません。
  • 極小の増分でハイパーパラメータを増やす

妥当な範囲を文書化しておくことは有益です。

Pythonでのハイパーパラメータチューニング

ハイパーパラメータ選択の自動化


前の演習では次のようにモデルを作成しました:

knn_5 =  KNeighborsClassifier(n_neighbors=5)
knn_10 = KNeighborsClassifier(n_neighbors=10)
knn_20  = KNeighborsClassifier(n_neighbors=20)

これは非効率です。改良できるでしょうか。

Pythonでのハイパーパラメータチューニング

ハイパーパラメータ調整の自動化

for ループで候補を反復します:

neighbors_list = [3,5,10,20,50,75]

accuracy_list = []
for test_number in neighbors_list: model = KNeighborsClassifier(n_neighbors=test_number) predictions = model.fit(X_train, y_train).predict(X_test)
accuracy = accuracy_score(y_test, predictions) accuracy_list.append(accuracy)
Pythonでのハイパーパラメータチューニング

ハイパーパラメータ調整の自動化

結果を表示用にDataFrameへ保存します:

results_df = pd.DataFrame({'neighbors':neighbors_list, 'accuracy':accuracy_list})
print(results_df)
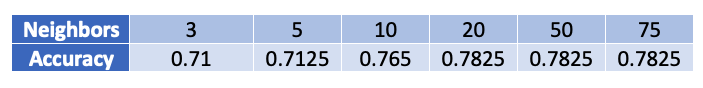
近傍数ごとの精度の表

Pythonでのハイパーパラメータチューニング

学習曲線

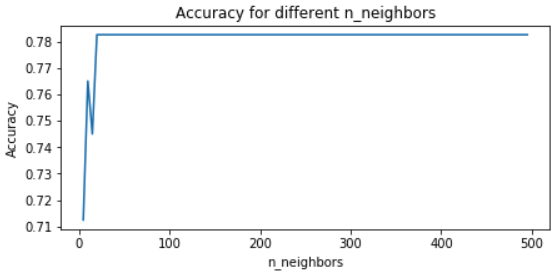
学習曲線グラフを作成しましょう

今回はさらに多くの値を試します

neighbors_list = list(range(5,500, 5))

accuracy_list = [] for test_number in neighbors_list: model = KNeighborsClassifier(n_neighbors=test_number) predictions = model.fit(X_train, y_train).predict(X_test) accuracy = accuracy_score(y_test, predictions) accuracy_list.append(accuracy) results_df = pd.DataFrame({'neighbors':neighbors_list, 'accuracy':accuracy_list})
Pythonでのハイパーパラメータチューニング

学習曲線

より大きいDataFrameをプロットします:

plt.plot(results_df['neighbors'], 
    results_df['accuracy'])

# ラベルとタイトルを追加 plt.gca().set(xlabel='n_neighbors', ylabel='Accuracy', title='Accuracy for different n_neighbors') plt.show()
Pythonでのハイパーパラメータチューニング

学習曲線

グラフ:

KNNの精度 vs 近傍数の学習曲線

Pythonでのハイパーパラメータチューニング

値生成の便利テクニック

Python の range は小数ステップに非対応です。

便利な方法として NumPy の np.linspace(start, end, num) を使います

  • 指定区間(start, end)内に等間隔の値を num 個生成します。
print(np.linspace(1,2,5))
[1.   1.25 1.5  1.75 2.  ]
Pythonでのハイパーパラメータチューニング

¡Vamos a practicar!

Pythonでのハイパーパラメータチューニング

Preparing Video For Download...