Scikit-learn のランダムサーチ
Pythonでのハイパーパラメータチューニング

Alex Scriven
Data Scientist
GridSearchCV との比較
車輪の再発明は不要です。グリッドサーチの手順を振り返りましょう:
- アルゴリズム/推定器を決める
- 調整するハイパーパラメータを決める
- 各ハイパーパラメータの値範囲を定める
- 交差検証の方法を設定
- 評価指標(スコア関数)を定義
- 追加の有用情報や関数を指定
グリッドサーチとの比較
違いは1点だけです:
- 手順7 = サンプル数を決めて(サンプリングする)
以上です(ほぼ)。
Scikit-learn モジュールの比較
モジュールもよく似ています:
GridSearchCV:
sklearn.model_selection.GridSearchCV(estimator, param_grid,
        scoring=None, fit_params=None,
        n_jobs=None,
        refit=True, cv='warn', verbose=0,
        pre_dispatch='2*n_jobs',
        error_score='raise-deprecating',
        return_train_score='warn')
RandomizedSearchCV:
sklearn.model_selection.RandomizedSearchCV(estimator,
        param_distributions, n_iter=10,
        scoring=None, fit_params=None,
        n_jobs=None, refit=True,
        cv='warn', verbose=0,
        pre_dispatch='2*n_jobs',
        random_state=None,
        error_score='raise-deprecating',
        return_train_score='warn')
主な違い
主な違いは2つ:
n_iterはランダムサーチでグリッドから取るサンプル数です。先の例では 300。param_distributionsはparam_gridと少し異なり、サンプリング用の分布を任意で指定できます。- 既定ではすべての組合せが同じ確率で選ばれます。
RandomizedSearchCV オブジェクトの作成
先ほどのグリッドサーチと同様に、次の小さな変更でランダムサーチオブジェクトを作れます:
# Set up the sample space learn_rate_list = np.linspace(0.001,2,150) min_samples_leaf_list = list(range(1,51)) # Create the grid parameter_grid = { 'learning_rate' : learn_rate_list, 'min_samples_leaf' : min_samples_leaf_list}# Define how many samples number_models = 10
RandomizedSearchCV オブジェクトの作成
では、このオブジェクトを作成します:
# Create a random search object
random_GBM_class = RandomizedSearchCV(
    estimator = GradientBoostingClassifier(),
    param_distributions = parameter_grid,
    n_iter = number_models,
    scoring='accuracy',
    n_jobs=4,
    cv = 10,
    refit=True,
    return_train_score = True)
# Fit the object to our data
random_GBM_class.fit(X_train, y_train)
出力を分析する
出力はまったく同じです。
選ばれたハイパーパラメータ値を見るには?
cv_results_ の辞書(該当する param_ 列)です。
リストを抽出:
rand_x = list(random_GBM_class.cv_results_['param_learning_rate'])
rand_y = list(random_GBM_class.cv_results_['param_min_samples_leaf'])
出力を分析する
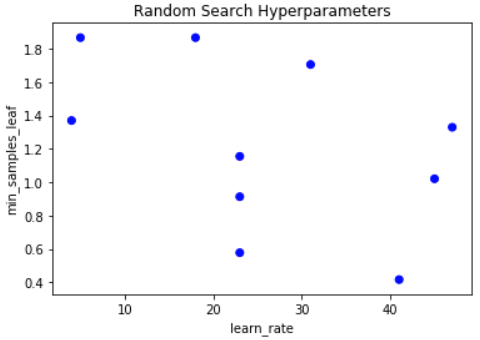
可視化を作成:
# Make sure we set the limits of Y and X appriately x_lims = [np.min(learn_rate_list), np.max(learn_rate_list)] y_lims = [np.min(min_samples_leaf_list), np.max(min_samples_leaf_list)]# Plot grid results plt.scatter(rand_y, rand_x, c=['blue']*10) plt.gca().set(xlabel='learn_rate', ylabel='min_samples_leaf', title='Random Search Hyperparameters') plt.show()
出力を分析する
先ほどと似たグラフです:
Vamos praticar!
Pythonでのハイパーパラメータチューニング

