アルゴリズムの選択

PySparkで学ぶ特徴量エンジニアリング

John Hogue

Lead Data Scientist, General Mills

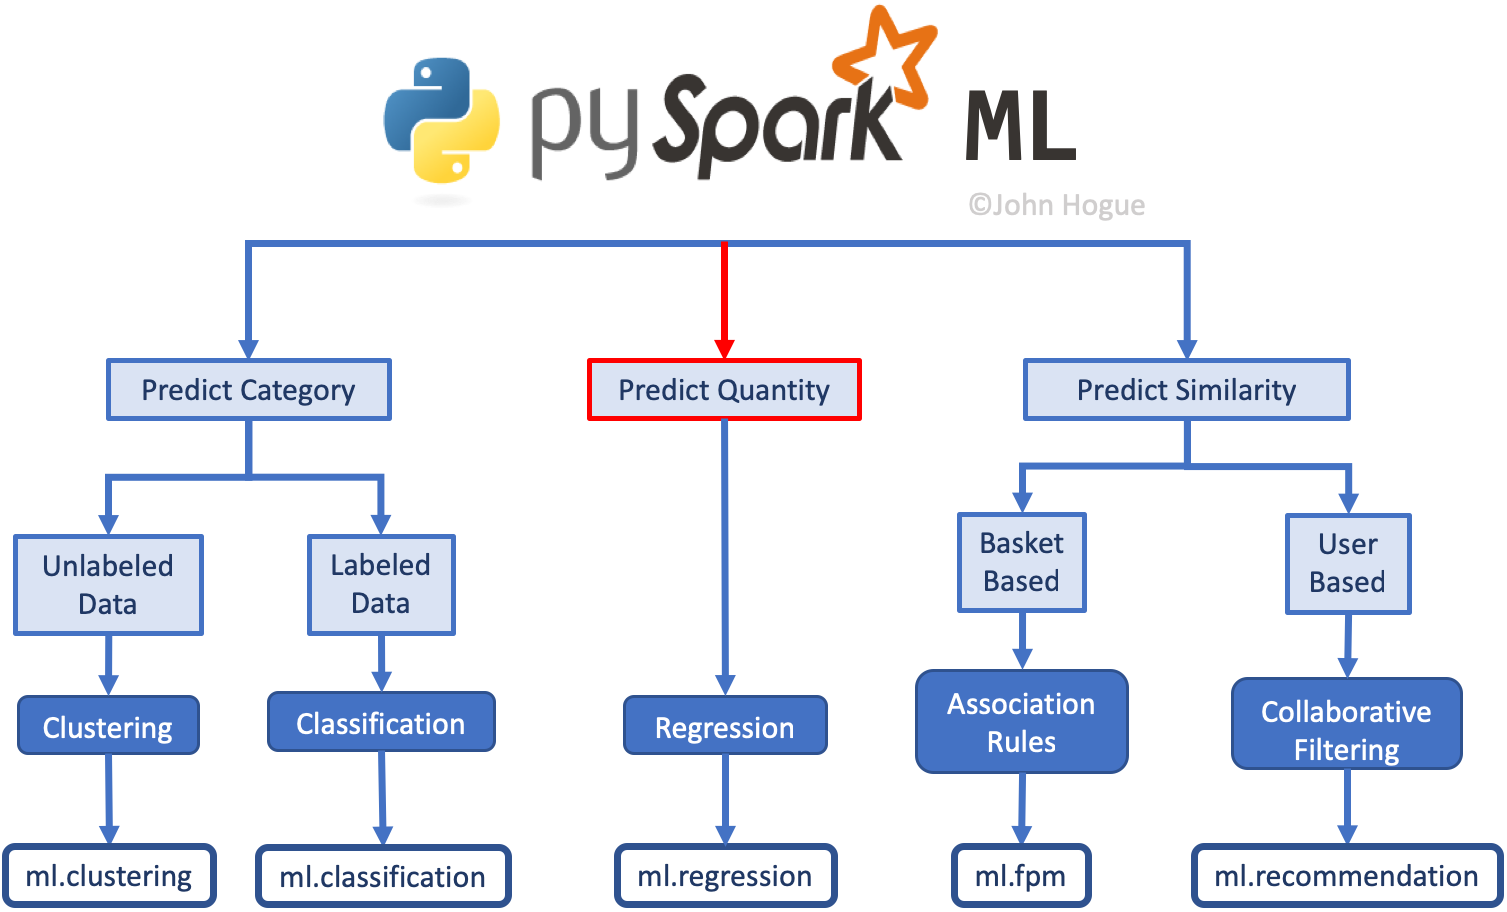
Spark ML の全体像

ML フローチャート

PySparkで学ぶ特徴量エンジニアリング

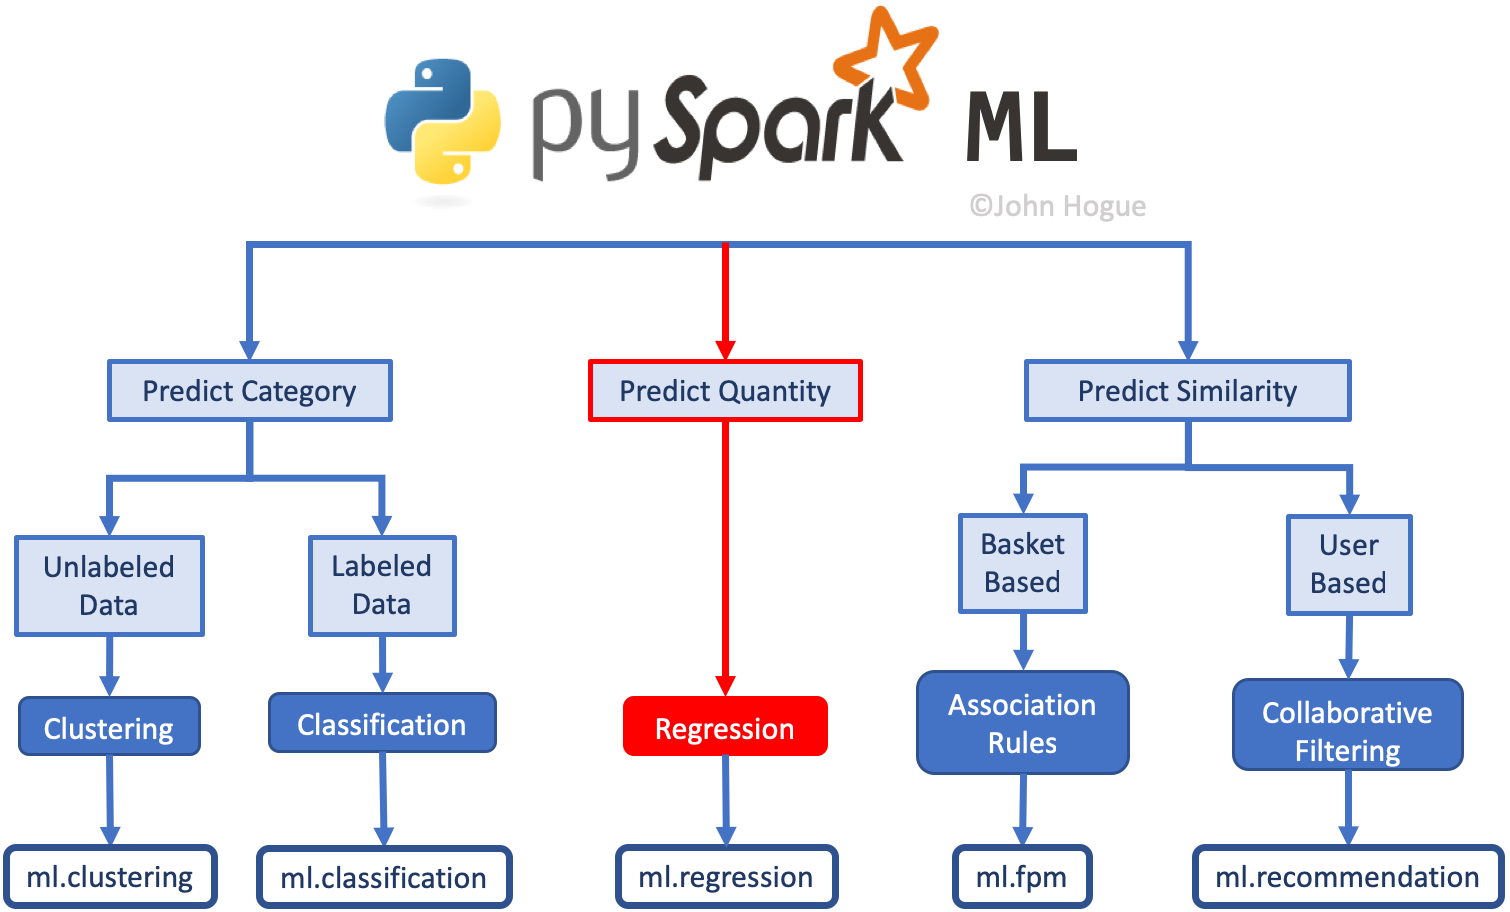
Spark ML の全体像

ML フローチャート

PySparkで学ぶ特徴量エンジニアリング

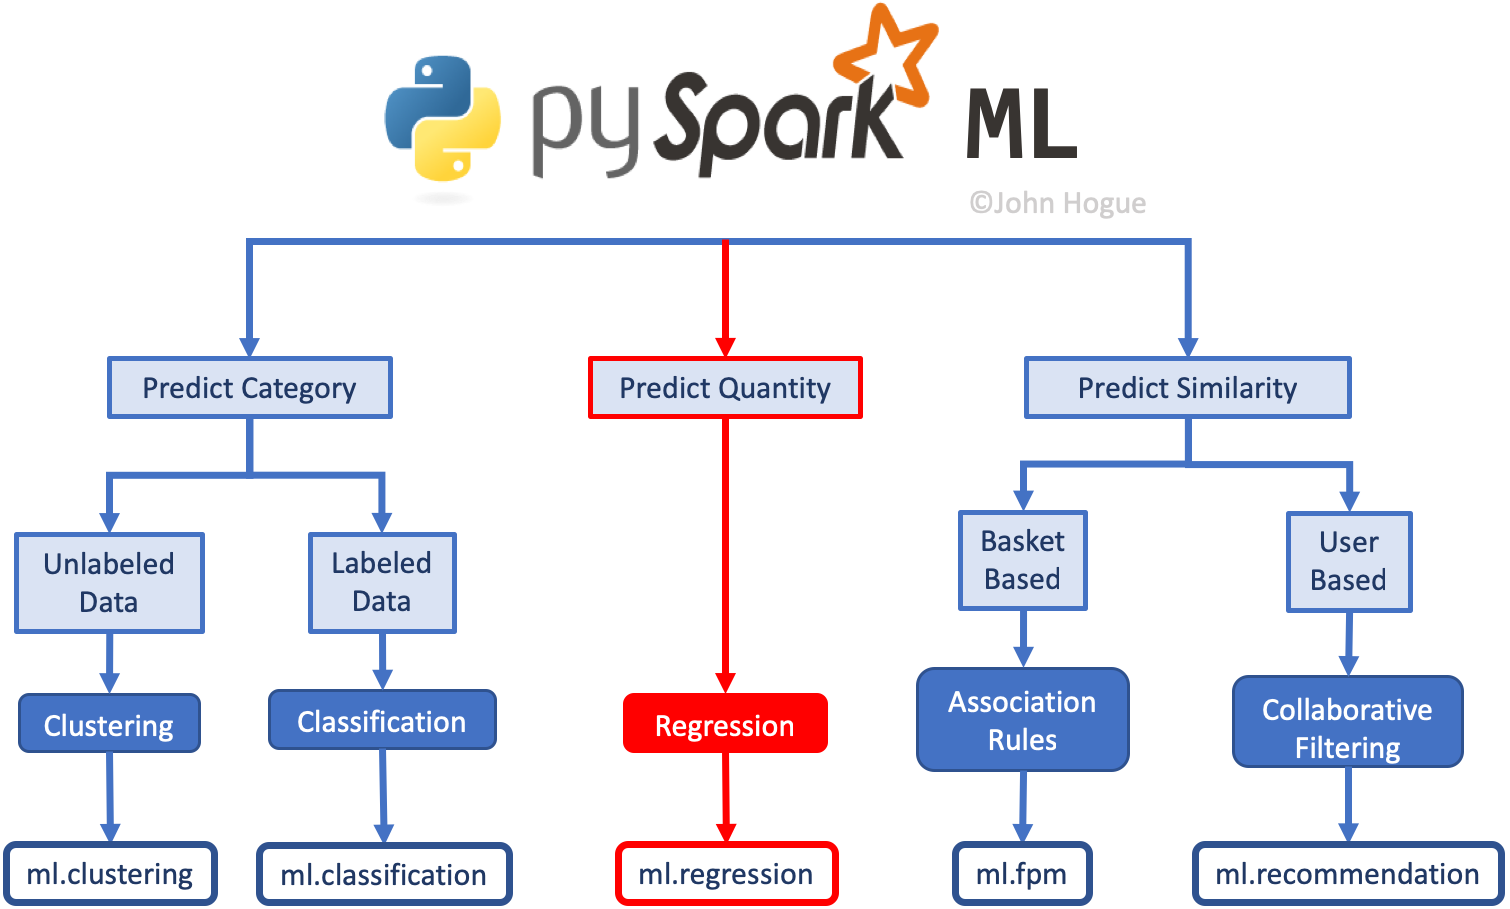
Spark ML の全体像

ML フローチャート

PySparkで学ぶ特徴量エンジニアリング

Spark ML の全体像

ML フローチャート

PySparkで学ぶ特徴量エンジニアリング

PySpark の回帰手法

ml.regression の手法:

  • GeneralizedLinearRegression
  • IsotonicRegression
  • LinearRegression


  • DecisionTreeRegression
  • GBTRegression
  • RandomForestRegression
PySparkで学ぶ特徴量エンジニアリング

PySpark の回帰手法

ml.regression の手法:

  • GeneralizedLinearRegression
  • IsotonicRegression
  • LinearRegression


  • DecisionTreeRegression
  • GBTRegression
  • RandomForestRegression
PySparkで学ぶ特徴量エンジニアリング

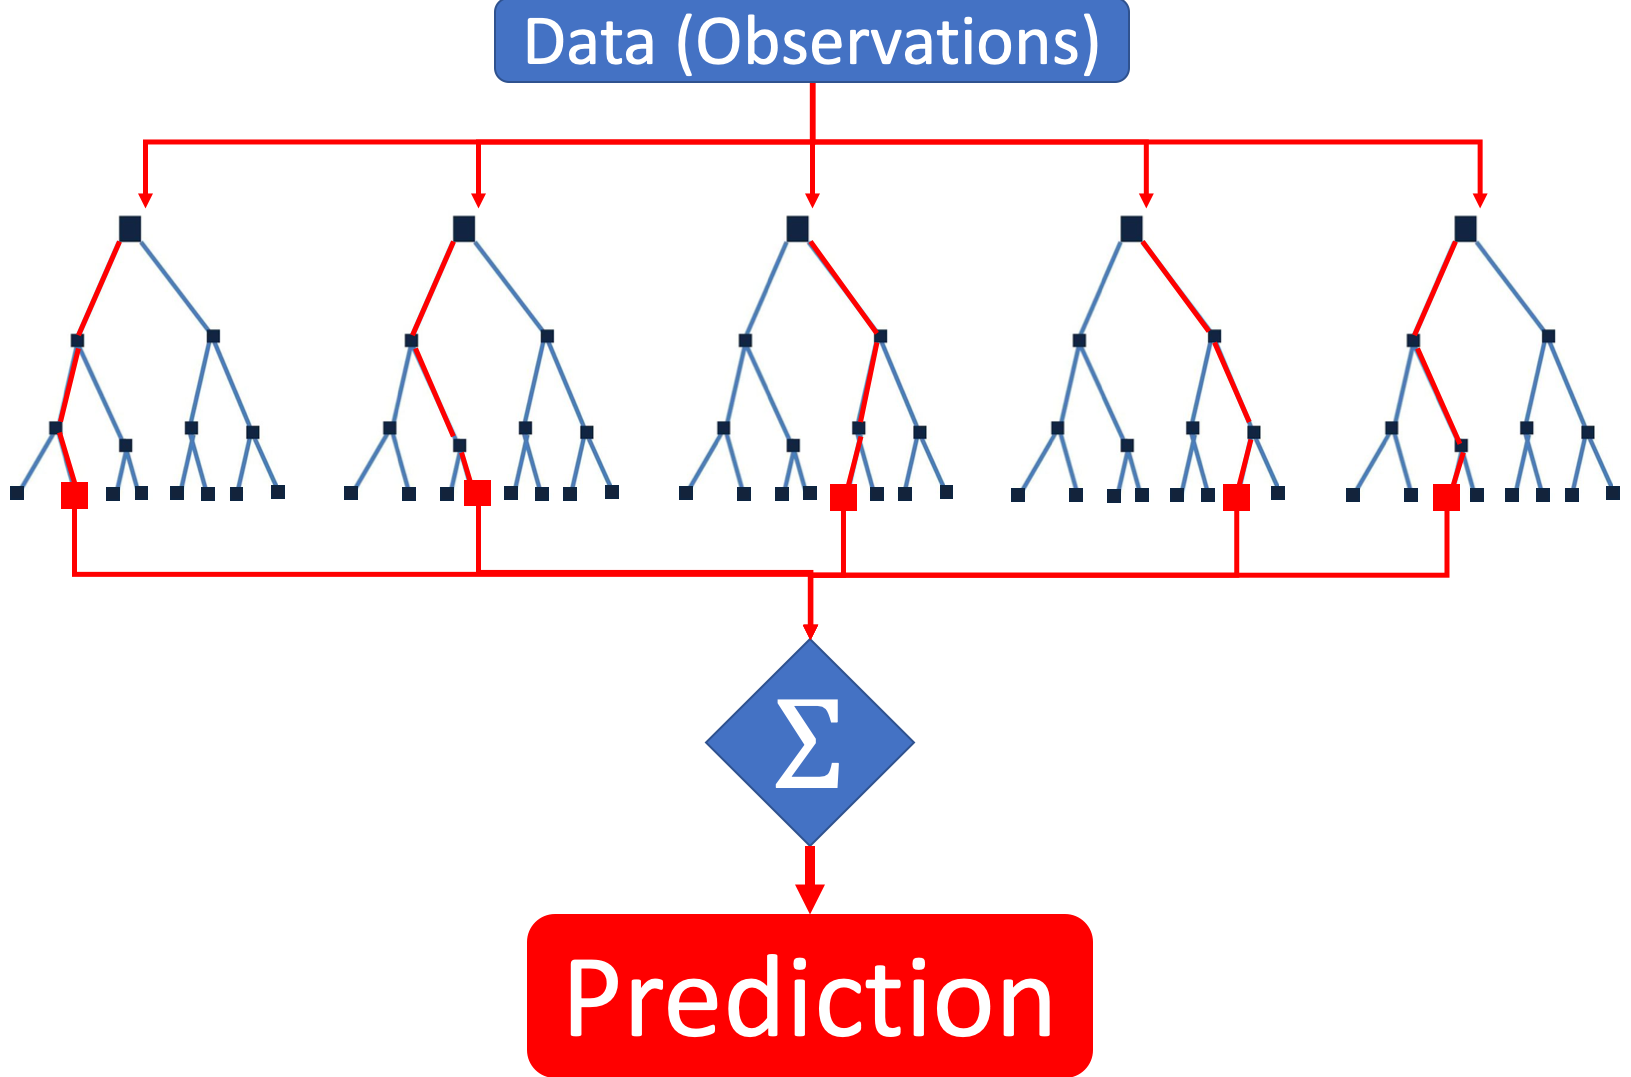
RFR 図

PySparkで学ぶ特徴量エンジニアリング

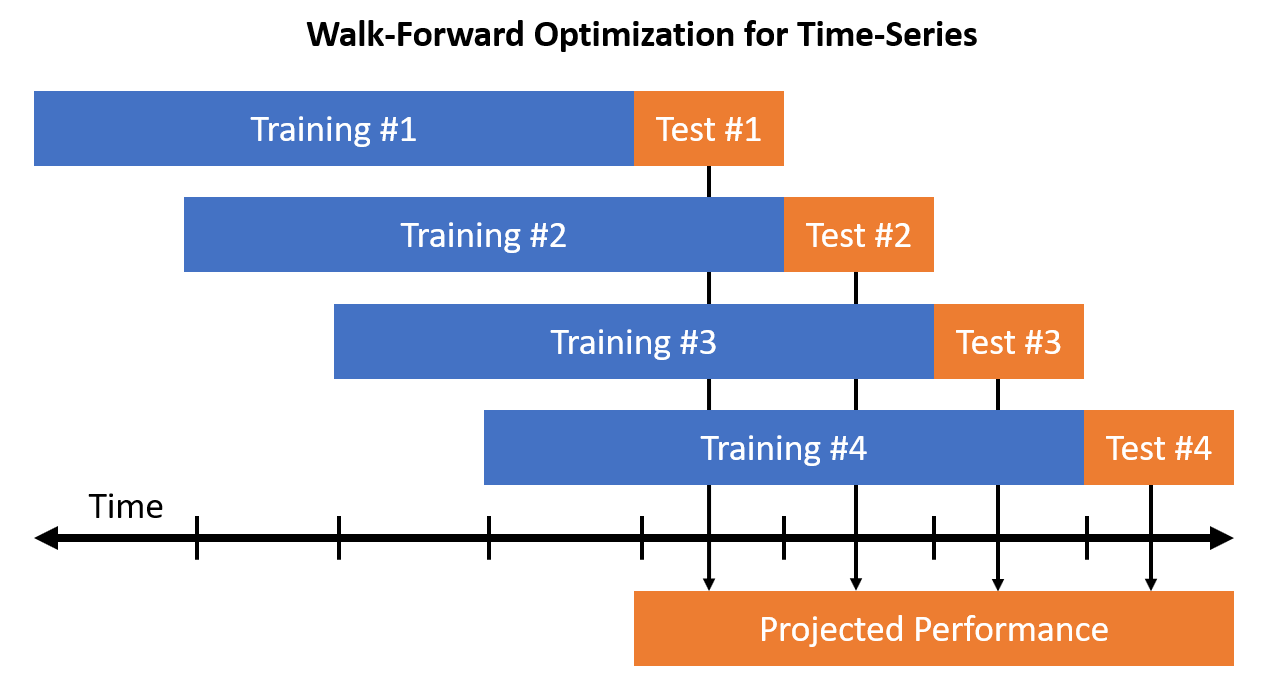
時系列の学習・テスト分割

PySparkで学ぶ特徴量エンジニアリング

時系列の学習・テスト分割

# Create variables for max and min dates in our dataset
max_date = df.agg({'OFFMKTDATE': 'max'}).collect()[0][0]
min_date = df.agg({'OFFMKTDATE': 'min'}).collect()[0][0]
# Find how many days our data spans
from pyspark.sql.functions import datediff
range_in_days = datediff(max_date, min_date)
# Find the date to split the dataset on
from pyspark.sql.functions import date_add
split_in_days = round(range_in_days * 0.8)
split_date = date_add(min_date, split_in_days)
# Split the data into 80% train, 20% test
train_df = df.where(df['OFFMKTDATE'] < split_date) 
test_df = df.where(df['OFFMKTDATE'] >= split_date)\
  .where(df['LISTDATE'] >= split_date)
PySparkで学ぶ特徴量エンジニアリング

Vamos praticar!

PySparkで学ぶ特徴量エンジニアリング

Preparing Video For Download...