PySparkで学ぶ特徴量エンジニアリング
John Hogue
Lead Data Scientist, General Mills
長所

短所

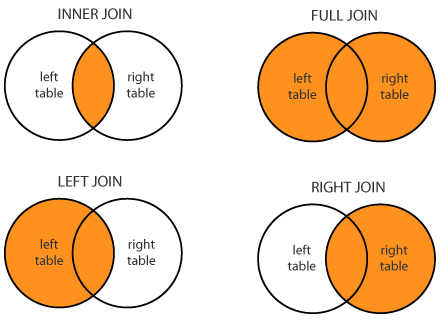
結合方向の確認

DataFrame.join(other, # 結合するもう一方のDataFrameon=None, # 結合キーhow=None) # 結合タイプ(既定は 'inner')
# 先頭を確認
hdf.show(2)
+----------+--------------------+
| dt| nm|
+----------+--------------------+
|2012-01-02| New Year Day|
|2012-01-16|Martin Luther Kin...|
+----------+--------------------+
only showing top 2 rows
# 結合条件を指定 cond = [df['OFFMARKETDATE'] == hdf['dt']]# hdfをdfに結合(左結合) df = df.join(hdf, on=cond, 'left')# 祝日に発生した売上はいくつ? df.where(~df['nm'].isNull()).count()
0
# データフレームを一時テーブルとして登録
df.createOrReplaceTempView("df")
hdf.createOrReplaceTempView("hdf")
# SQL文を作成
sql_df = spark.sql("""
SELECT
*
FROM df
LEFT JOIN hdf
ON df.OFFMARKETDATE = hdf.dt
""")
PySparkで学ぶ特徴量エンジニアリング