データの視覚的検査

PySparkで学ぶ特徴量エンジニアリング

John Hogue

Lead Data Scientist, General Mills

DataFrame.describe() による記述統計

df.describe(['LISTPRICE']).show()
+-------+------------------+
|summary|         LISTPRICE|
+-------+------------------+
|  count|              5000|
|   mean|        263419.365|
| stddev|143944.10818036905|
|    min|            100000|
|    max|             99999|
+-------+------------------+
PySparkで学ぶ特徴量エンジニアリング

多くの記述統計関数がすでに利用可能

  • 平均
    • pyspark.sql.functions.mean(col)
  • 歪度
    • pyspark.sql.functions.skewness(col)
  • 最小値
    • pyspark.sql.functions.min(col)
  • 共分散
    • cov(col1, col2)
  • 相関
    • corr(col1, col2)
PySparkで学ぶ特徴量エンジニアリング

mean() の使用例

  • mean(col)
  • 集計関数:グループ内の値の平均を返します。
df.agg({'SALESCLOSEPRICE': 'mean'}).collect()
[Row(avg(SALESCLOSEPRICE)=262804.4668)]
PySparkで学ぶ特徴量エンジニアリング

cov() の使用例

  • cov(col1, col2)
  • パラメータ:
    • col1 – 1番目の列
    • col2 – 2番目の列
df.cov('SALESCLOSEPRICE', 'YEARBUILT')
1281910.3840634783
PySparkで学ぶ特徴量エンジニアリング

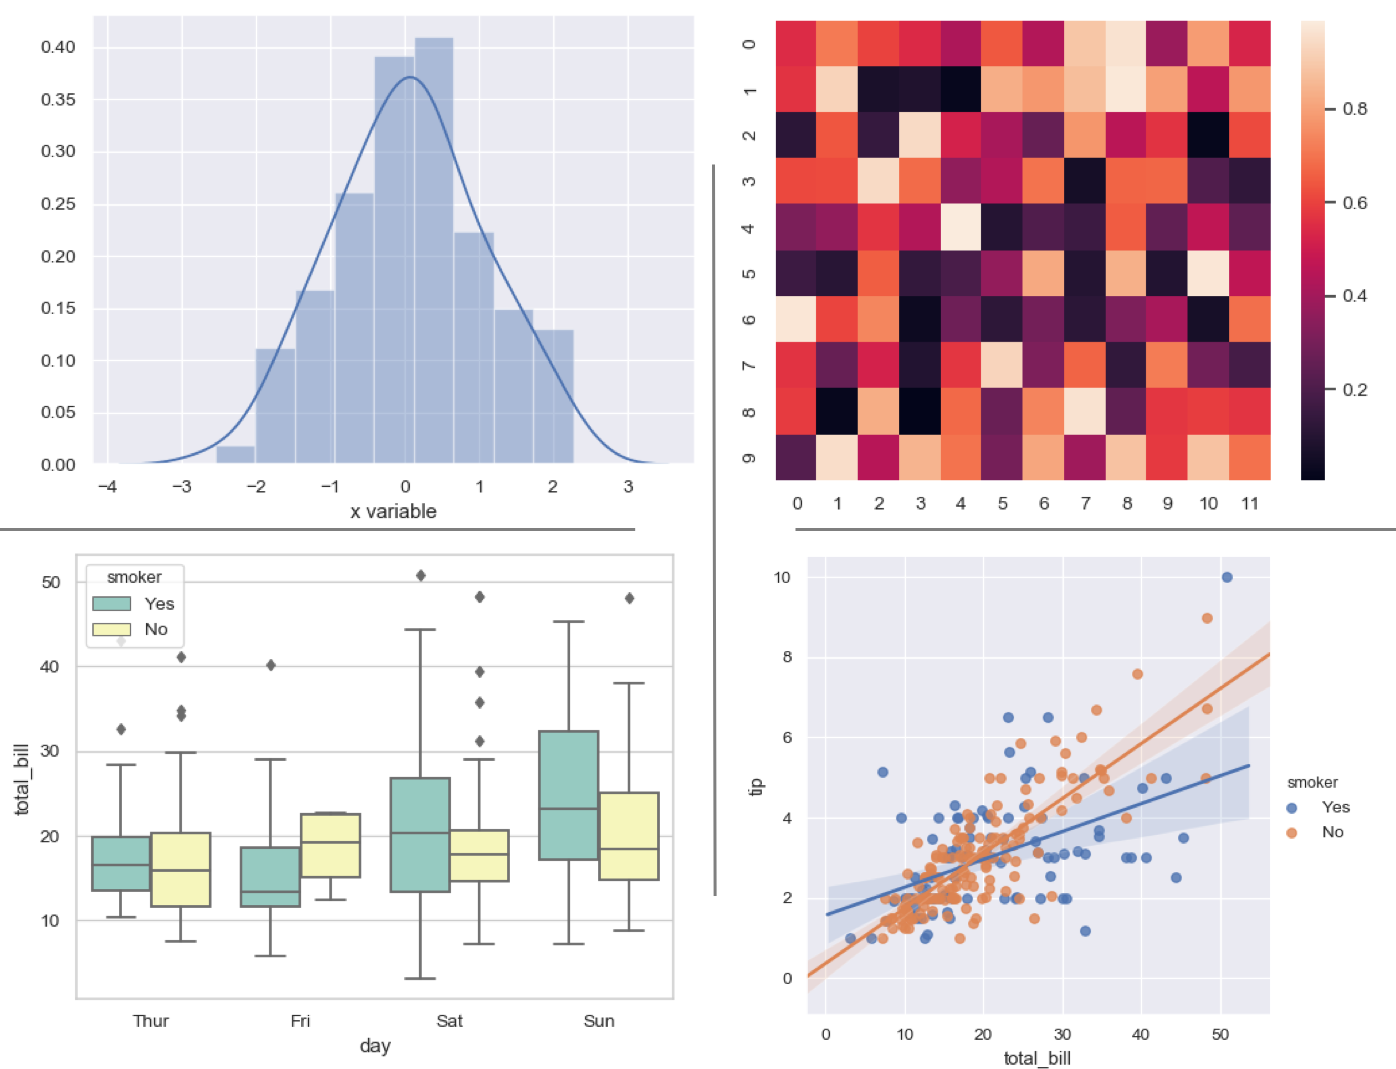
seaborn:統計データ可視化ライブラリ

Seaborn

PySparkで学ぶ特徴量エンジニアリング

プロットに関する注意

SeabornなどのライブラリでPySpark DataFrameをプロットするには、Pandasへの変換が必要です

注意: 変換前にPySpark DataFrameをサンプリングしてください!

  • sample(withReplacement, fraction, seed=None)
    • withReplacement サンプルに重複を許可する
    • fraction 保持するレコードの割合
    • seed 再現性のための乱数シード
# Sample 50% of the PySpark DataFrame and count rows
df.sample(False, 0.5, 42).count()
2504
PySparkで学ぶ特徴量エンジニアリング

分布プロットの準備

Seaborn distplot()

  • seaborn.distplot(a)
  • a : Series、1次元配列、またはリスト。観測データ。
# Import your favorite visualization library
import seaborn as sns

# Sample the dataframe sample_df = df.select(['SALESCLOSEPRICE']).sample(False, 0.5, 42)
# Convert the sample to a Pandas DataFrame pandas_df = sample_df.toPandas()
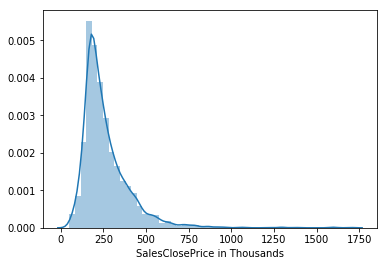
# Plot it sns.distplot(pandas_df)
PySparkで学ぶ特徴量エンジニアリング

販売成約価格の分布プロット

販売成約価格の分布プロット

PySparkで学ぶ特徴量エンジニアリング

関係性のプロット

Seaborn lmplot()

  • seaborn.lmplot(x, y, data)
  • x, y : 文字列。入力変数。データの列名を指定します。
  • data : Pandas DataFrame
# Import your favorite visualization library
import seaborn as sns

# Select columns s_df = df.select(['SALESCLOSEPRICE', 'SQFTABOVEGROUND']) # Sample dataframe s_df = s_df.sample(False, 0.5, 42)
# Convert to Pandas DataFrame pandas_df = s_df.toPandas()
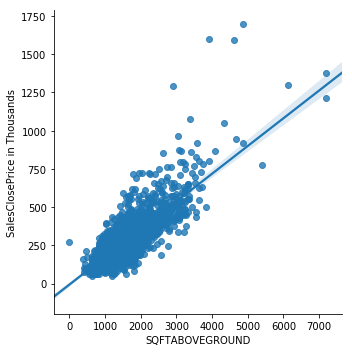
# Plot it sns.lmplot(x='SQFTABOVEGROUND', y='SALESCLOSEPRICE', data=pandas_df)
PySparkで学ぶ特徴量エンジニアリング

地上床面積と販売価格の線形モデルプロット

線形モデルプロット

PySparkで学ぶ特徴量エンジニアリング

では、練習しましょう!

PySparkで学ぶ特徴量エンジニアリング

Preparing Video For Download...