# define min and max values and collect them
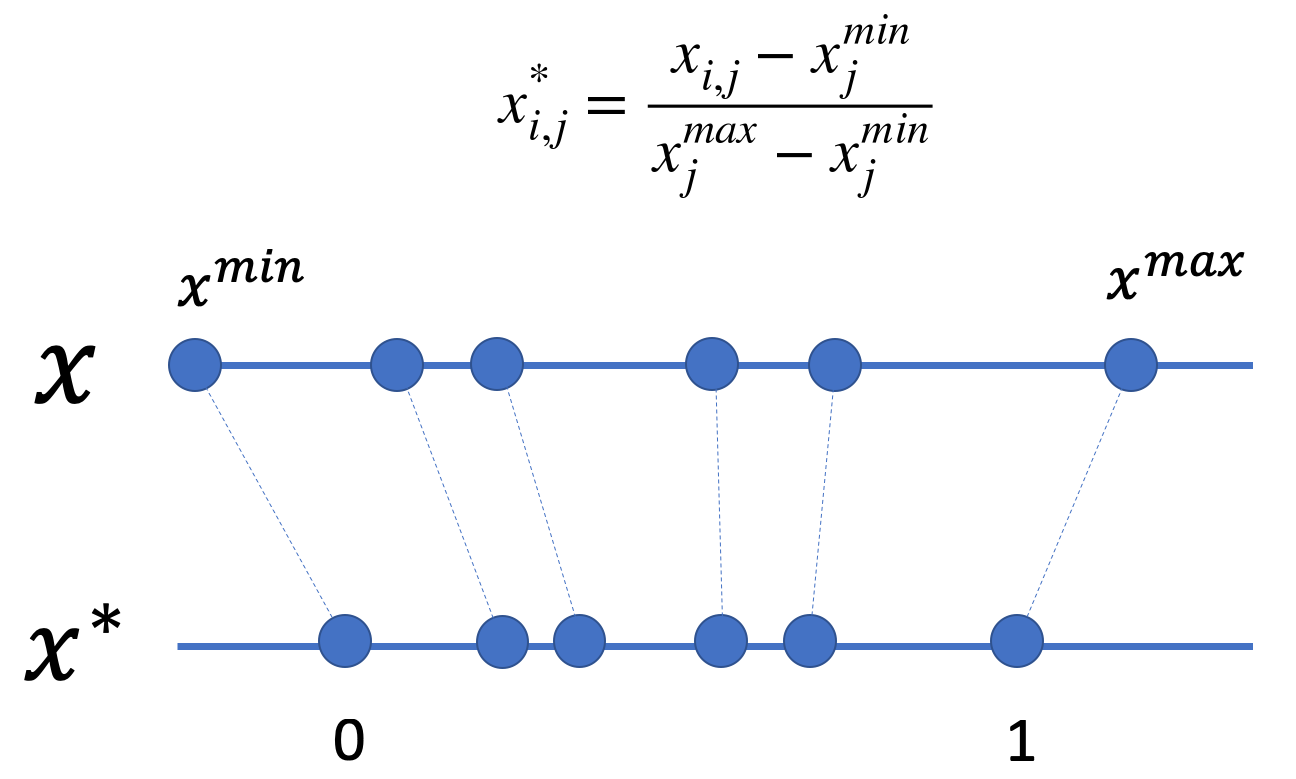
max_days = df.agg({'DAYSONMARKET': 'max'}).collect()[0][0]
min_days = df.agg({'DAYSONMARKET': 'min'}).collect()[0][0]

# create a new column based off the scaled data
df = df.withColumn("scaled_days",
                  (df['DAYSONMARKET'] - min_days) / (max_days - min_days))

df[['scaled_days']].show(5)
+--------------------+
|         scaled_days|
+--------------------+
|0.044444444444444446|
|0.017777777777777778|
| 0.12444444444444444|
| 0.08444444444444445|
| 0.09333333333333334|
+--------------------+
only showing top 5 rows
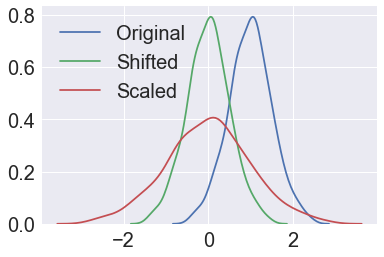
標準化とは?
標準正規分布へのデータ変換
z = (x - μ)/ σ
平均 μ = 0
標準偏差 σ = 1
標準化
mean_days = df.agg({'DAYSONMARKET': 'mean'}).collect()[0][0]
stddev_days = df.agg({'DAYSONMARKET': 'stddev'}).collect()[0][0]

# Create a new column with the scaled data
df = df.withColumn("ztrans_days",
                  (df['DAYSONMARKET'] - mean_days) / stddev_days)

df.agg({'ztrans_days': 'mean'}).collect()
[Row(avg(ztrans_days)=-3.6568525985103407e-16)]
df.agg({'ztrans_days': 'stddev'}).collect()
[Row(stddev(ztrans_days)=1.0000000000000009)]
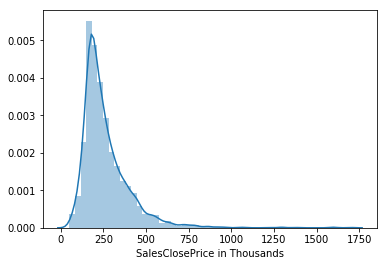
対数スケーリングとは
スケーリング前の分布
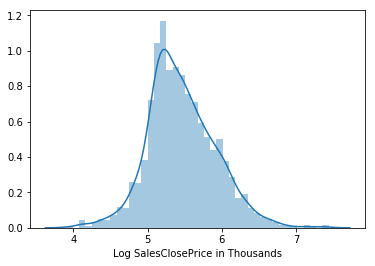
対数スケーリング後の分布
対数スケーリング
# import the log function
from pyspark.sql.functions import log
# Recalculate log of SALESCLOSEPRICE
df = df.withColumn('log_SalesClosePrice', log(df['SALESCLOSEPRICE']))