事前信念

Pythonで学ぶBayesianデータ分析

Michal Oleszak

Machine Learning Engineer

事前分布

  • 事前分布は、データを見る前のパラメータ知識を表します:
    • 何もない → 一様分布(全て同程度に起こりうる)
    • 過去の事後 → 新しいデータで更新可能


  • 外部情報を入れるため、任意の確率分布を事前に選べます:
    • 専門家の意見
    • 共通認識
    • 既存研究
    • 主観的信念
Pythonで学ぶBayesianデータ分析

事前の影響

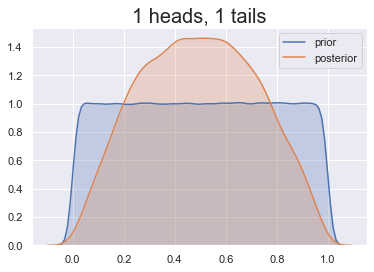
2つの密度プロットが重なっている。1つは事前分布、もう1つは事後分布。事前は一様、事後はやや高い鐘形。

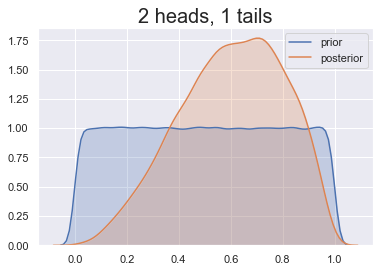
2つの密度プロットが重なっている。1つは事前分布、もう1つは事後分布。事前は一様、事後はやや高い右に歪んだ鐘形。

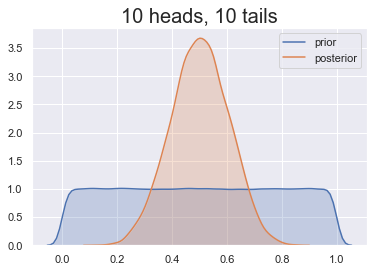
2つの密度プロットが重なっている。1つは事前分布、もう1つは事後分布。事前は一様、事後はかなり高い鐘形。

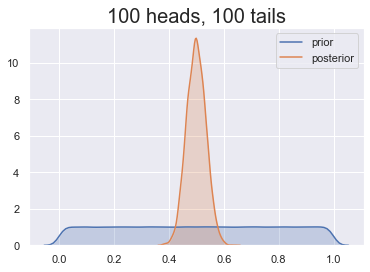
2つの密度プロットが重なっている。1つは事前分布、もう1つは事後分布。事前は一様、事後は非常に高い鐘形。

Pythonで学ぶBayesianデータ分析

事前分布

  • 事前分布は、データを見る前に選びます。
  • 事前の選択は事後に影響します(特にデータが少ないとき)。
  • 恣意的な選択を避けるため、事前は次を満たすべきです:
    • 明示されている
    • 説明可能(既存研究、妥当な仮定、専門家意見などに基づく)
Pythonで学ぶBayesianデータ分析

適切な事前分布の選択

私たちの事前信念:表は出にくい

左に歪んだ鐘形の密度プロット。約0.25でピーク。

選び方には優劣があります。


左に歪んだ鐘形の密度プロット。約0.25でピーク。前のプロットより少し狭い。

Pythonで学ぶBayesianデータ分析

共役事前分布

  • ある事前分布は、特定の尤度と掛け合わせると既知の事後分布を与えます。
  • これを共役事前分布と呼びます。
  • コイン投げの場合:
    • 事前に Beta(a, b) を選ぶと、
    • 事後は Beta(#heads + a, #tosses - #heads + b) になります
  • 事後分布からは numpy でサンプリングできます。
  • 第1章の get_heads_prob():
    def get_heads_prob(tosses):
      num_heads = np.sum(tosses)
      # prior: Beta(1,1)
      return np.random.beta(num_heads + 1, len(tosses) - num_heads + 1, 1000)
    
Pythonで学ぶBayesianデータ分析

事後分布を得る2つの方法

シミュレーション

  • 事後分布が既知なら、numpy でサンプリングできます:
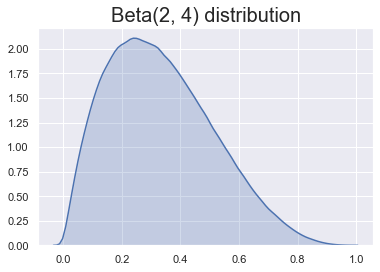
    draws = np.random.beta(2, 4, 1000)
    
  • 結果:事後サンプル1000個の配列
    array([0.05941031, ..., 0.70015975])
    
  • 次でプロット可能:
    sns.kdeplot(draws)
    

計算

  • 事後分布が未知なら、グリッド近似で計算できます。
  • 結果:各グリッド要素の事後確率
           head_prob  posterior_prob
    0           0.00        0.009901
    1           0.01        0.003624
               ...           ...
    10199       0.99        0.003624
    10200       1.00        0.009901
    
  • 次でプロット可能:
    sns.lineplot(df["head_prob"], df["posterior_prob"])
    
Pythonで学ぶBayesianデータ分析

事前分布で手を動かしましょう!

Pythonで学ぶBayesianデータ分析

Preparing Video For Download...