ランダムフォレストモデルの構築とチューニング

Tidyverse で学ぶ Machine Learning

Dmitriy (Dima) Gorenshteyn

Lead Data Scientist, Memorial Sloan Kettering Cancer Center

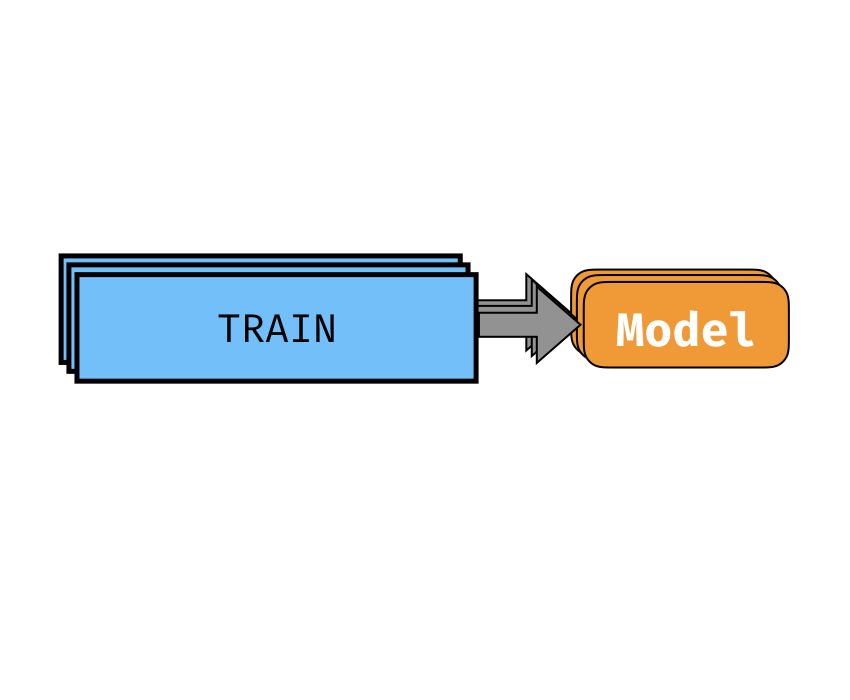
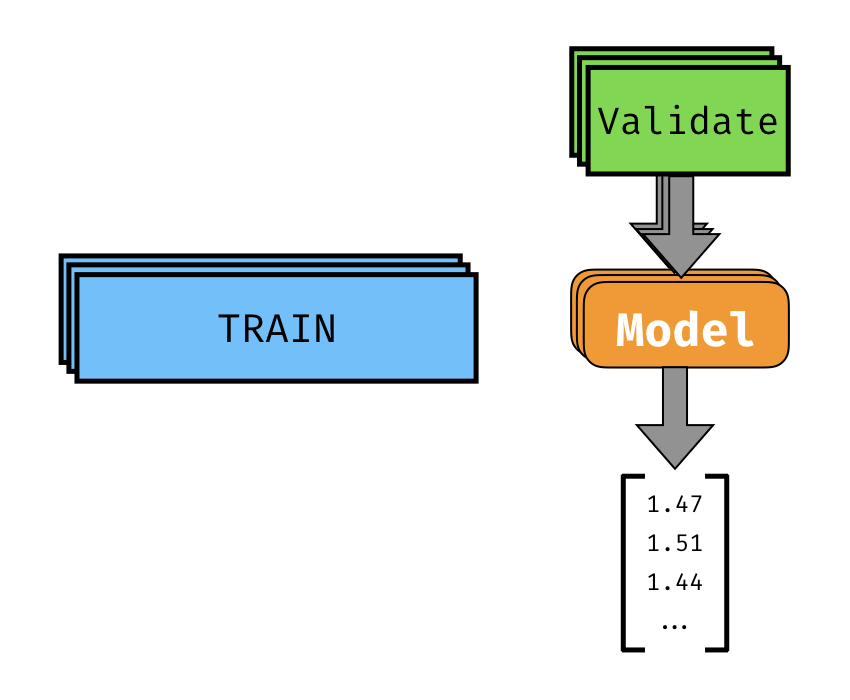
交差検証のパフォーマンス

Tidyverse で学ぶ Machine Learning

交差検証のパフォーマンス

Tidyverse で学ぶ Machine Learning

交差検証のパフォーマンス

Tidyverse で学ぶ Machine Learning

交差検証のパフォーマンス

Tidyverse で学ぶ Machine Learning

線形回帰モデル


検証用平均絶対誤差:

1.5 年

Tidyverse で学ぶ Machine Learning

別のモデル

Tidyverse で学ぶ Machine Learning

ランダムフォレストの利点

  • 非線形関係を扱える
  • 交互作用を扱える
Tidyverse で学ぶ Machine Learning

ランダムフォレストの基本ツール

モデル
rf_model <- ranger(formula = ___, data = ___, seed = ___)


予測
prediction <- predict(rf_model, new_data)$predictions
Tidyverse で学ぶ Machine Learning

基本的なランダムフォレストモデルの構築

library(ranger)
cv_models_rf <- cv_data %>% 
 mutate(model = map(train, ~ranger(formula = life_expectancy~., 
                                    data = .x, seed = 42)))
cv_prep_rf <- cv_models_rf %>% 
 mutate(validate_predicted = map2(model, validate, 
                                  ~predict(.x, .y)$predictions))
Tidyverse で学ぶ Machine Learning

ranger のハイパーパラメータ

モデル
rf_model <- ranger(formula, data, seed, mtry, num.trees)
ハイパーパラメータ
名前 範囲 デフォルト
mtry $1:number\ of\ features$ $\sqrt{number\ of\ feat}$
num.trees $1:\infty$ $500$
Tidyverse で学ぶ Machine Learning

ハイパーパラメータのチューニング

cv_tune <- cv_data %>% 
  crossing(mtry = 1:5)

cv_tune
# A tibble: 25 x 5
   splits       id    train                validate            mtry
   <list>       <chr> <list>               <list>             <int>
 1 <S3: rsplit> Fold1 <tibble [2,402 × 7]> <tibble [601 × 7]>     1
 2 <S3: rsplit> Fold1 <tibble [2,402 × 7]> <tibble [601 × 7]>     2
 3 <S3: rsplit> Fold1 <tibble [2,402 × 7]> <tibble [601 × 7]>     3
 4 <S3: rsplit> Fold1 <tibble [2,402 × 7]> <tibble [601 × 7]>     4
 5 <S3: rsplit> Fold1 <tibble [2,402 × 7]> <tibble [601 × 7]>     5
 6 <S3: rsplit> Fold2 <tibble [2,402 × 7]> <tibble [601 × 7]>     1
 7 <S3: rsplit> Fold2 <tibble [2,402 × 7]> <tibble [601 × 7]>     2
Tidyverse で学ぶ Machine Learning

ハイパーパラメータのチューニング

cv_model_tunerf <- cv_tune %>% 
  mutate(model = map2(train, mtry, ~ranger(formula = life_expectancy~., 
                                           data = .x, mtry = .y)))

cv_model_tunerf
# A tibble: 25 x 6
   splits       id    train                validate      mtry  model       
 * <list>       <chr> <list>               <list>        <int> <list>      
 1 <S3: rsplit> Fold1 <tibble [2,402 × 7]> <tibble [60…   1    <S3: ranger>
 2 <S3: rsplit> Fold1 <tibble [2,402 × 7]> <tibble [60…   2    <S3: ranger>
 3 <S3: rsplit> Fold1 <tibble [2,402 × 7]> <tibble [60…   3    <S3: ranger>
 4 <S3: rsplit> Fold1 <tibble [2,402 × 7]> <tibble [60…   4    <S3: ranger>
 5 <S3: rsplit> Fold1 <tibble [2,402 × 7]> <tibble [60…   5    <S3: ranger>
 6 <S3: rsplit> Fold2 <tibble [2,402 × 7]> <tibble [60…   1    <S3: ranger>
 7 <S3: rsplit> Fold2 <tibble [2,402 × 7]> <tibble [60…   2    <S3: ranger>
Tidyverse で学ぶ Machine Learning

練習しましょう!

Tidyverse で学ぶ Machine Learning

Preparing Video For Download...