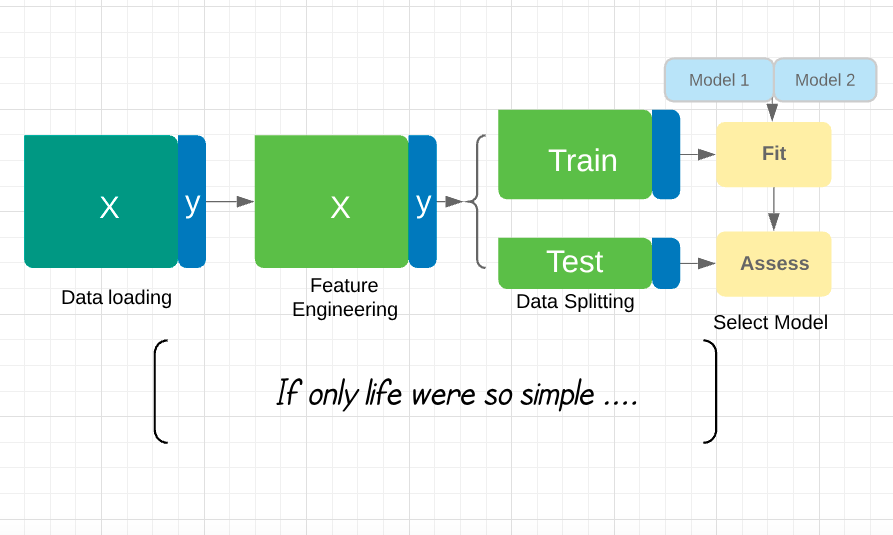
Python で設計する Machine Learning ワークフロー
Dr. Chris Anagnostopoulos
Honorary Associate Professor
X
y
credit_scoring.head(4)
  checking_status  duration  ...  foreign_worker class
0            '<0'         6  ...             yes  good
1      '0<=X<200'        48  ...             yes   bad
2   'no checking'        12  ...             yes  good
3            '<0'        42  ...             yes  good
sklearn.preprocessing の LabelEncoder で前処理:
sklearn.preprocessing
LabelEncoder
le = LabelEncoder()
le.fit_transform(credit_scoring['checking_status'])[:4]
array([1, 0, 3, 1])
.fit(features, labels)
.predict(features)
features, labels = credit_scoring.drop('class', 1), credit_scoring['class']

model_nb = GaussianNB()
model_nb.fit(features, labels)
model_nb.predict(features.head(5))
features, labels = credit_scoring.drop('class', 1), credit_scoring['class']
model_nb = GaussianNB() model_nb.fit(features, labels) model_nb.predict(features.head(5))
['good' 'bad' 'good' 'bad' 'good']
最初の5件で正解率60%。
.fit()
AdaBoostClassifier は最初の5件で GaussianNB を上回る:
AdaBoostClassifier
GaussianNB
model_ab = AdaBoostClassifier()
model_ab.fit(features, labels)
model_ab.predict(features.head(5))
numpy.array(labels[0:5])
['good' 'bad' 'good' 'good' 'bad']
['good' 'bad' 'good' 'good' 'bad']
サンプルが多いほど精度推定は安定:
from sklearn.metrics import accuracy_score
accuracy_score(labels, model_nb.predict(features)) # naive bayes
0.706
accuracy_score(labels, model_ab.predict(features)) # adaboost
0.802
この計算の問題点は?
過学習: モデルは学習データより未知データで精度が下がります。
X_train, y_trainで学習し、X_test, y_testで精度評価:
X_train, y_train
X_test, y_test
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)

GaussianNB().fit(X_train, y_train).predict(X_test)
from sklearn.model_selection import train_test_split X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
GaussianNB().fit(X_train, y_train).predict(X_test)