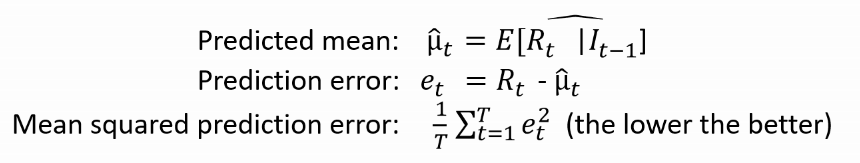GARCHの予測は観測リターンにどれほど適合するか?

Rで学ぶGARCHモデル

Kris Boudt

Professor of finance and econometrics

評価基準

  • 何を評価するかによる
    • 予測平均
    • 予測分散
    • リターンの予測分布
Rで学ぶGARCHモデル

1) 平均予測の当てはまり

推定したGARCHモデルに基づき:

実装

e <- residuals(tgarchfit) 
mean(e ^ 2)
Rで学ぶGARCHモデル

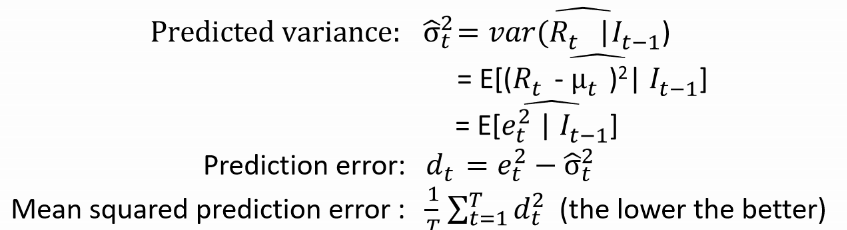
2) 分散予測の当てはまり

GARCHモデルにより次を得ます:

実装

e <- residuals(tgarchfit)
d <- e ^ 2 - sigma(tgarchfit) ^ 2 
mean(d ^ 2)
Rで学ぶGARCHモデル

EUR/USDリターンの例

tgarchspec <- ugarchspec(mean.model = list(armaOrder = c(0, 0)),
   variance.model = list(model = "sGARCH", variance.targeting = TRUE),
   distribution.model = "std")
tgarchfit <- ugarchfit(data = EURUSDret, spec = tgarchspec)
# 平均の二乗予測誤差
e <- residuals(tgarchfit) ^ 2
mean(e ^ 2) # 3.836205e-05
# 分散の二乗予測誤差
d <- e ^ 2 - sigma(tgarchfit) ^ 2
mean(d ^ 2) # 5.662366e-09
Rで学ぶGARCHモデル

3) 分布の当てはまり

  • GARCHモデルはサンプル内の各リターンの予測密度を与えます
    • 密度が高いほど、そのリターンは推定GARCHモデルの下で起こりやすい
    • サンプルの尤度はこれら密度の積に基づき、観測リターンが推定GARCHから来た確からしさを測ります
    • 尤度が高いほど、データへの適合が良い
Rで学ぶGARCHモデル

EUR/USDリターンの例

likelihood(tgarchfit) # returns 18528.58

他モデルと比較して分析:

# 多数のパラメータを持つ複雑なモデル
flexgarchspec <- ugarchspec(mean.model = list(armaOrder = c(1, 0)),
                            variance.model = list(model = "gjrGARCH"),
                            distribution.model = "sstd")
flexgarchfit <- ugarchfit(data = EURUSDret, spec = flexgarchspec)
likelihood(flexgarchfit) # returns 18530.49
Rで学ぶGARCHモデル

過学習のリスク

【注意】ここでは推定サンプルと評価サンプルが一致するインサンプル評価を用います。

過学習のリスク:

過学習とは、推定に用いたサンプルではよく当てはまるが、サンプル外の将来リターンには当てはまらない、過度に複雑なモデルを選ぶことです。

Rで学ぶGARCHモデル

解決策: 当てはまりと複雑さのペナルティを両立

  • GARCHモデルが倹約的(パラメータが少なく適合が良い)なのは次のとき:
    • 尤度が高い
    • パラメータ数が相対的に少ない
Rで学ぶGARCHモデル

情報量基準

  • 倹約性は情報量基準で測定します。

情報量基準 = - 尤度 + 罰則(パラメータ数)

  • 低いほど良い。

判断の経験則:
最小の情報量基準のモデルを選ぶ。

Rで学ぶGARCHモデル

情報量基準の結果

infocriteria()は各種ペナルティの情報量基準を表示します

infocriteria(tgarchfit)

out Akaike -7.468081 Bayes -7.462833 Shibata -7.468083 Hannan-Quinn -7.466241 `

解釈には他モデルの情報量基準との比較が必要です。

Rで学ぶGARCHモデル

EUR/USDリターンでの例示

tgarchspec <- ugarchspec(mean.model = list(armaOrder = c(0, 0)),
   variance.model = list(model = "sGARCH", variance.targeting = TRUE),
   distribution.model = "std")
tgarchfit <- ugarchfit(data = EURUSDret, spec = tgarchspec)
length(coef(tgarchfit)) # only 5 parameters
likelihood(tgarchfit)   # equals 18528.58
flexgarchspec <- ugarchspec(mean.model = list(armaOrder = c(1, 0)),
   variance.model = list(model = "gjrGARCH"), distribution.model = "sstd")
flexgarchfit <- ugarchfit(data = EURUSDret, spec = flexgarchspec)
length(coef(flexgarchfit)) # we now have 8 parameters
likelihood(flexgarchfit) #  18530.49: likelihood increased
Rで学ぶGARCHモデル

EUR/USDではどのモデルが最も倹約的か?

尤度は高いほど良い。情報量基準は低いほど良い。

infocriteria(tgarchfit) # シンプルなモデル
Akaike       -7.468435
Bayes        -7.464499
infocriteria(flexgarchfit) # 複雑なモデル
Akaike       -7.467239
Bayes        -7.456742

今回はシンプルなモデルの情報量基準が最小で、こちらを選ぶべきです。

Rで学ぶGARCHモデル

結果はケース依存: MSFTリターンの場合

tgarchfit <- ugarchfit(data = msftret, spec = tgarchspec)
flexgarchfit <- ugarchfit(data = msftret, spec = flexgarchspec)
infocriteria(tgarchfit)
Akaike       -5.481895
Bayes        -5.477833
infocriteria(flexgarchfit) 
Akaike       -5.489087
Bayes        -5.478255

このケースでは複雑なモデルの情報量基準が最小で、こちらを選ぶべきです。

Rで学ぶGARCHモデル

KISS: Sophisticatedly Simpleを保つ

Rで学ぶGARCHモデル

Preparing Video For Download...