クラスタリングとクラスターモデル

Pythonで学ぶ離散事象シミュレーション

Diogo Costa (PhD, MSc)

Adjunct Professor, University of Saskatchewan, Canada & CEO of ImpactBLUE-Scientific

モデル結果のヒストグラム

  • モデル結果を確認する
  • 転換点とボトルネックを特定する
  • システムを最適化する

ヒストグラム

  • 度数分布を示すグラフ
  • 各区間における観測値の数を示す

Matplotlib パッケージ

import matplotlib.pyplot as plt

用途: データセット data を50分割してヒストグラムを作成する

plt.hist(data, bins=50)
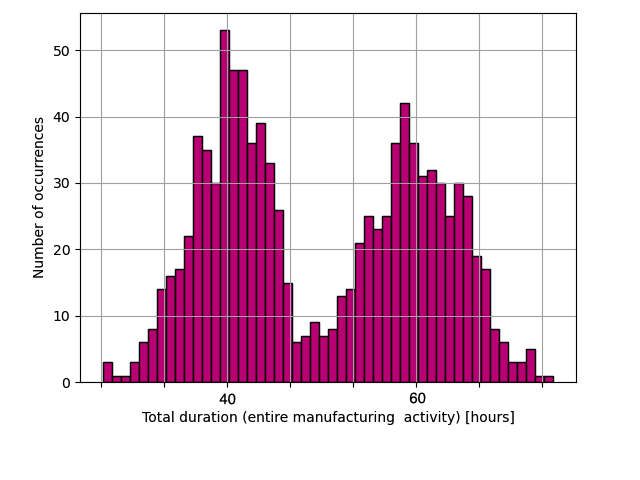
2つのガウス分布を示す50分割のヒストグラムで、2つのデータクラスターを示唆している。

Pythonで学ぶ離散事象シミュレーション

クラスター分析とモデルへの応用

  • 用途
    • パターン認識(例: モデル結果)
    • 画像解析

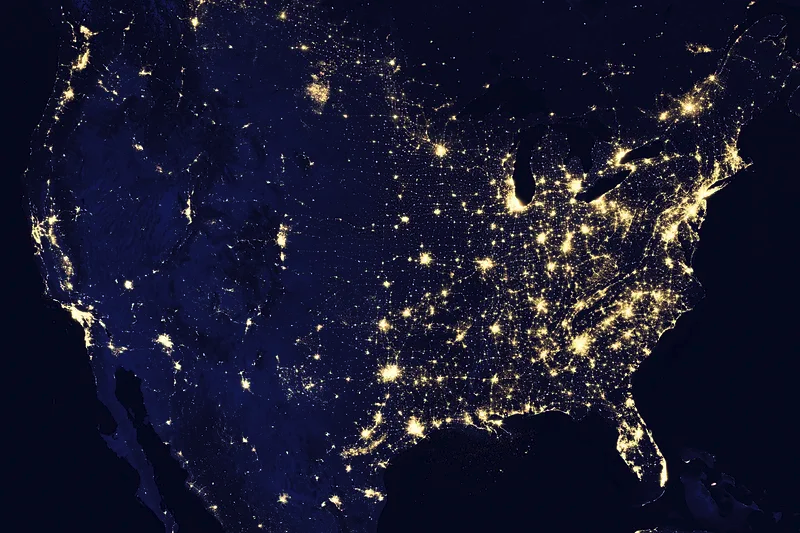
北米の夜間照明を撮影した衛星画像。

  • データ圧縮
  • コンピューターグラフィックス
  • 機械学習

    脳内のニューラルネットワークを描いた図。機械学習の手法やデータパターン、クラスタリングの発生を示唆している。

  • 離散事象モデルにおいて

    • モデル出力のパターンを特定する
    • より実用的な情報を得る
Pythonで学ぶ離散事象シミュレーション

k-means クラスタリング

この章の焦点

  • k-means クラスタリング(重心モデル)
  • 観測値をk個のクラスターに分割する
  • 各観測値は最も近い平均値を持つクラスターに属する
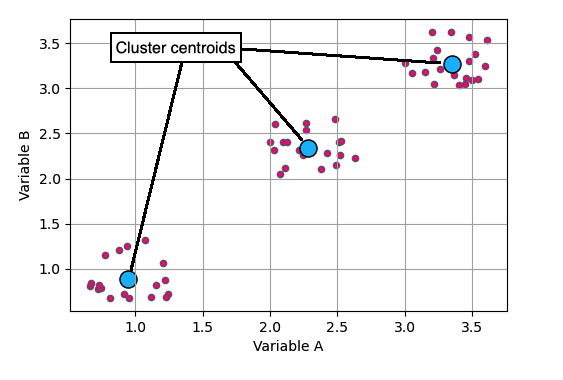
  • クラスターの平均値を「クラスター重心」と呼ぶ

観測値とクラスター重心

k-means クラスタリングで計算したクラスター重心を含むデータを示すグラフ。

Pythonで学ぶ離散事象シミュレーション

SciPy による k-means クラスタリング

SciPy のメソッド

scipy.cluster.vq.kmeans()

実装

import scipy
scipy.cluster.vq.kmeans(
obs, k_or_guess, iter=20, thresh=1e-05,
check_finite=True, *, seed=None)
  • obs は numpy 配列
  • 戻り値:
    1. クラスター重心
    2. 歪み(観測値と生成された重心の平均距離)
Pythonで学ぶ離散事象シミュレーション

データのホワイトニング: 相関除去とスケーリング

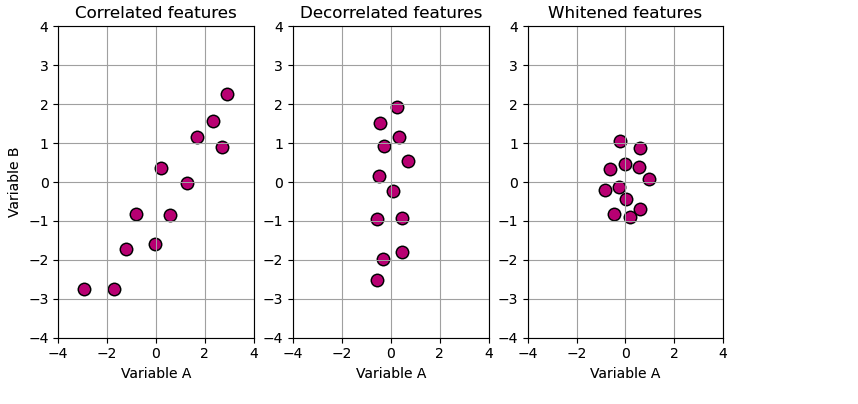
k-means実行前: データのホワイトニング

  1. obs データの相関を除去する
  2. obs の各次元を標準偏差でスケーリングする

3つのパネルからなるプロット。1つ目は相関のあるデータ、2つ目は相関を除去したデータ、3つ目はホワイトニング後のデータを示す。

SciPy の場合

scipy.cluster.vq.whiten(
obs, check_finite=True)
  • obs は numpy 配列
Pythonで学ぶ離散事象シミュレーション

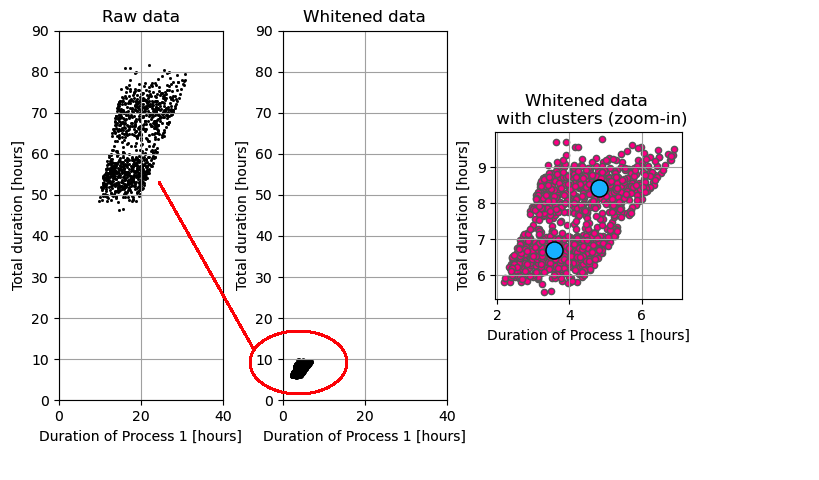
ホワイトニングと k-means の例

  • 複数の工程を含む製造業務
  • Process 1 の影響を見てみましょう

DNT_CURLY_TAG_2 工程1の所要時間を全体の所要時間に対してプロットした図。生データとホワイトニング後のデータについて、k-means クラスタリングで計算したクラスターを示す。

パッケージをインポートする

import scipy.cluster.vq as scvq

モデル結果をホワイトニングする

white_data = scvq.whiten(model_results)

2つのクラスター(青い点)を見つける

cluster_centroids, distortion = 
scvq.kmeans(white_data, 2)
Pythonで学ぶ離散事象シミュレーション

最適なクラスター数

手法

  • シンプル法(クラスターの最大数)
  • エルボー法
  • シルエットスコア係数
  • ギャップ統計量

シンプル法

  • クラスターの最大数を決定する
  • 使い方: $\Big(\dfrac{nobs}{2}\Big)^{0.5}$
    • nobs = 観測値の数
num_clusters = 
  int((model_results.shape[0]/2)**0.5)
  • コンソール出力
    22
    
Pythonで学ぶ離散事象シミュレーション

最適なクラスター数: シルエットスコア法

  • ライブラリをインポートする
from sklearn.metrics import silhouette_score

k 個のクラスターについてシルエットスコアを計算する

for k in range(2, 6):
  model = KMeans(n_clusters=k)
  model.fit(model_results)
  pred = model.predict(model_results)
  score = silhouette_score(model_results, pred)

コンソール出力

Silhouette Score for k = 2: 0.591
Silhouette Score for k = 3: 0.472
Silhouette Score for k = 4: 0.381
Silhouette Score for k = 5: 0.364
Silhouette Score for k = 6: 0.373

結果の解釈

  • 最良値: score = 1
  • 最悪値: score = -1
  • クラスターの重複: score が 0 に近い
Pythonで学ぶ離散事象シミュレーション

練習しましょう!

Pythonで学ぶ離散事象シミュレーション

Preparing Video For Download...