レート制限

FastAPI を使った AI のプロダクション環境へのデプロイ

Matt Eckerle

Software and Data Engineering Leader

レート制限の概要
信号機


  • 目的: APIリクエストの頻度を制御する。
  • レスポンス: 上限超過時にHTTP 429("Too Many Requests")を返す。
FastAPI を使った AI のプロダクション環境へのデプロイ

レート制限の仕組み

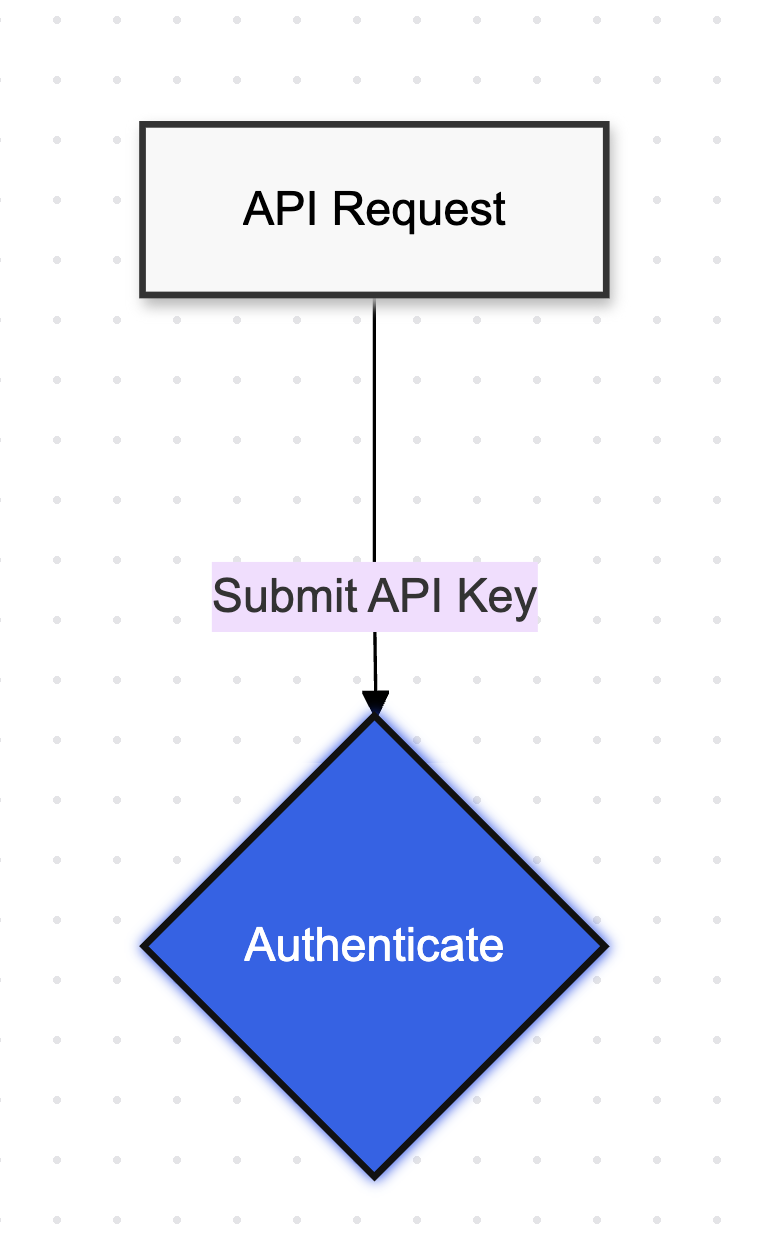
レート制限を説明するフロー図(パート1)

FastAPI を使った AI のプロダクション環境へのデプロイ

受信資格情報の認証

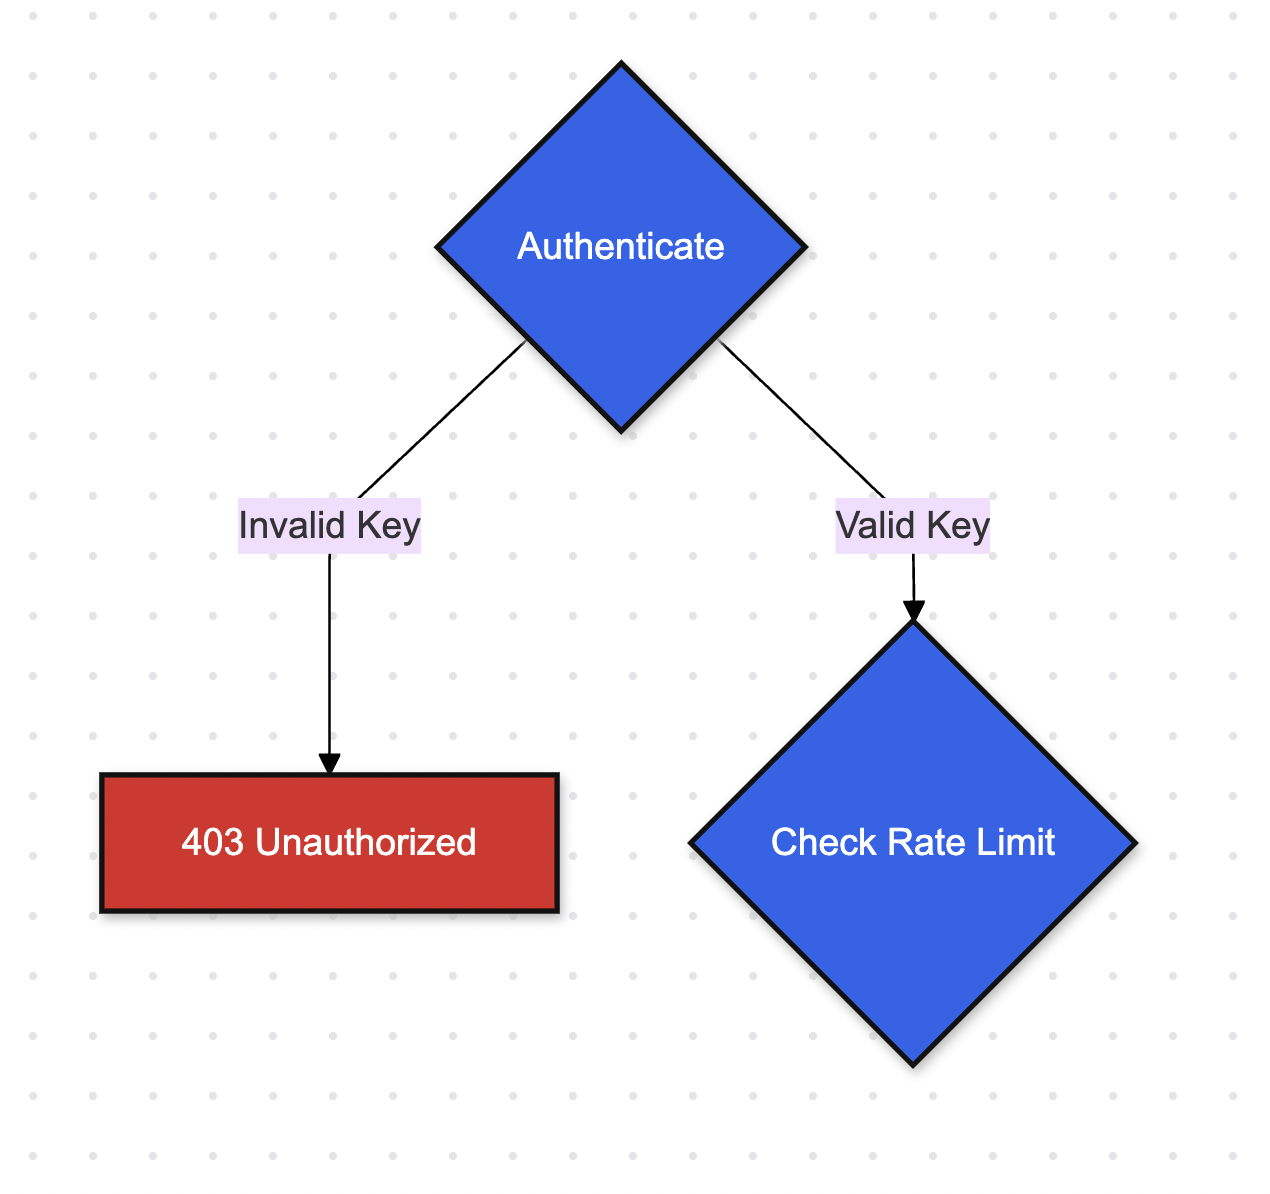
レート制限を説明するフロー図(パート2)

FastAPI を使った AI のプロダクション環境へのデプロイ

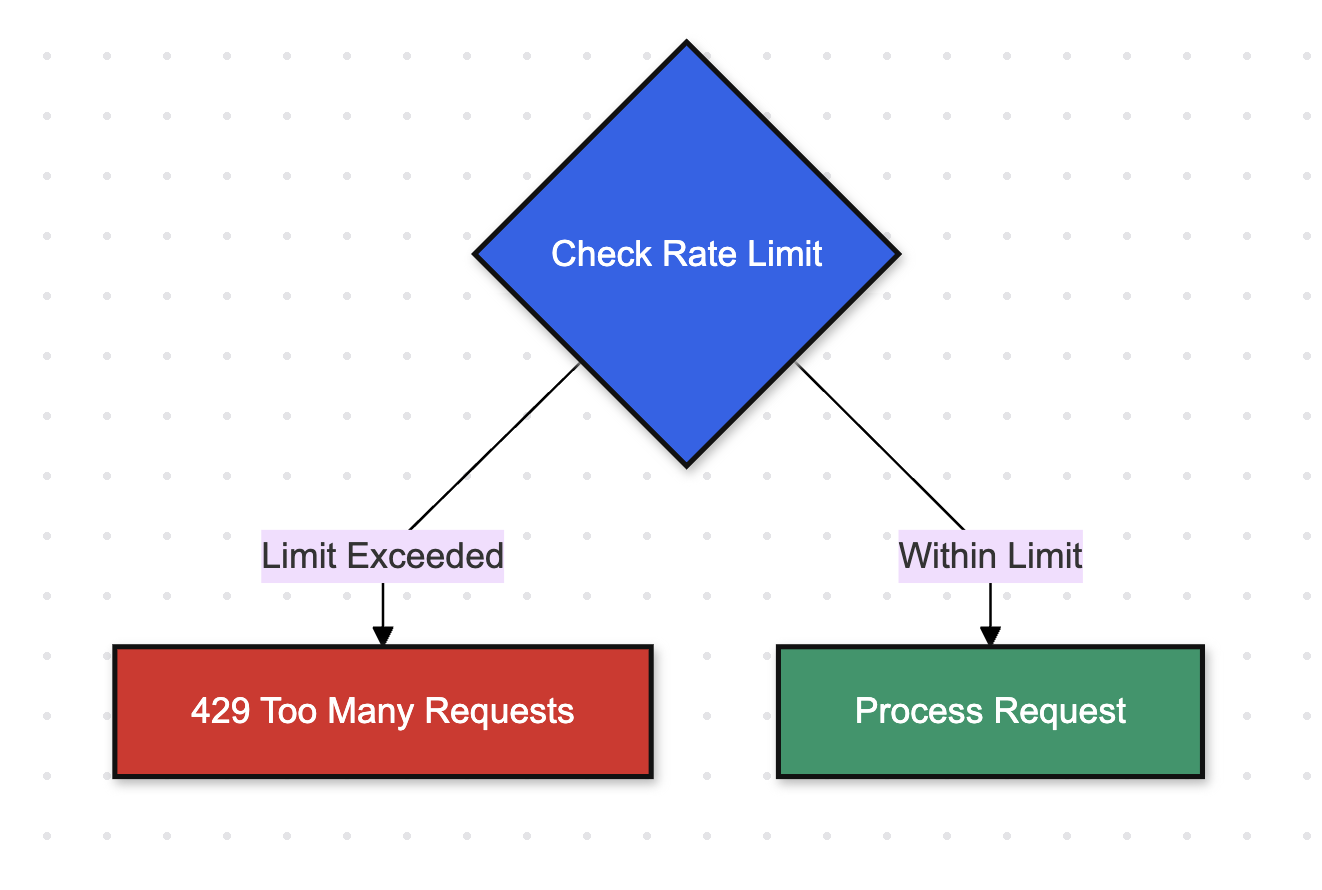
レート制限チェック

レート制限を説明するフロー図(パート3)

FastAPI を使った AI のプロダクション環境へのデプロイ

APIのセットアップ

from fastapi import FastAPI, Depends, HTTPException
from fastapi.security import APIKeyHeader
from pydantic import BaseModel

app = FastAPI()
model = SentimentAnalyzer(pkl_file_path)

API_KEY_HEADER = APIKeyHeader(name="X-API-Key")
API_KEY = "your-secret-key"
FastAPI を使った AI のプロダクション環境へのデプロイ

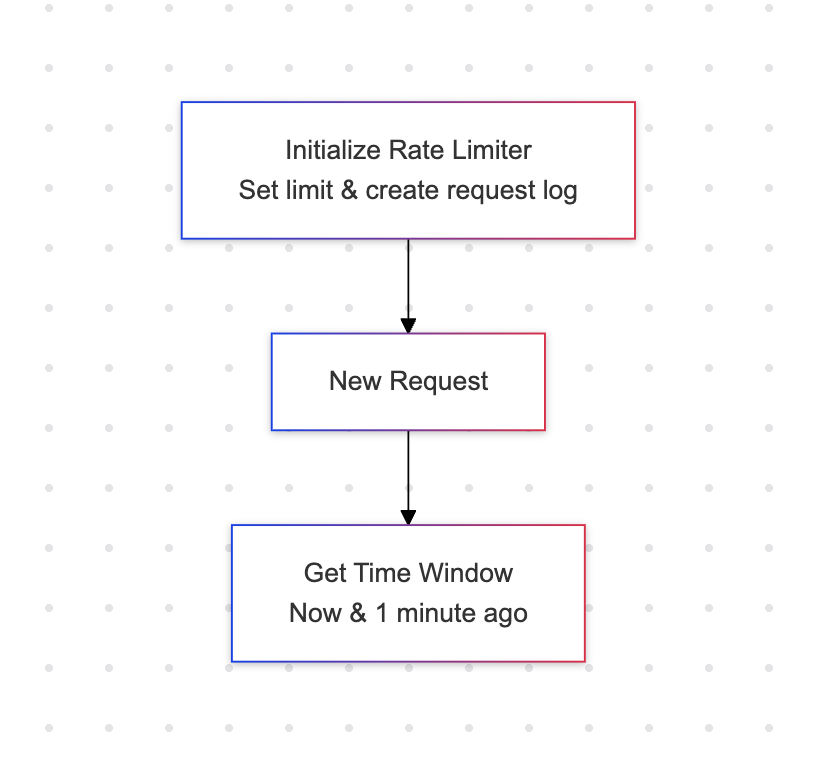
レートリミッターのロジック

from datetime import datetime, timedelta

class RateLimiter:
    def __init__(self, requests_per_min: int = 10):
        self.requests_per_min = requests_per_min
        self.requests = defaultdict(list)

def is_rate_limited( self, api_key: str ) -> tuple[bool, int]:

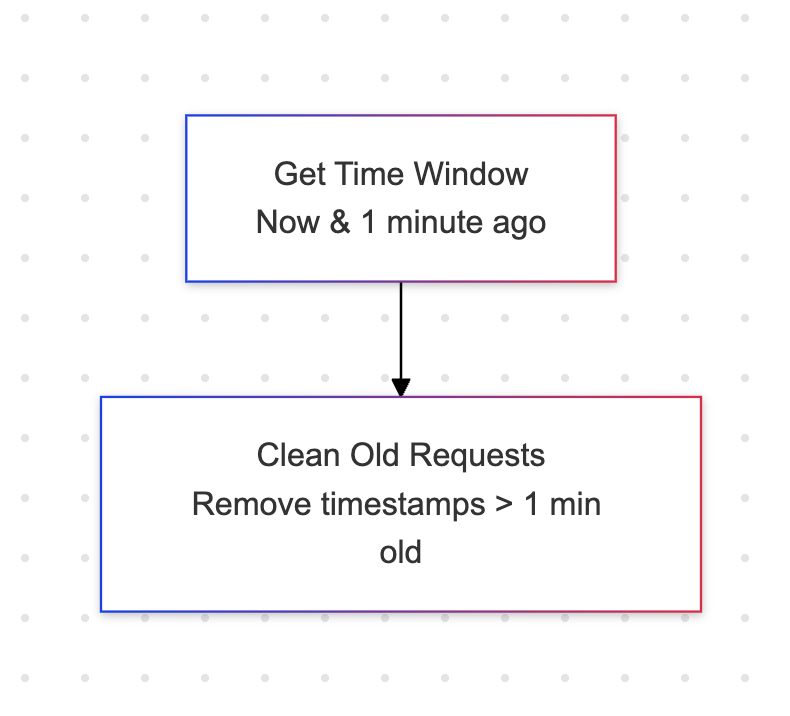
レート制限実装ロジックのフロー図(パート1)

FastAPI を使った AI のプロダクション環境へのデプロイ

古いリクエストの削除

from datetime import datetime, timedelta

class RateLimiter:
    def __init__(self, requests_per_min: int = 10):
        self.requests_per_min = requests_per_min
        self.requests = defaultdict(list)

def is_rate_limited( self, api_key: str ) -> tuple[bool, int]:
now = datetime.now() minute_ago = now - timedelta(minutes=1) self.requests[api_key] = [ req_time for req_time in self.requests[api_key] if req_time > minute_ago ]

レート制限を説明するフロー図(パート2)

FastAPI を使った AI のプロダクション環境へのデプロイ

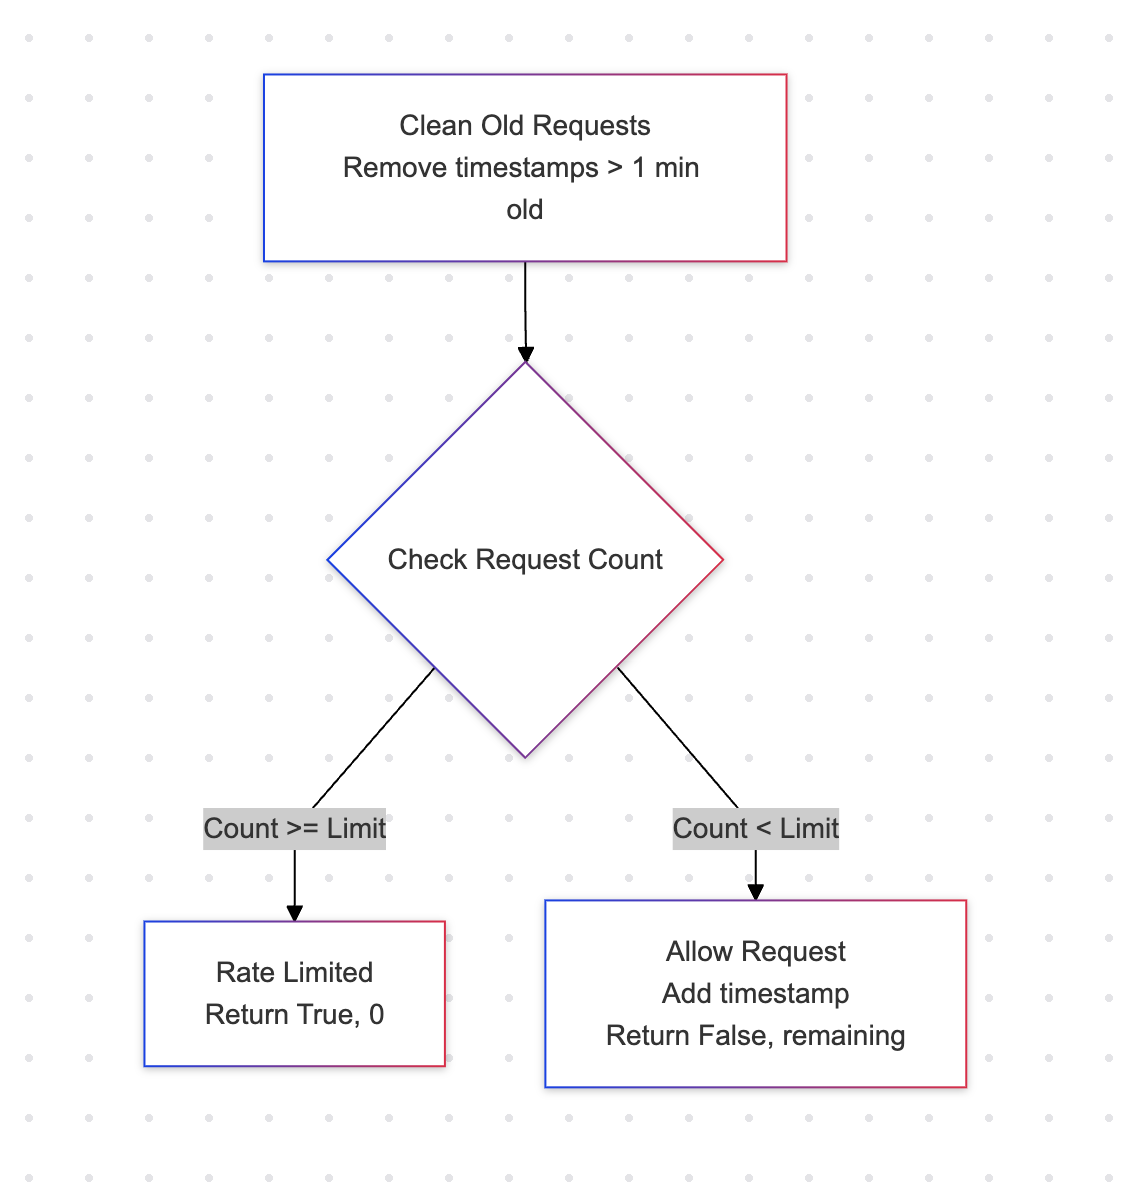
リクエスト数の確認

    def is_rate_limited(self, api_key: str) -> 
  tuple[bool, int]:
        now = datetime.now()
        minute_ago = now - timedelta(minutes=1)

self.requests[api_key] = [ req_time for req_time in self.requests[api_key] if req_time > minute_ago ]
recent_requests = len(self.requests[api_key]) if recent_requests >= self.requests_per_min: return True, 0 self.requests[api_key].append(now) return False

APIリクエスト数の確認を示す図:件数が上限以上であればtrueを返し、そうでなければfalseを返す。

FastAPI を使った AI のプロダクション環境へのデプロイ

レート制限チェックの追加

rate_limiter = RateLimiter(requests_per_minute=10)

def test_api_key(api_key: str = Depends(API_KEY_HEADER)): if api_key != API_KEY: raise HTTPException( status_code=403, detail="Invalid API key" ) is_limited, _ = rate_limiter.is_rate_limited(api_key) if is_limited: raise HTTPException( status_code=429, detail="Rate limit exceeded. Please try again later." ) return api_key
FastAPI を使った AI のプロダクション環境へのデプロイ

エンドポイントへのレート制限の適用

@app.post("/predict")
def predict_sentiment(
    request: SentimentRequest,
    api_key: str = Depends(test_api_key)
):
    result = sentiment_model(request.text)

    _, requests_remaining = 
           rate_limiter.is_rate_limited(api_key)

    return {
        "text": request.text,
        "sentiment": result[0]["label"].lower(),
        "confidence": result[0]["score"],
        "requests_remaining": requests_remaining
    }

11回リクエストを送信:

curl -X POST "http://localhost:8000/predict" \
     -H "Content-Type: application/json" \
     -H "X-API-Key: your-secret-key" \
     -d '{"text": "I love this product"}'

出力:

{"detail":"Rate limit exceeded. 
           Please try again later."}
FastAPI を使った AI のプロダクション環境へのデプロイ

練習しましょう!

FastAPI を使った AI のプロダクション環境へのデプロイ

Preparing Video For Download...