k近傍法による補完

R による欠損データの補完処理

Michal Oleszak

Machine Learning Engineer

k近傍法による補完
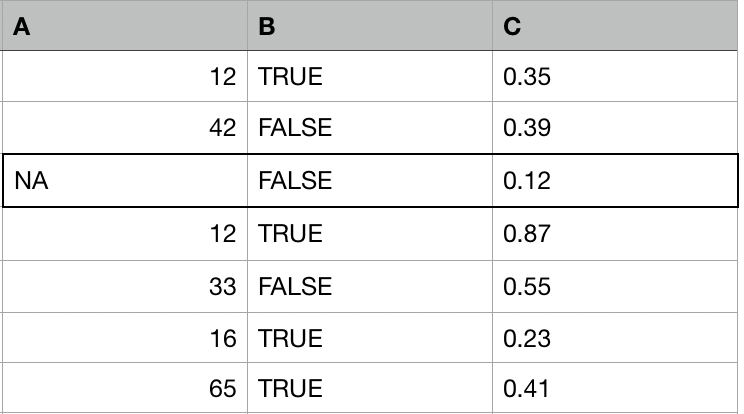
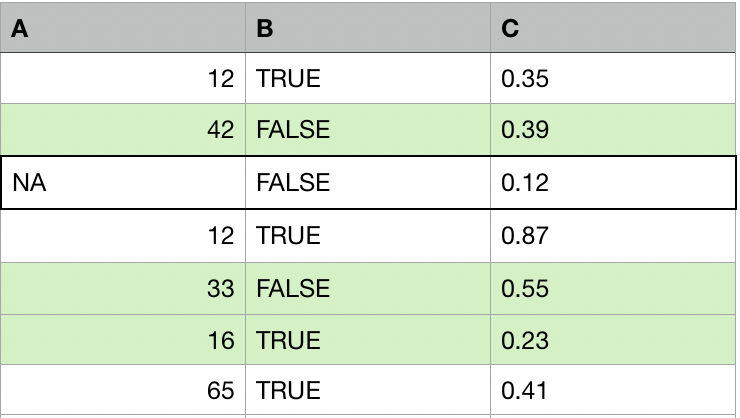
A列、B列、C列の3列からなるテーブル。A列に欠損値が1つある。

R による欠損データの補完処理

k近傍法による補完

A列、B列、C列の3列からなるテーブル。A列に欠損値が1つあり、欠損値を含まない3行がカラーでハイライトされている。

欠損値を持つ各観測値に対して:

  1. その観測値に最も類似した k 個の観測値(ドナー、近傍)を見つける。
R による欠損データの補完処理

k近傍法による補完

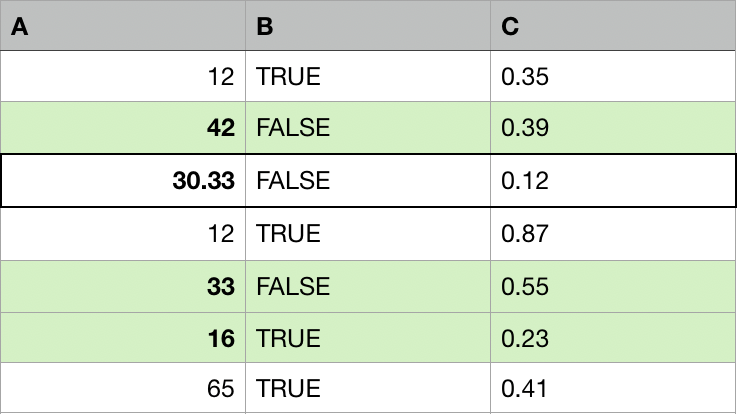
A列、B列、C列の3列からなるテーブル。欠損値を含まない3行がカラーでハイライトされており、A列の欠損値はハイライト行の同列の値の平均で置き換えられている。

欠損値を持つ各観測値に対して:

  1. その観測値に最も類似した k 個の観測値(ドナー、近傍)を見つける。
  2. 欠損値を k 個のドナーの集計値(平均、中央値、最頻値)で置き換える。
R による欠損データの補完処理

距離指標

2つの観測値 a と b の距離:

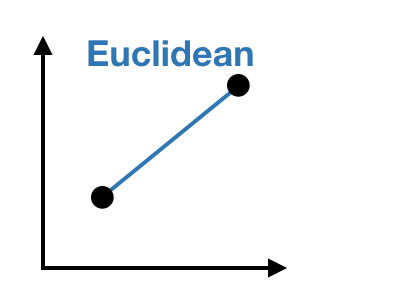
n 個の数値変数に対するユークリッド距離:

$\sqrt{\Sigma_{i=1}^{n} (a_i - b_i)^{2}}$

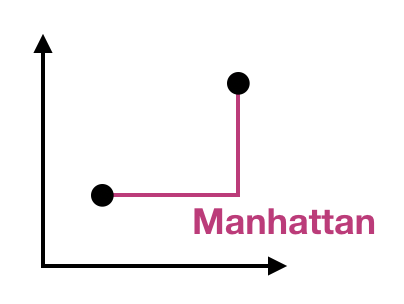
f 個の因子変数に対するマンハッタン距離:

$\Sigma_{i=1}^{f} |a_i - b_i|$

c 個のカテゴリ変数に対するハミング距離:

$\Sigma_{i=1}^{c} I(a_i \neq b_i)$

2点を直線で結んだ座標系。

2点を垂直な2本の線で結んだ座標系。2点は長方形の対角に位置するように見える。

R による欠損データの補完処理

ゴワー距離

数値型、因子型、カテゴリ型の3種類の変数をそれぞれ異なる色でハイライトしたデータフレームのサンプル。

R による欠損データの補完処理

ゴワー距離

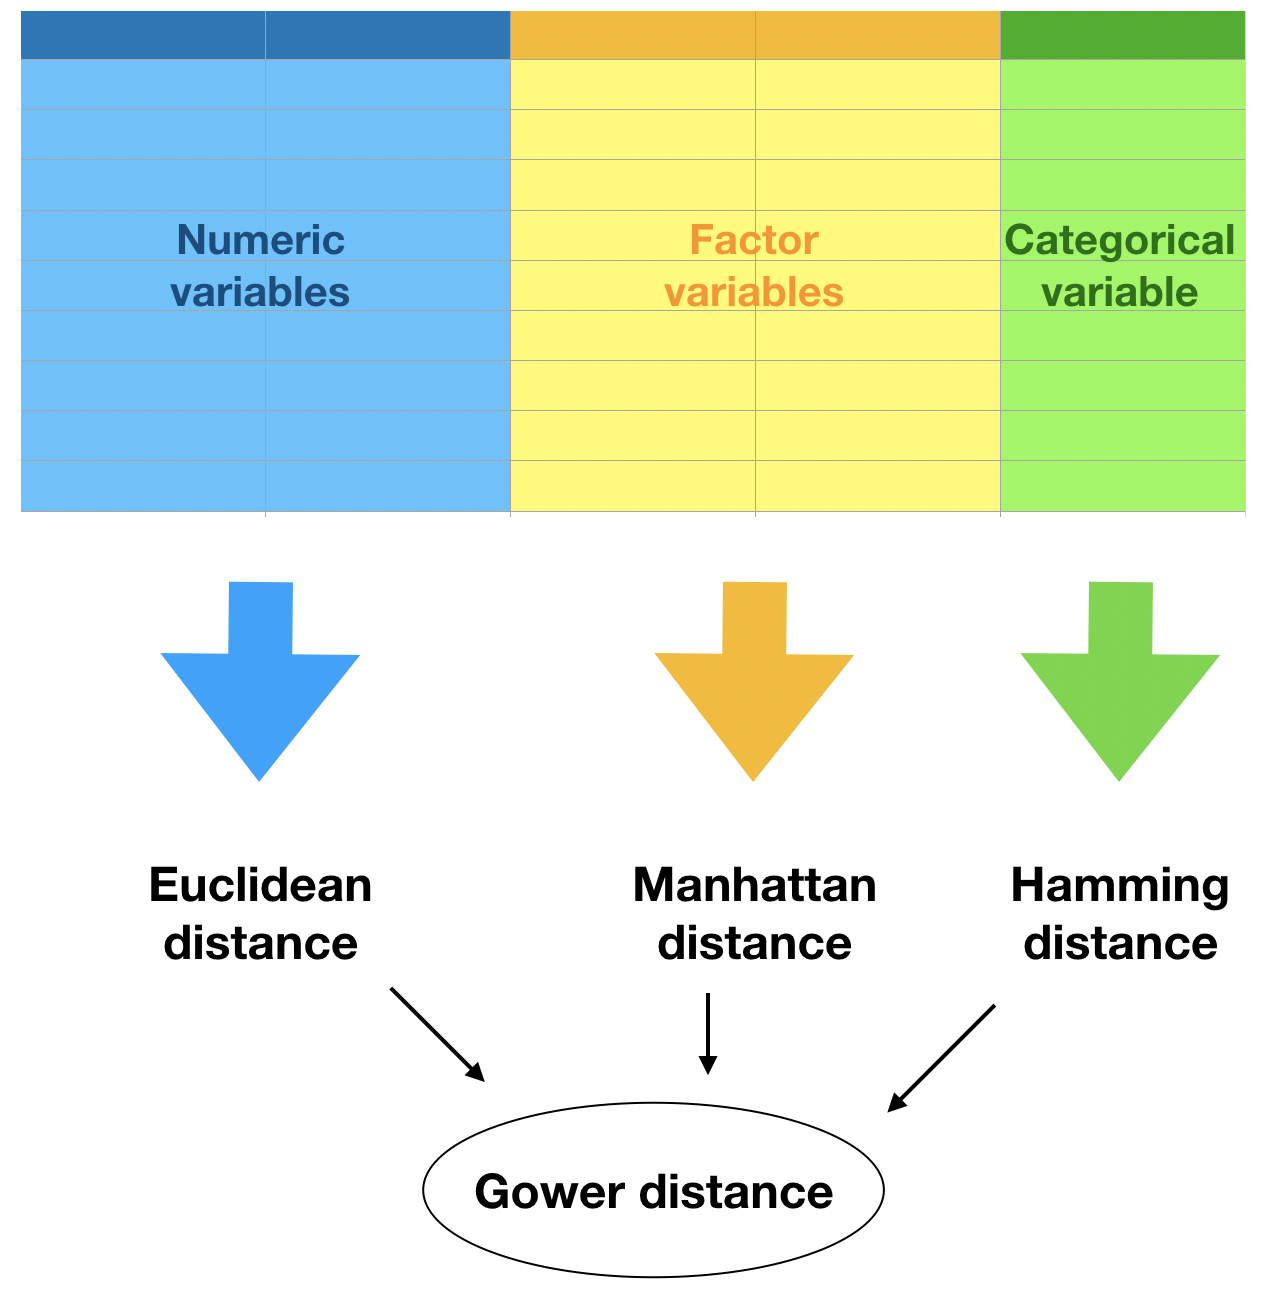
数値型、因子型、カテゴリ型の3種類の変数をそれぞれ異なる色でハイライトしたデータフレームのサンプル。各変数型には矢印があり、それぞれユークリッド距離、マンハッタン距離、ハミング距離を指している。3つの距離指標はゴワー距離を示す楕円に向かっている。

R による欠損データの補完処理

kNN補完の実践

library(VIM)
nhanes_imp <- kNN(nhanes, k = 5, variable = c("TotChol", "Pulse"))
head(nhanes_imp)
  Age Gender Weight Height Diabetes TotChol Pulse PhysActive TotChol_imp Pulse_imp
1  16   male   73.2  172.0    FALSE    3.00    76       TRUE       FALSE     FALSE
2  17   male   72.3  176.0    FALSE    2.61    74       TRUE       FALSE     FALSE
3  12   male   57.7  158.9    FALSE    4.27    80       TRUE       FALSE     FALSE
4  16   male   88.9  183.3    FALSE    3.62    58       TRUE       FALSE     FALSE
5  13 female   45.1  157.6    FALSE    2.66    92       TRUE       FALSE     FALSE
6  16 female   48.7  158.4    FALSE    4.32    58      FALSE       FALSE     FALSE
R による欠損データの補完処理

ドナーへの重み付け

  • 選択された k 個の近傍のうち、観測値との類似度はそれぞれ異なります。
  • 値を集計する際、より近い近傍に大きな重みを付けることが望ましい場合があります。
  • 各近傍までの距離の逆数を重みとした加重平均で集計します。
  • これは数値変数の補完にのみ使用できます。
nhanes_imp <- nhanes %>% 
  kNN(variable = c("TotChol", "Pulse"),
      k = 5,
      numFun = weighted.mean,
      weightDist = TRUE)
R による欠損データの補完処理

変数の並べ替え

  • kNNアルゴリズムは変数を1つずつループして補完します。
  • その都度、観測値間の距離が計算されます。
  • 最初の変数に欠損値が多い場合、2番目の変数の距離計算は補完済みの値を多く使用することになります。
  • kNNを実行する前に、欠損値の数が少ない順に変数を並べ替えることが推奨されます。
R による欠損データの補完処理

変数の並べ替えの実践

vars_by_NAs <- nhanes %>% 
  is.na() %>%
  colSums() %>%
  sort(decreasing = FALSE) %>% 
  names()
nhanes_imp <- nhanes %>% 
  select(vars_by_NAs) %>% 
  kNN(k = 5)
R による欠損データの補完処理

kNN補完を練習しましょう!

R による欠損データの補完処理

Preparing Video For Download...