Parallel computing là gì

Introduction to Data Engineering

Vincent Vankrunkelsven

Data Engineer, DataCamp

Ý tưởng đằng sau parallel computing
Nền tảng của các công cụ xử lý dữ liệu hiện đại

  • Bộ nhớ
  • Sức mạnh xử lý

Ý tưởng

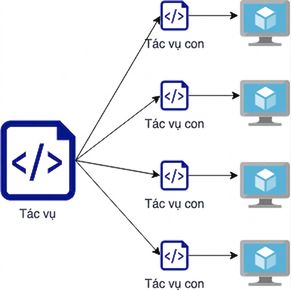
  • Chia tác vụ thành các tác vụ nhỏ
  • Phân phối các tác vụ nhỏ lên nhiều máy tính
  • Phối hợp để hoàn thành tác vụ

Sơ đồ chia tác vụ thành các tác vụ nhỏ

Introduction to Data Engineering

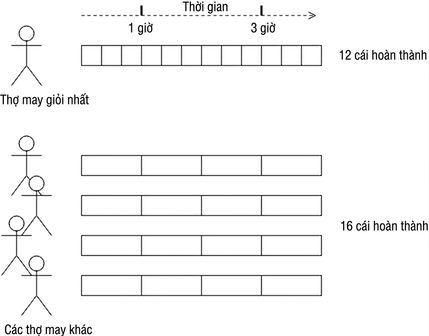
Tiệm may

Sơ đồ minh họa tiệm may

Vận hành một tiệm may

Mục tiêu: 100 áo sơ mi

  • Thợ giỏi nhất hoàn thành 1 áo / 20 phút
  • Các thợ khác 1 áo / 1 giờ


Nhiều thợ cùng làm > thợ giỏi nhất

Introduction to Data Engineering

Lợi ích của parallel computing

  • Sức mạnh xử lý
  • Bộ nhớ: phân vùng dữ liệu


Chip bộ nhớ RAM: Hình ảnh chip bộ nhớ RAM

Introduction to Data Engineering

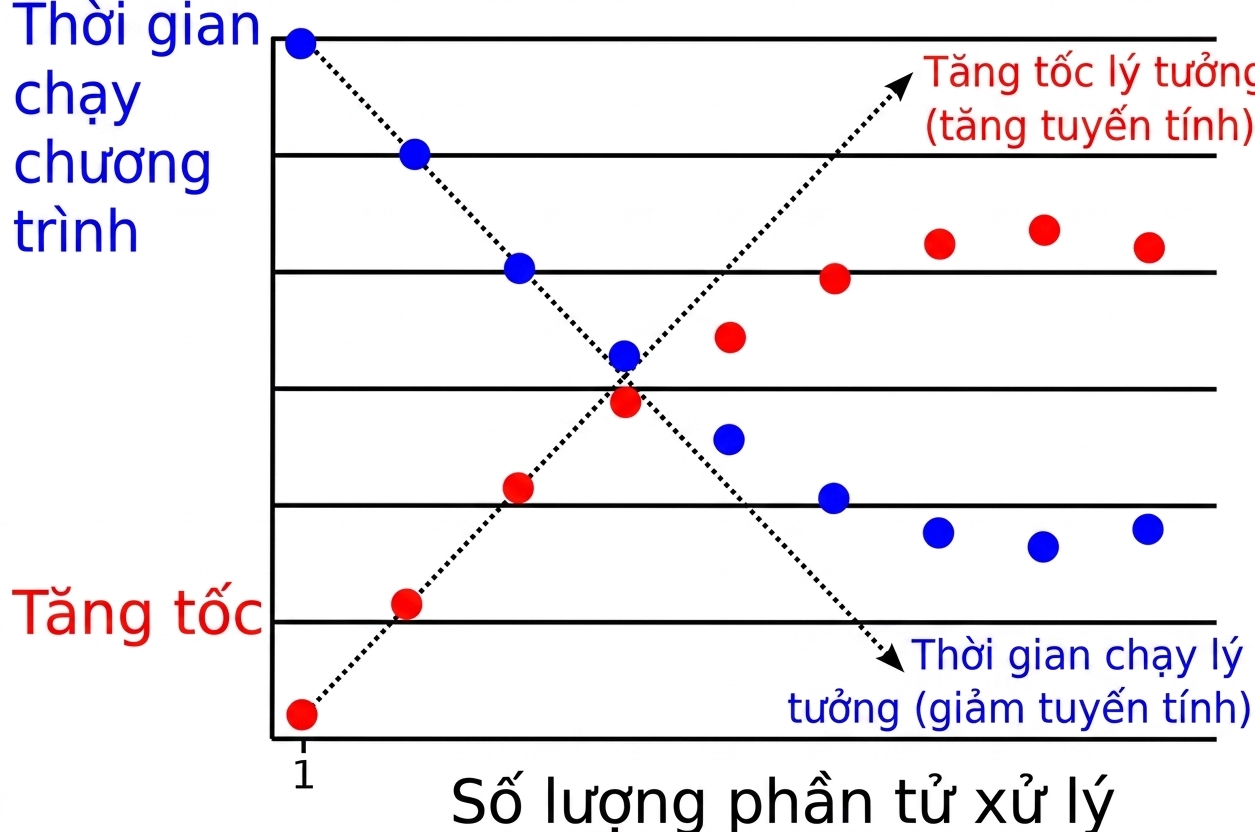
Rủi ro của parallel computing

Chi phí phụ do trao đổi


  • Tác vụ cần đủ lớn
  • Cần nhiều đơn vị xử lý


Chậm lại khi chạy song song: Biểu đồ thể hiện hiện tượng chậm lại khi chạy song song

Introduction to Data Engineering

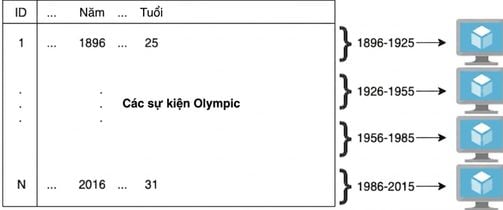
Một ví dụ


Sơ đồ minh họa ví dụ về các môn thi Olympic

Introduction to Data Engineering

multiprocessing.Pool

from multiprocessing import Pool

def take_mean_age(year_and_group): year, group = year_and_group return pd.DataFrame({"Age": group["Age"].mean()}, index=[year])
with Pool(4) as p: results = p.map(take_mean_age, athlete_events.groupby("Year"))
result_df = pd.concat(results)
Introduction to Data Engineering

dask


import dask.dataframe as dd

# Partition dataframe into 4 athlete_events_dask = dd.from_pandas(athlete_events, npartitions = 4)
# Run parallel computations on each partition result_df = athlete_events_dask.groupby('Year').Age.mean().compute()
Introduction to Data Engineering

Cùng luyện tập nào!

Introduction to Data Engineering

Preparing Video For Download...