Parametrický odhad

Kvantitativní řízení rizik v Pythonu

Jamsheed Shorish

Computational Economist

Třída rozdělení

  • Rozdělení ztrát: není přesně známo
  • Třída možných rozdělení?
    • Předpokládejme třídu rozdělení $f(x; \theta)$
    • $x$ je ztráta (náhodná proměnná)
    • $\theta$ je vektor neznámých parametrů
  • Příklad: normální rozdělení
    • Parametry: $\theta = (\mu, \sigma)$, střední hodnota $\mu$ a směrodatná odchylka $\sigma$
  • Parametrický odhad: nalezení nejlepšího $\theta^\star$ na základě dat
  • Rozdělení ztrát: $f(x,\theta^\star)$
Kvantitativní řízení rizik v Pythonu

Přizpůsobení rozdělení

  • Přizpůsobení rozdělení podle kritéria minimalizace chyby
    • Příklad: scipy.stats.norm.fit(), přizpůsobení normálního rozdělení datům
      • Výsledek: optimálně odhadnutá střední hodnota a směrodatná odchylka
  • Výhody:
    • Lze vizualizovat rozdíl mezi daty a odhadem pomocí histogramu
    • Lze provést testy shody rozdělení s daty
Kvantitativní řízení rizik v Pythonu

Shoda rozdělení s daty

  • Jak dobře odhadnuté rozdělení odpovídá datům?
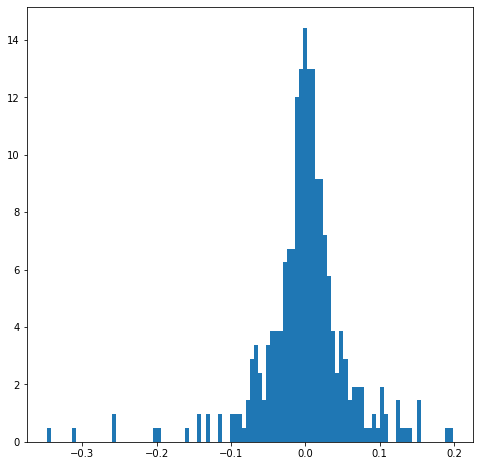
  • Vizualizace: histogram ztrát portfolia

histogram ztrát

Kvantitativní řízení rizik v Pythonu

Shoda rozdělení s daty

  • Jak dobře odhadnuté rozdělení odpovídá datům?
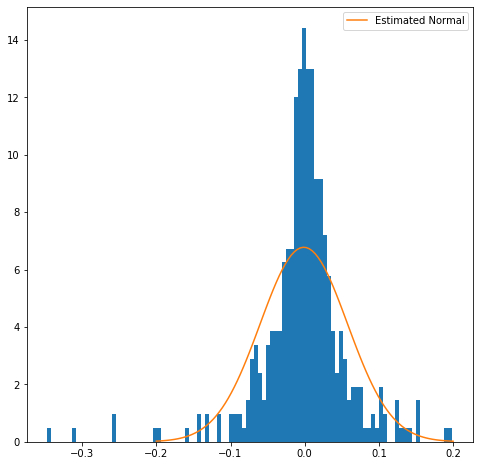
  • Vizualizace: histogram ztrát portfolia
  • Normální rozdělení pomocí norm.fit()

histogram ztrát s normálním rozdělením

Kvantitativní řízení rizik v Pythonu

Shoda rozdělení s daty

  • Jak dobře odhadnuté rozdělení odpovídá datům?
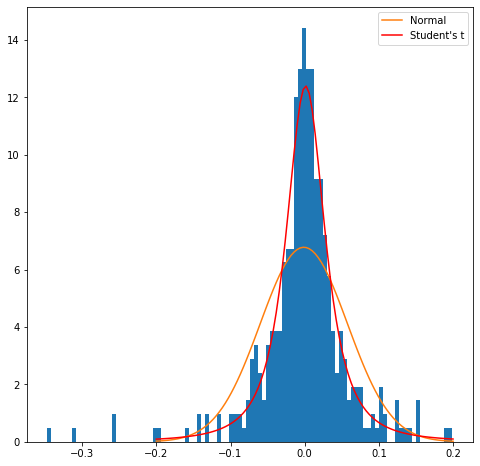
  • Vizualizace: histogram ztrát portfolia
  • Příklad:
    • Normální rozdělení pomocí norm.fit()
    • Studentovo t-rozdělení pomocí t.fit()
    • Asymetrický histogram?

histogram ztrát s normálním rozdělením

Kvantitativní řízení rizik v Pythonu

Anderson-Darlingův test

  • Statistický test shody rozdělení s daty
    • Nulová hypotéza: data mají normální rozdělení
    • Testová statistika zamítá normální rozdělení, je-li větší než critical_values
  • Import scipy.stats.anderson
  • Výpočet výsledku testu na datech loss
from scipy.stats import anderson

anderson(loss)
AndersonResult(statistic=11.048641503898523,
critical_values=array([0.57 , 0.649, 0.779, 0.909, 1.081]),
significance_level=array([15. , 10. ,  5. ,  2.5,  1. ]))
Kvantitativní řízení rizik v Pythonu

Šikmost

  • Šikmost: míra asymetrie rozdělení dat
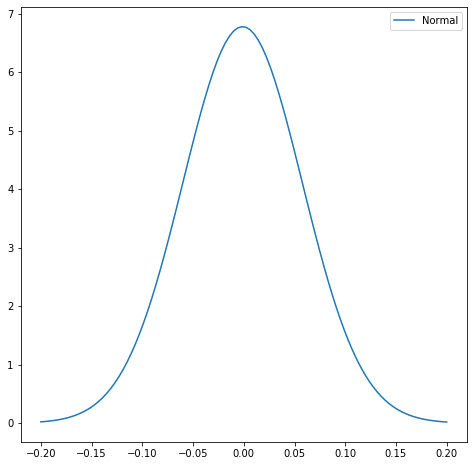
    • Normální rozdělení: symetrické

normální rozdělení

Kvantitativní řízení rizik v Pythonu

Šikmost

  • Šikmost: míra asymetrie rozdělení dat
    • Normální rozdělení: symetrické
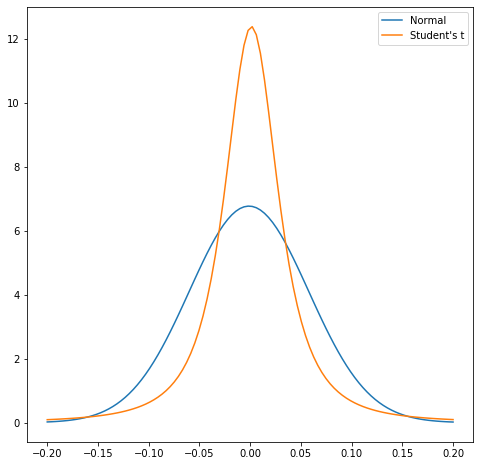
    • Studentovo t-rozdělení: symetrické

normální a t-rozdělení

Kvantitativní řízení rizik v Pythonu

Šikmost

  • Šikmost: míra asymetrie rozdělení dat
    • Normální rozdělení: symetrické
    • Studentovo t-rozdělení: symetrické
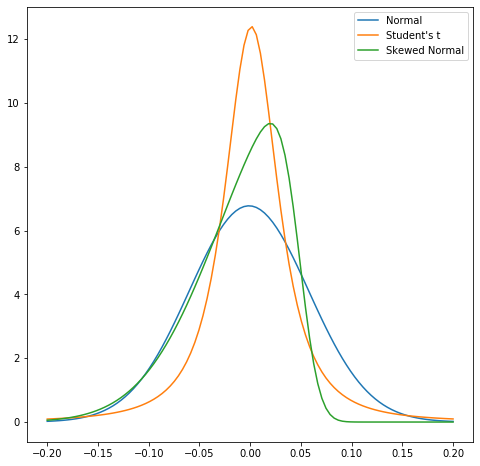
  • Zešikmené normální rozdělení: asymetrické
    • Obsahuje normální rozdělení jako speciální případ
    • Vhodné pro data portfolia, kde jsou např. ztráty častější než zisky
    • Dostupné v scipy.stats jako skewnorm

normální, t-rozdělení a zešikmené normální rozdělení

Kvantitativní řízení rizik v Pythonu

Test šikmosti

  • Test odchylky dat od symetrického rozdělení: scipy.stats.skewtest
  • Nulová hypotéza: žádná šikmost
  • Import skewtest z scipy.stats
  • Výpočet výsledku testu na datech loss
    • Statisticky významný výsledek => použijte třídu rozdělení se šikmostí
from scipy.stats import skewtest

skewtest(loss)
SkewtestResult(statistic=-7.786120875514511,
pvalue=6.90978472959861e-15)
Kvantitativní řízení rizik v Pythonu

Pojďme si procvičit!

Kvantitativní řízení rizik v Pythonu

Preparing Video For Download...