Strukturální zlomy
Kvantitativní řízení rizik v Pythonu

Jamsheed Shorish
Computational Economist
Riziko a rozdělení
- Nástroje pro řízení rizik
- Zmírňování rizik: MPT
- Měření rizik: VaR, CVaR
- Riziko: rozptyl, volatilita
- Rozptyl (směrodatná odchylka) jako definice rizika
- Vztah mezi rizikem a rozdělením rizikových faktorů jako náhodných veličin
Stacionarita
- Předpoklad: rozdělení je v čase konstantní
- Neměnné rozdělení = stacionární
- Eficientní hranice v období globální finanční krize
- Není stacionární
- Odhadovací techniky vyžadují stacionaritu
- Historická: neznámé stacionární rozdělení z minulých dat
- Parametrická: předpokládaná třída stacionárního rozdělení
- Monte Carlo: předpokládané stacionární rozdělení pro náhodné výběry
Strukturální zlomy
- Nestacionární => rozdělení se může v čase měnit
- Předpokládáme konkrétní časové body změny
- Rozdělení dat na dílčí období
- V každém dílčím období předpokládáme stacionaritu
- Strukturální zlom(y): bod(y) změny
- Změna „trendu" průměru nebo volatility dat
Příklad: Růst populace Číny
- Zkoumané období: 1950–2019
- Trend je přibližně lineární...
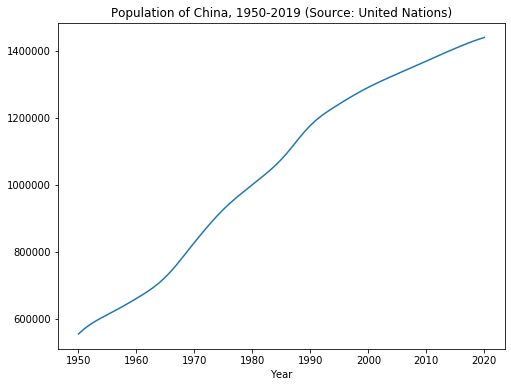
Příklad: Růst populace Číny
- Zkoumané období: 1950–2019
- Trend je přibližně lineární...
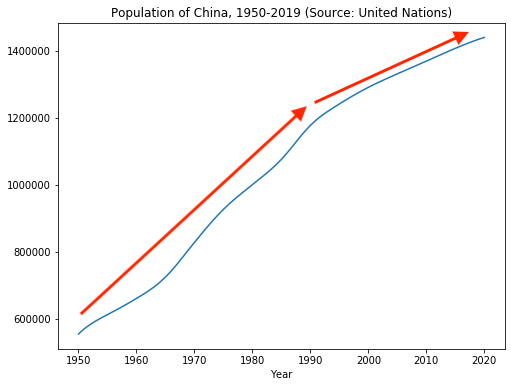
- ...ale od roku 1990 se zpomaluje
- Možný strukturální zlom kolem roku 1990.
- Naznačuje změnu rozdělení čistého přírůstku obyvatelstva (narození – úmrtí)
- Možné příčiny: vládní politika, životní úroveň atd.
Chowův test
- Předchozí příklad: vizuální důkaz strukturálního zlomu
- Kvantifikace: statistická míra
- Chowův test:
- Test existence strukturálního zlomu při lineárním modelu
- Nulová hypotéza: žádný zlom
- Vyžaduje tři OLS regrese
- Regrese za celé období
- Dvě regrese: před a _po_ zlomu
- Výpočet součtu čtverců reziduí
- Testová statistika má „F" rozdělení
Chowův test v Pythonu
- Hypotéza: strukturální zlom v roce 1990 pro populaci Číny
- Předpokládáme lineární „faktorový model": $$\log(\text{Population}_t) = \alpha + \beta * \text{Year}_t + u_t$$
- OLS regrese pomocí objektu
OLSzstatsmodelsza celé období 1950–2019- Načtení součtu čtverců reziduí
res.ssr
- Načtení součtu čtverců reziduí
import statsmodels.api as sm res = sm.OLS(log_pop, year).fit()print('SSR 1950-2019: ', res.ssr)
SSR 1950-2019: 0.29240576138055463
Chowův test v Pythonu
- Rozdělení 1950–2019 na dílčí období 1950–1989 a 1990–2019
- OLS regrese pro každé dílčí období
- Načtení
res_before.ssrares_after.ssr
- Načtení
pop_before = log_pop.loc['1950':'1989']; year_before = year.loc['1950':'1989']; pop_after = log_pop.loc['1990':'2019']; year_after = year.loc['1990':'2019'];res_before = sm.OLS(pop_before, year_before).fit() res_after = sm.OLS(pop_after, year_after).fit()print('SSR 1950-1989: ', res_before.ssr) print('SSR 1990-2019: ', res_after.ssr)
SSR 1950-1989: 0.011741113017411783
SSR 1990-2019: 0.0013717593339608077
Chowův test v Pythonu
- Výpočet testové statistiky Chowova testu s F-rozdělením
- Výpočet čitatele
- k = 2 stupně volnosti = 2 koeficienty OLS $\alpha$, $\beta$
- Výpočet jmenovatele
- 66 stupňů volnosti = celkový počet datových bodů (70) – 2*k
- Výpočet čitatele
numerator = (ssr_total - (ssr_before + ssr_after)) / 2denominator = (ssr_before + ssr_after) / 66chow_test = numerator / denominator print("Chow test statistic: ", chow_test, "; Critical value, 99.9%: ", 7.7)
Chow test statistic: 702.8715822890057; Critical value, 99.9%: 7.7
Pojďme si procvičit!
Kvantitativní řízení rizik v Pythonu

