ANOVA

Inference for Numerical Data in R

Mine Cetinkaya-Rundel

Associate Professor of the Practice, Duke University
Běžci

Inference for Numerical Data in R

ANOVA: skóre slovní zásoby vs. subjektivně vnímaná společenská třída

$H_0$: Průměrné skóre slovní zásoby je stejné napříč všemi společenskými třídami, $\mu_{lower} = \mu_{working} = \mu_{middle} = \mu_{upper}$.

$H_A$: Průměrné skóre slovní zásoby se liší alespoň u jednoho páru společenských tříd.

Inference for Numerical Data in R

Rozklad variability

Celková variabilita skóre slovní zásoby:

  • Variabilita přisuzovaná rozdílům mezi společenskými třídami – variabilita mezi skupinami
  • Variabilita přisuzovaná všem ostatním faktorům – variabilita uvnitř skupin
Inference for Numerical Data in R

Výstup ANOVA

library(broom)

aov(wordsum ~ class, gss) %>%
  tidy()
term        df     sumsq    meansq   statistic p.value
class        3   236.5644  78.854810  21.73467       0
Residuals  791  2869.8003   3.628066        NA      NA
Inference for Numerical Data in R

Součet čtverců

term        df     sumsq    meansq   statistic p.value
class        3   236.5644  78.854810  21.73467       0
Residuals  791  2869.8003   3.628066        NA      NA
  • $SST = 236.5644 + 2869.8003 = 3106.365$ – měří celkovou variabilitu závislé proměnné
  • Výpočet je podobný rozptylu (avšak bez dělení velikostí vzorku)
  • Procento vysvětlené variability = $\frac{236.5644}{3106.365} = 7{,}6\%$
Inference for Numerical Data in R

F-statistika

term        df     sumsq    meansq   statistic p.value
class        3   236.5644  78.854810  21.73467       0
Residuals  791  2869.8003   3.628066        NA      NA

F-statistika = 21.73467 = $\frac{between~group~var}{within~group~var}$
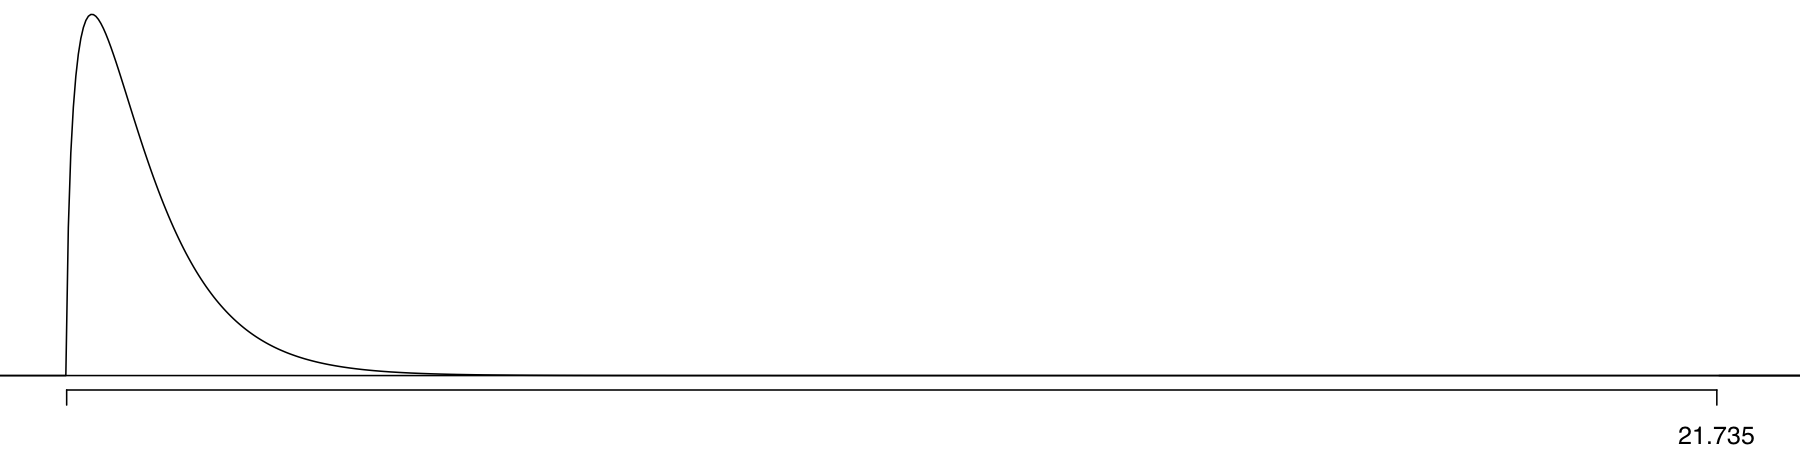
F-statistika a p-hodnota

Inference for Numerical Data in R

Pojďme si procvičit!

Inference for Numerical Data in R

Preparing Video For Download...