Inference for Numerical Data in R
Mine Cetinkaya-Rundel
Associate Professor of the Practice, Duke University
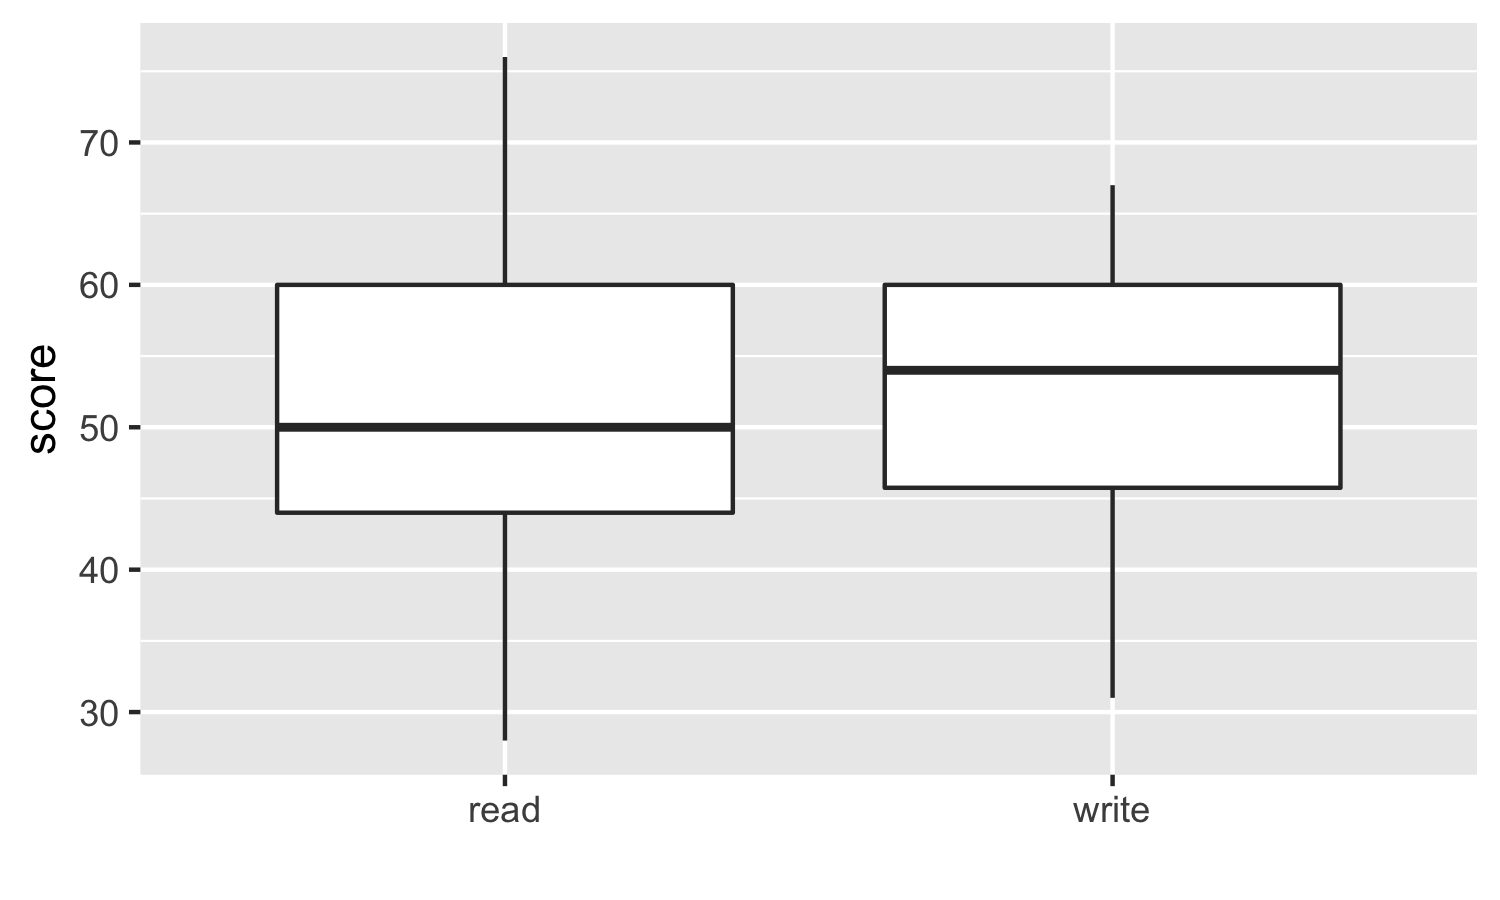
Z průzkumu High School and Beyond bylo náhodně vybráno 200 pozorování. Stejní studenti absolvovali testy ze čtení a psaní. Na první pohled: v čem jsou rozdělení skóre podobná a v čem se liší?

Lze skóre ze čtení a psaní pro daného studenta považovat za nezávislá?
Pravděpodobně ne!
Pokud mají dvě sady pozorování tuto zvláštní závislost (nejsou nezávislá), označují se jako párová.
Při analýze párových dat je vhodné pracovat s rozdílem hodnot každého páru:
diff = read − write.
| student | read | write | diff |
|---|---|---|---|
| 1 | 57 | 52 | 5 |
| 2 | 68 | 59 | 9 |
| 3 | 44 | 33 | 11 |
| ... | ... | ... | ... |
| 200 | 63 | 65 | -2 |
Sestavte 95% interval spolehlivosti pro střední hodnotu rozdílu průměrných skóre ze čtení a psaní.
t.test(hsb2$diff, conf.level = 0.95)
Sestavte 95% interval spolehlivosti pro střední hodnotu rozdílu průměrných skóre ze čtení a psaní.
t.test(hsb2$diff, conf.level = 0.95)
One Sample t-test
data: hsb2$diff
t = -0.86731, df = 199, p-value = 0.3868
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
-1.7841424 0.6941424
sample estimates:
mean of x
-0.545
95% IS pro střední rozdíl skóre ze čtení a psaní (čtení − psaní) je (−1,78; 0,69)
vs.
S 95% jistotou lze říci, že průměrné skóre ze čtení je o 1,78 bodu nižší až o 0,69 bodu vyšší než průměrné skóre z psaní.
Inference for Numerical Data in R