Vícenásobná imputace pomocí bootstrappingu

Práce s chybějícími daty pomocí imputace v R

Michal Oleszak

Machine Learning Engineer

Nejistota při imputaci

  • Imputace je obvykle prvním krokem před analýzou nebo modelováním.
  • Chybějící hodnoty jsou odhadnuty s určitou nejistotou.
  • Tato nejistota by měla být zohledněna v každé analýze provedené na imputovaných datech.
Záhlaví titulní strany článku Ranjita Lalla s názvem „How Multiple Imputation Makes a Difference".

Téměř v polovině studií klíčové výsledky zmizí

Práce s chybějícími daty pomocí imputace v R

Bootstrap

Bootstrapping = výběr řádků s opakováním pro získání dat původní velikosti
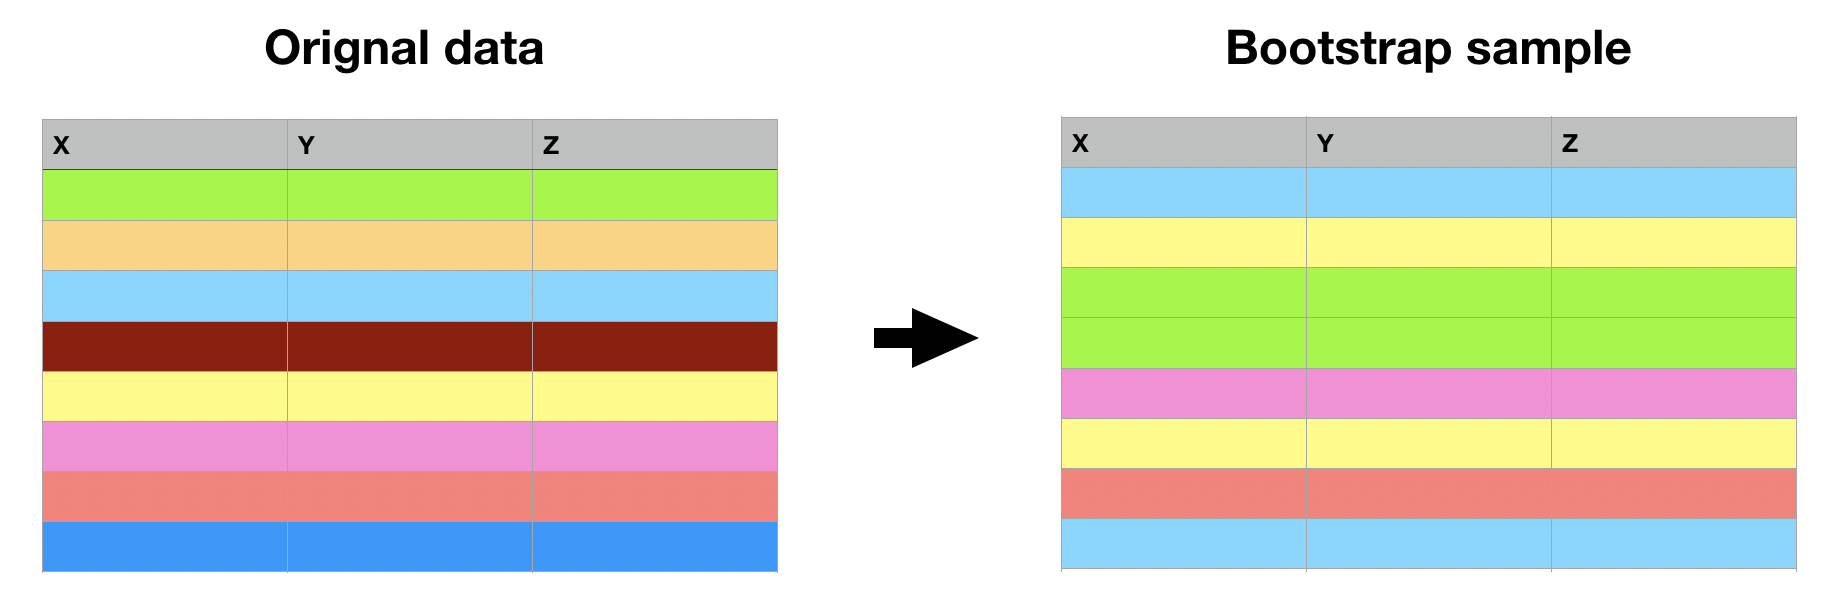
Dva schematické datové rámce. Levý, označený „původní data", má každý řádek v jiné barvě. Pravý, označený „bootstrapový vzorek", obsahuje některé řádky z původních dat vícekrát, jiné chybí.

Práce s chybějícími daty pomocí imputace v R

Vícenásobná imputace pomocí bootstrappingu
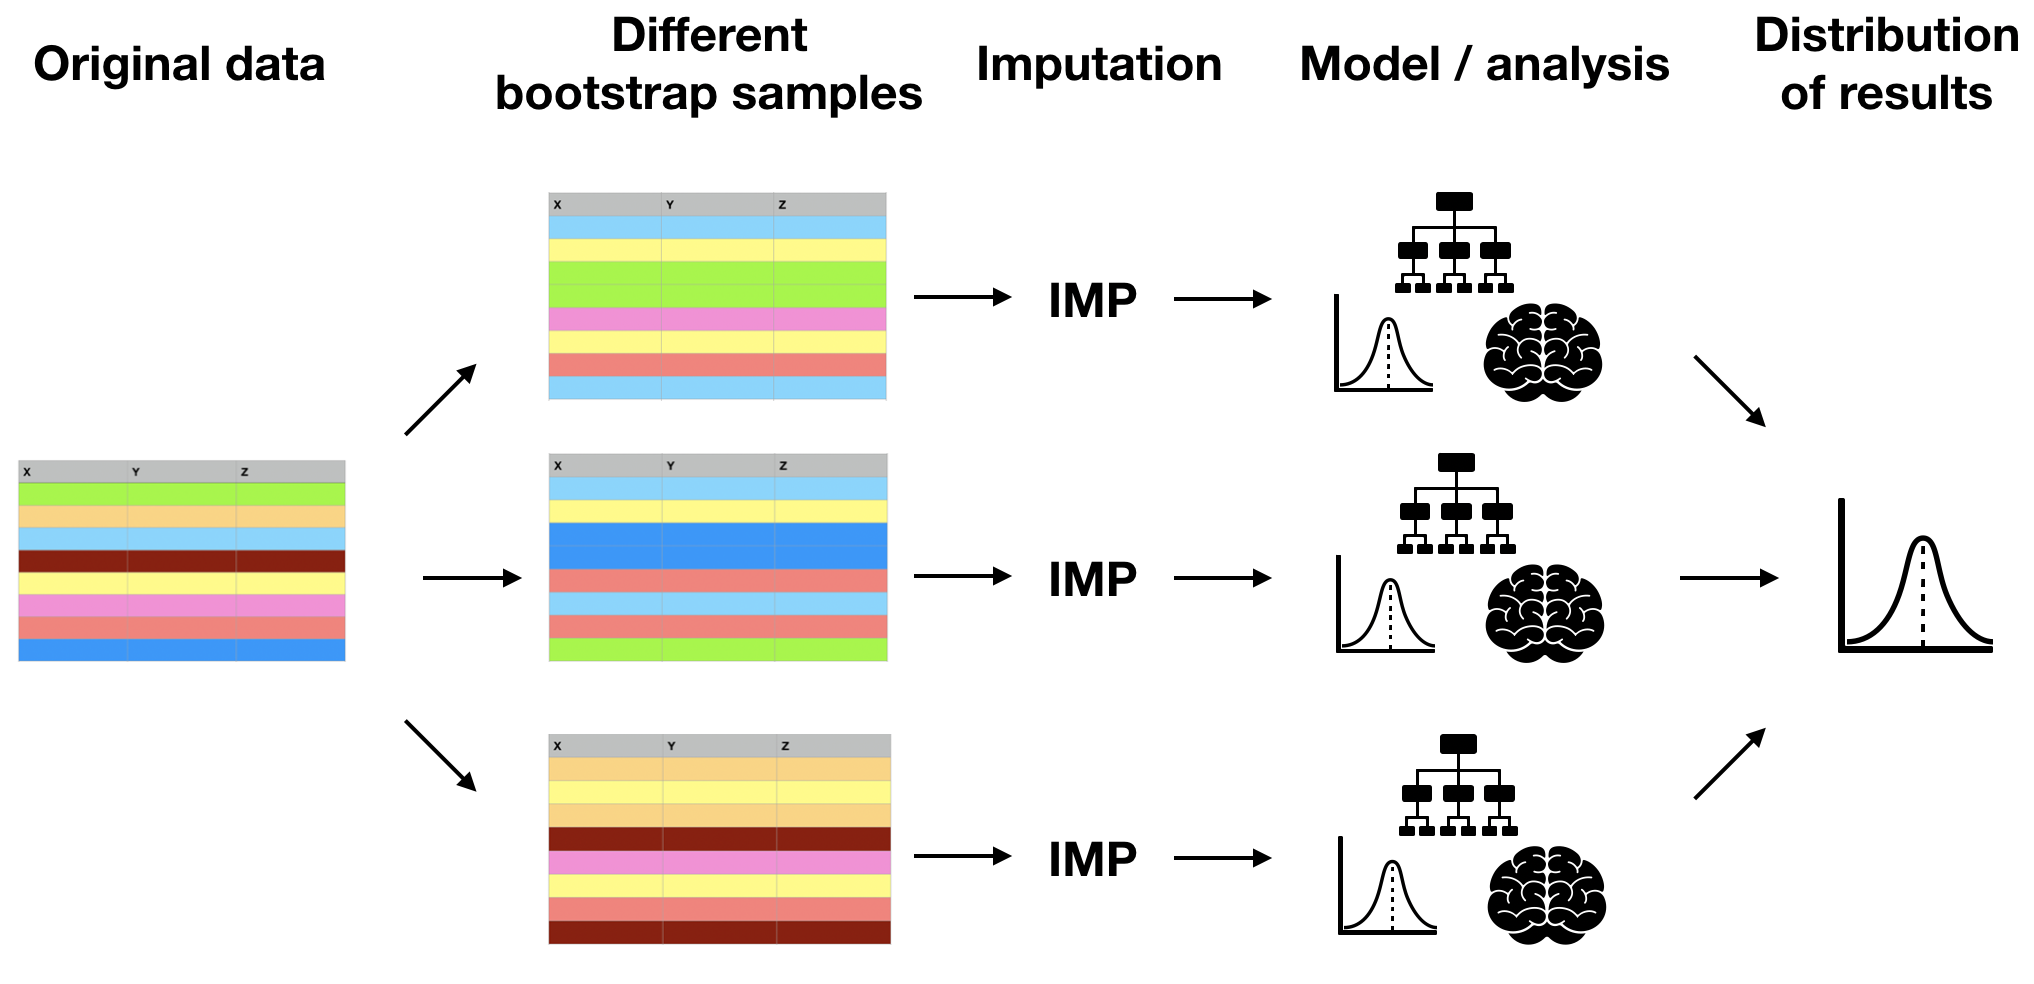
Diagram znázorňující pět fází imputace pomocí bootstrappingu. Ze schematického datového rámce označeného „původní data" vedou tři šipky ke třem dalším rámcům označeným „různé bootstrapové vzorky". Z každého z nich vede šipka ke kroku „Imputace", dále ke kroku „Modelování / analýza" a nakonec k jedinému uzlu „Rozdělení výsledků".

Práce s chybějícími daty pomocí imputace v R

Bootstrapová imputace: výhody a nevýhody

Výhody:

  • Funguje s jakoukoli metodou imputace.
  • Umožňuje aproximovat veličiny, které jsou analyticky obtížně vypočitatelné.
  • Pracuje s daty MCAR a MAR.

Nevýhody:

  • Pomalé při mnoha replikacích nebo časově náročných výpočtech.
Práce s chybějícími daty pomocí imputace v R

Bootstrapping v praxi

calc_correlation <- function(data, indices) {


  # Return the correlation coefficient
  return(corr_coeff)
}
Práce s chybějícími daty pomocí imputace v R

Bootstrapping v praxi

calc_correlation <- function(data, indices) {
  # Get bootstrap sample
  data_boot <- data[indices, ]


  # Return the correlation coefficient
  return(corr_coeff)
}
Práce s chybějícími daty pomocí imputace v R

Bootstrapping v praxi

calc_correlation <- function(data, indices) {
  # Get bootstrap sample
  data_boot <- data[indices, ]
  # Impute with kNN imputation
  data_imp <- kNN(data_boot)


  # Return the correlation coefficient
  return(corr_coeff)
}
Práce s chybějícími daty pomocí imputace v R

Bootstrapping v praxi

calc_correlation <- function(data, indices) {
  # Get bootstrap sample
  data_boot <- data[indices, ]
  # Impute with kNN imputation
  data_imp <- kNN(data_boot)
  # Calculate correlation between Weight and TotChol
  corr_coeff <- cor(data_imp$Weight, data_imp$TotChol)
  # Return the correlation coefficient
  return(corr_coeff)
}
Práce s chybějícími daty pomocí imputace v R

Bootstrapping v praxi

library(boot)
boot_results <- boot(nhanes, statistic = calc_correlation, R = 50)
print(boot_results)
ORDINARY NONPARAMETRIC BOOTSTRAP

Call:
boot(data = nhanes, statistic = calc_correlation, R = 50)

Bootstrap Statistics :
      original      bias    std. error
t1* 0.03028306 0.007385452  0.04207152
Práce s chybějícími daty pomocí imputace v R

Vizualizace výsledků bootstrappingu

plot(boot_results)
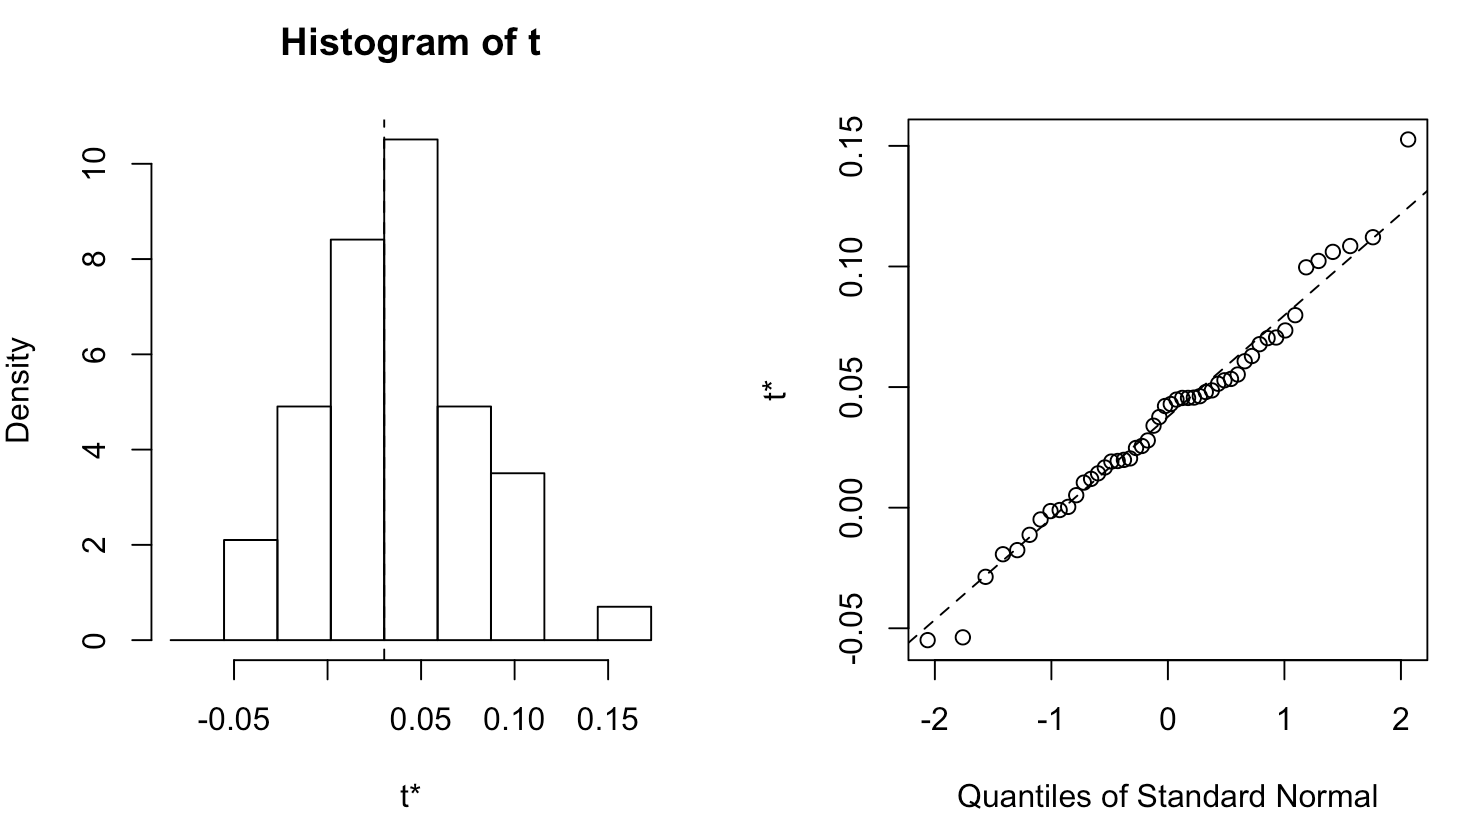
Histogram a Q-Q graf znázorňující rozdělení výsledků bootstrappingu. Oba grafy naznačují, že rozdělení se blíží normálnímu.

Práce s chybějícími daty pomocí imputace v R

Intervaly spolehlivosti pomocí bootstrappingu

boot_ci <- boot.ci(boot_results, conf = 0.95, type = "norm")
print(boot_ci)
BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
Based on 50 bootstrap replicates

CALL : 
boot.ci(boot.out = boot_results, conf = 0.95, type = "norm")

Intervals : 
Level      Normal        
95%   (-0.0596,  0.1054 )  
Calculations and Intervals on Original Scale
Práce s chybějícími daty pomocí imputace v R

Procvičte si bootstrapping!

Práce s chybějícími daty pomocí imputace v R

Preparing Video For Download...