Práce s chybějícími daty pomocí imputace v R
Michal Oleszak
Machine Learning Engineer
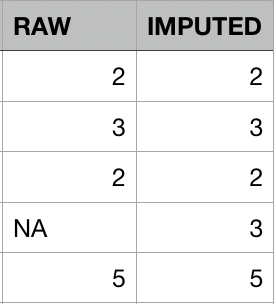
Imputace = kvalifikovaný odhad chybějících hodnot
Tato kapitola se zaměřuje na metody založené na dárcích:

Imputace průměrem funguje dobře pro časové řady, které náhodně kolísají kolem dlouhodobého průměru.
Pro průřezová data je imputace průměrem často velmi nevhodná:
Úloha: imputujte průměrem Height a Weight v datech NHANES.
nhanes <- nhanes %>%
mutate(Height_imp = ifelse(is.na(Height), TRUE, FALSE)) %>%
mutate(Weight_imp = ifelse(is.na(Weight), TRUE, FALSE))
Height a Weight jejich příslušnými průměry.nhanes_imp <- nhanes %>%
mutate(Height = ifelse(is.na(Height), mean(Height, na.rm = TRUE), Height)) %>%
mutate(Weight = ifelse(is.na(Weight), mean(Weight, na.rm = TRUE), Weight))
nhanes_imp %>%
select(Weight, Height, Height_imp, Weight_imp) %>%
head()
Weight Height Height_imp Weight_imp
1 73.20000 166.2499 TRUE FALSE
2 72.30000 166.2499 TRUE FALSE
3 57.70000 158.9000 FALSE FALSE
4 88.90000 183.3000 FALSE FALSE
5 45.10000 157.6000 FALSE FALSE
6 66.77065 158.4000 FALSE TRUE
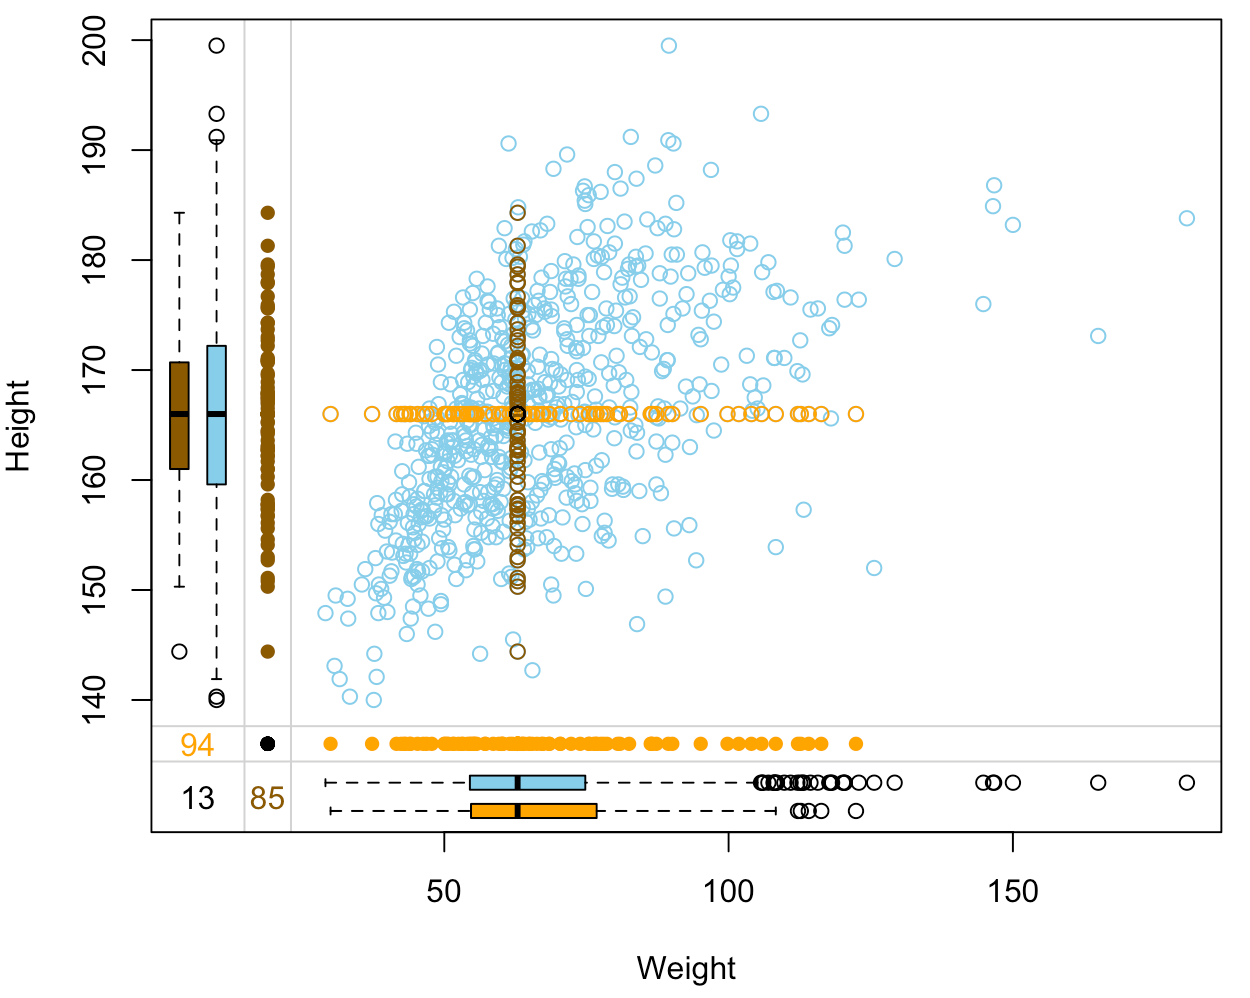
nhanes_imp %>% select(Weight, Height, Height_imp, Weight_imp) %>% marginplot(delimiter="imp")
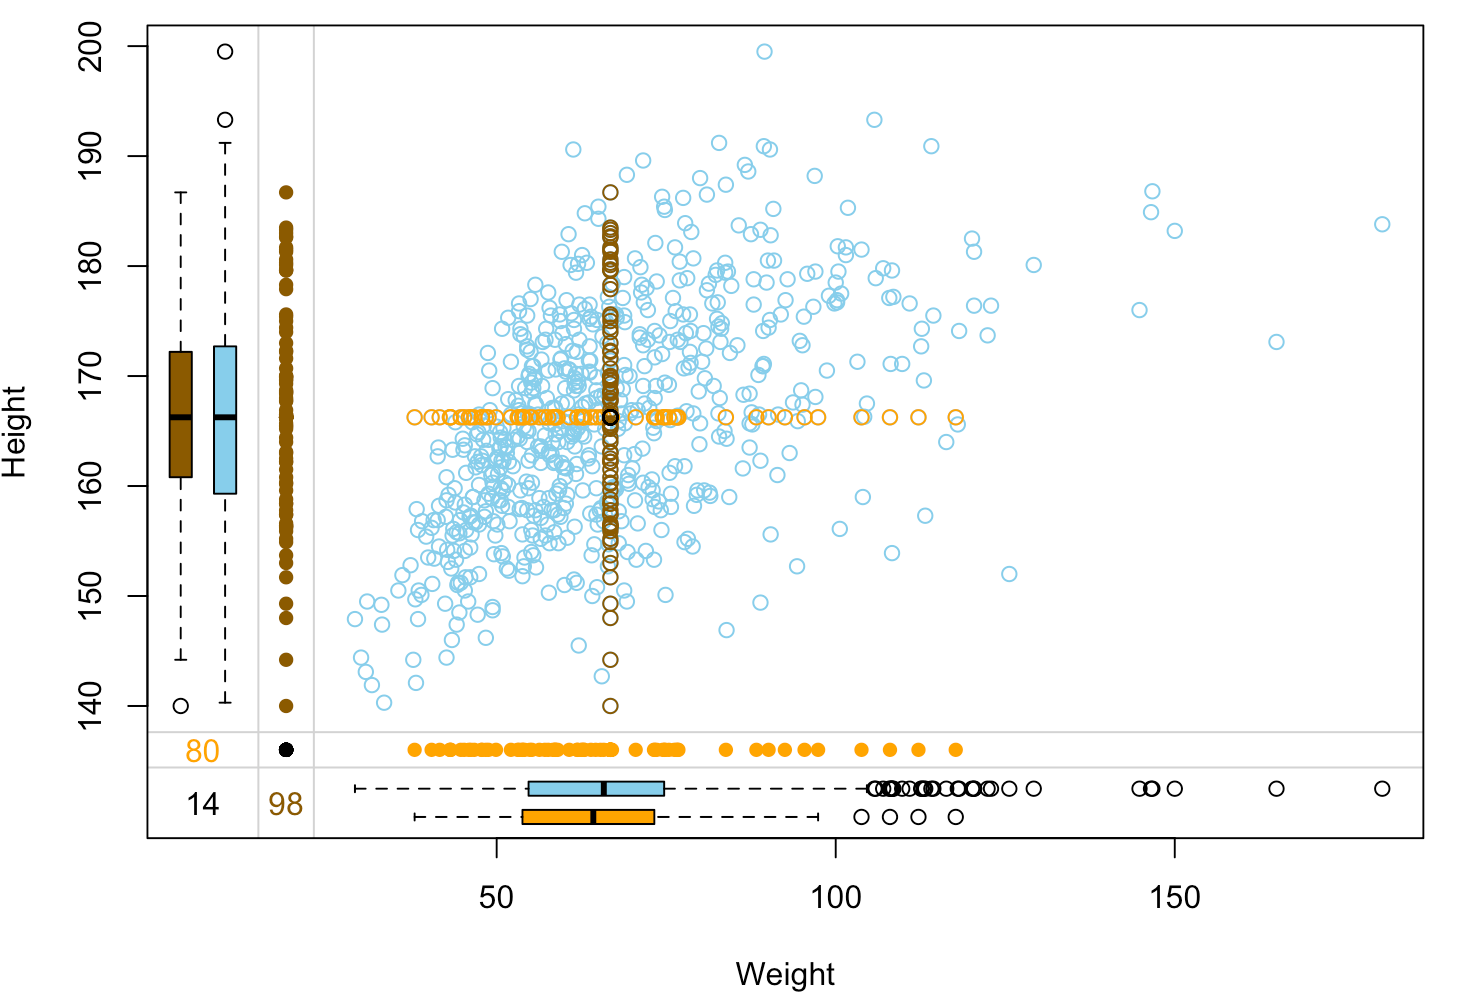
Narušení vztahů mezi proměnnými:
Height a Weight je jejich pozitivní korelace slabší.Žádná variabilita v imputovaných datech:

Práce s chybějícími daty pomocí imputace v R