Vizualizace vzorců chybějících dat

Práce s chybějícími daty pomocí imputace v R

Michal Oleszak

Machine Learning Engineer

Problémy s testovacím přístupem

  • Detekce vzorců chybějících dat pomocí statistických testů může být zdlouhavá.
  • t-test vyžaduje mnoho předpokladů o datech.
  • Závěry založené na p-hodnotách mají svá úskalí (volba hladiny významnosti, p-hacking).
Práce s chybějícími daty pomocí imputace v R

Vizualizace chybějících dat

  • Jiný přístup: vizualizace!
  • Snadno použitelné.
  • Umožňují detekovat vzorce chybějících dat.
  • Poskytují přehled o dalších aspektech kvality dat.

Balíček VIM nabízí sadu nástrojů pro vizualizaci chybějících dat. V této lekci:

  • Agregační graf
  • Spinový graf
  • Mozaikový graf
Práce s chybějícími daty pomocí imputace v R

Agregační graf

nhanes %>% aggr(combined = TRUE, numbers = TRUE)
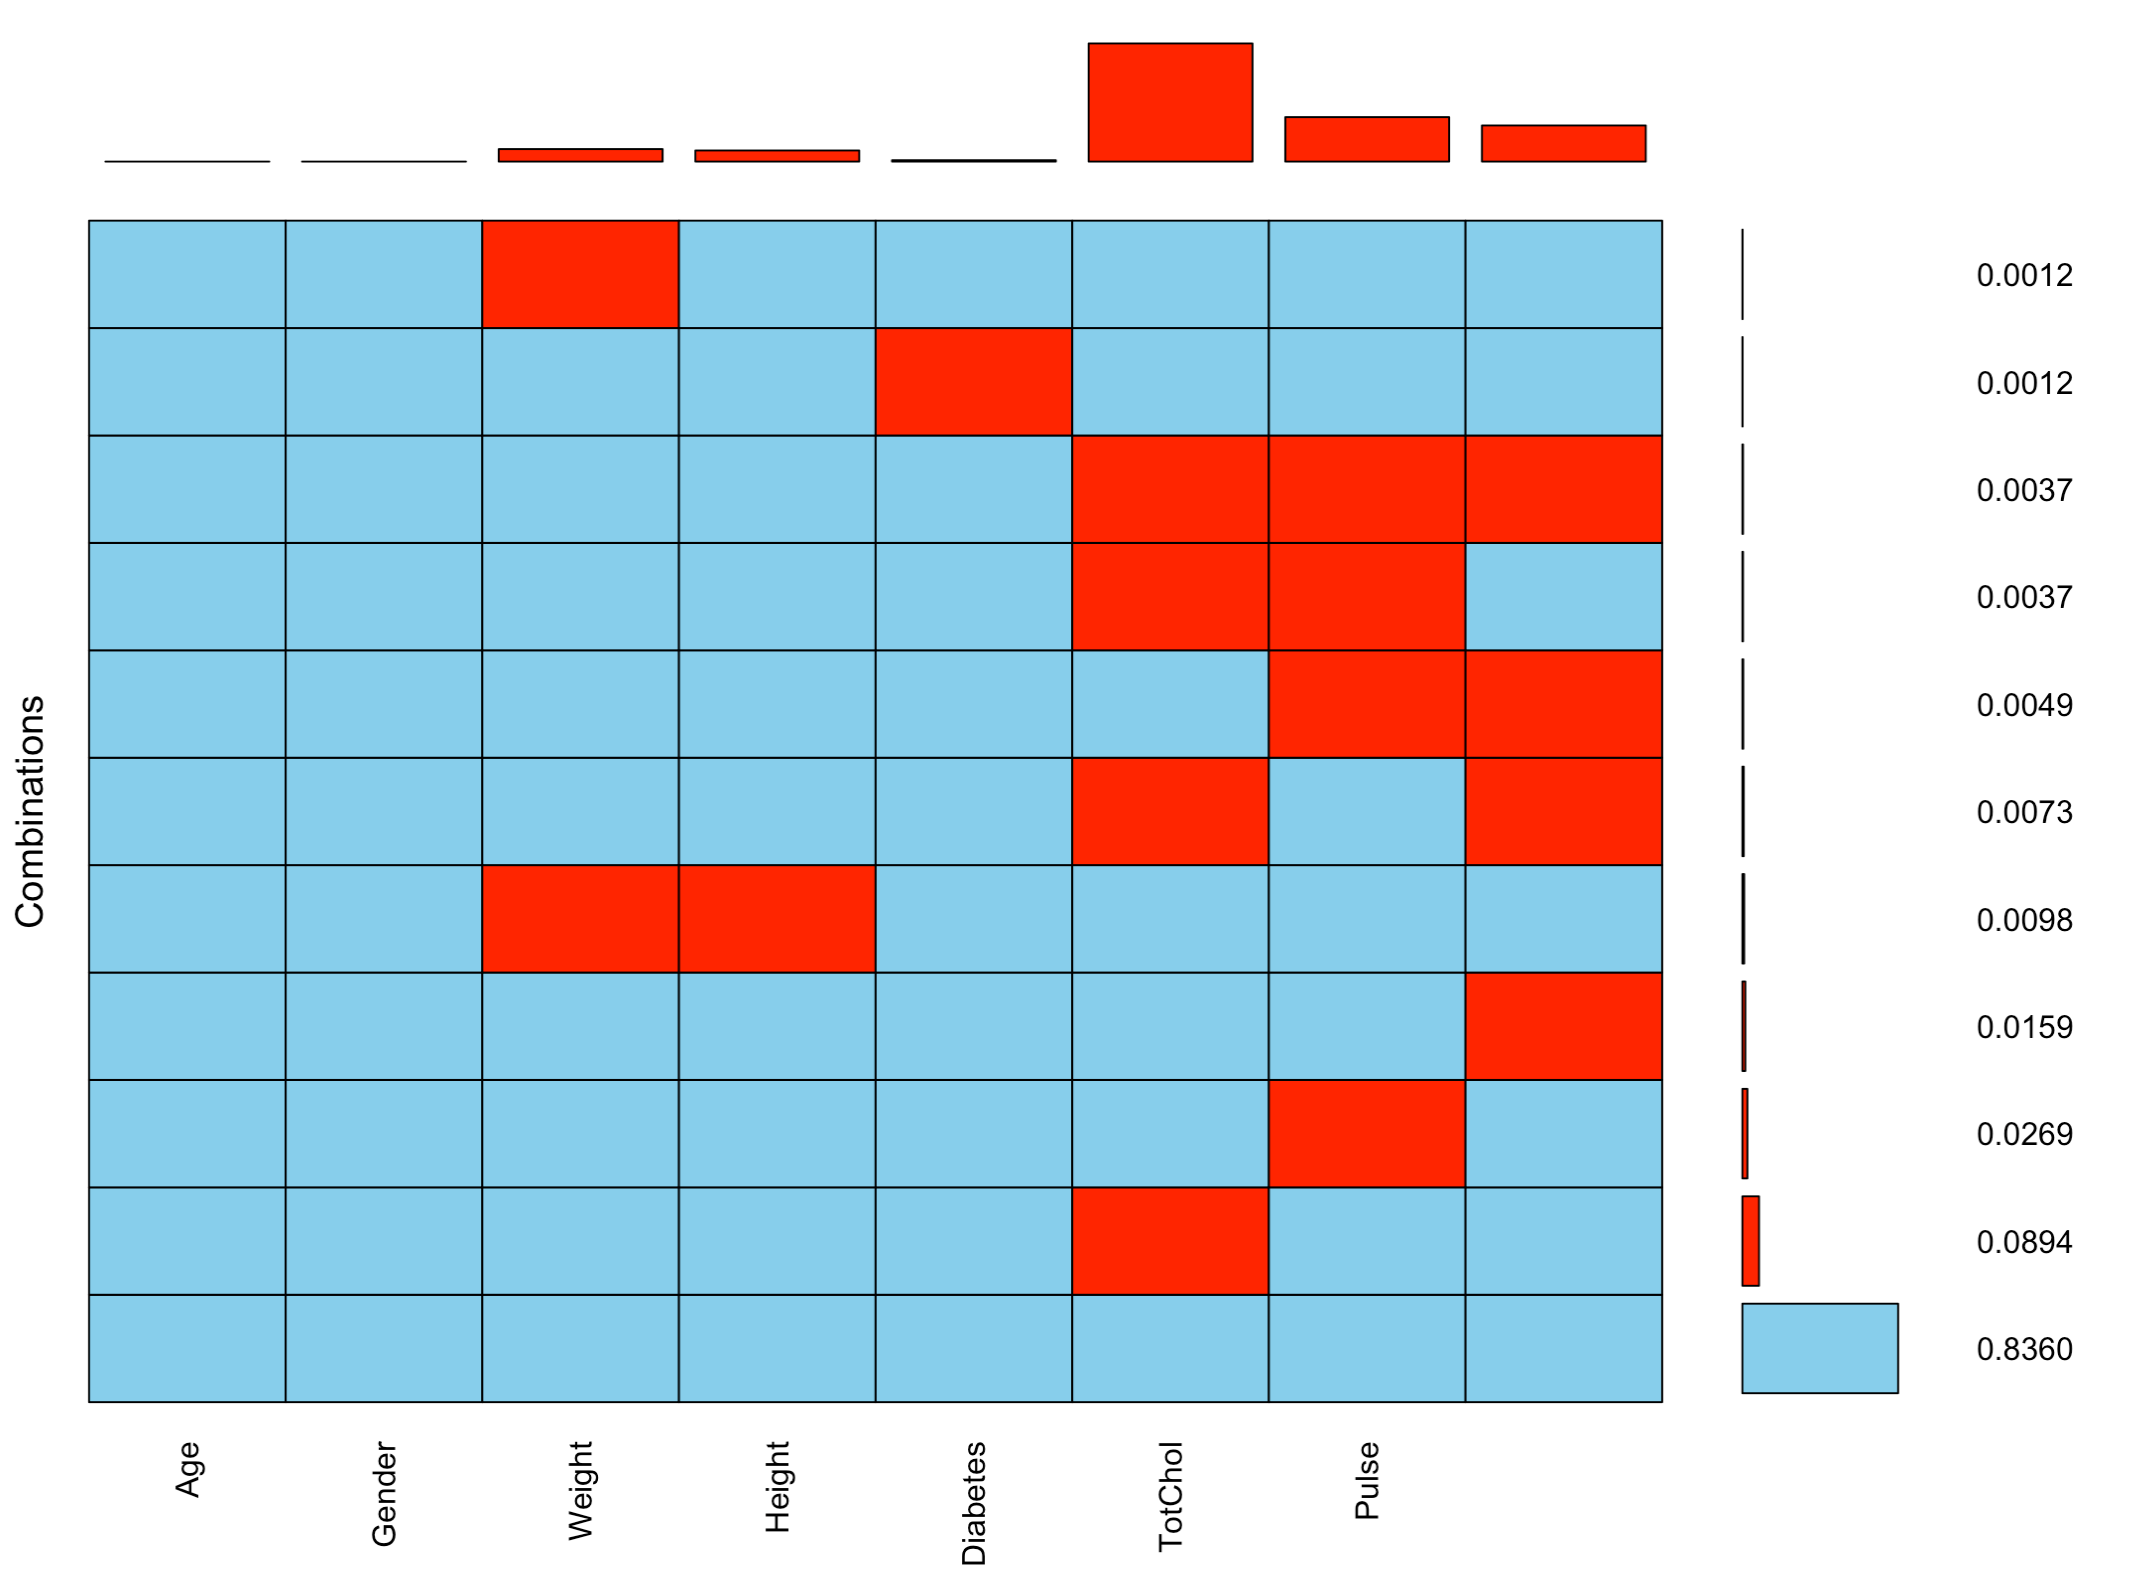
Agregační graf zobrazující mřížku se všemi kombinacemi chybějících a pozorovaných hodnot v různých proměnných datové sady. U každé kombinace je uvedeno procento pozorování s příslušným vzorcem chybějících dat.

Práce s chybějícími daty pomocí imputace v R

Spinový graf

nhanes %>% select(Gender, TotChol) %>% spineMiss()
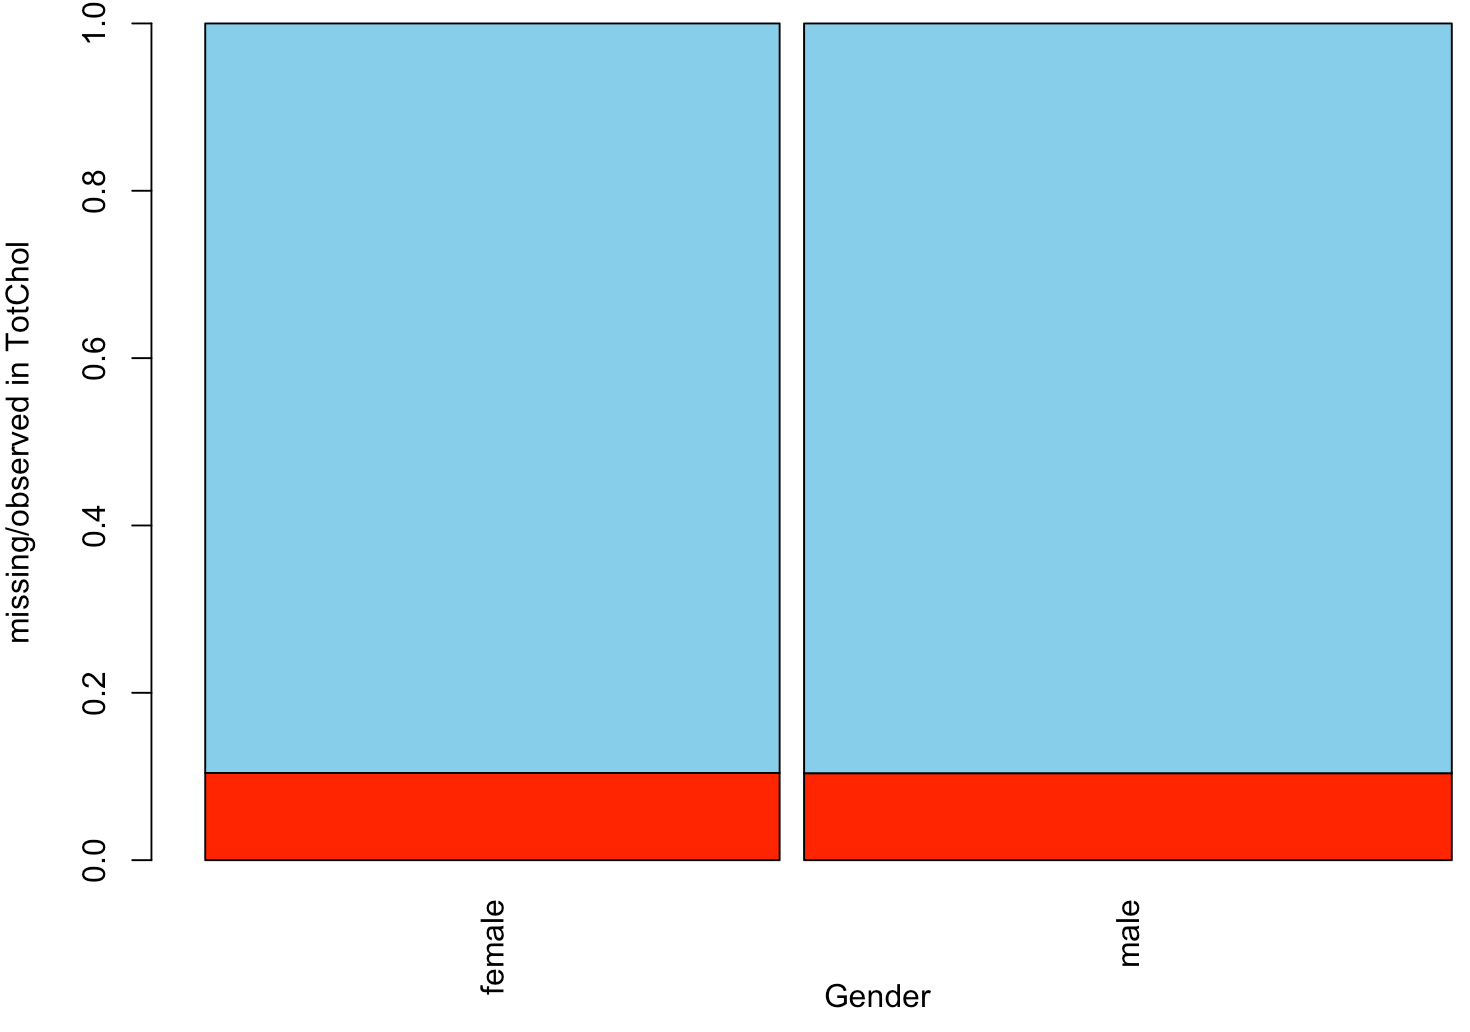
Spinový graf sestávající ze dvou sloupců odpovídajících mužům a ženám. V každém sloupci je zobrazeno procento chybějících hodnot v proměnné celkového cholesterolu pro příslušné pohlaví.

Práce s chybějícími daty pomocí imputace v R

Mozaikový graf

nhanes %>% mosaicMiss(highlight = "TotChol", plotvars = c("Gender", "PhysActive"))
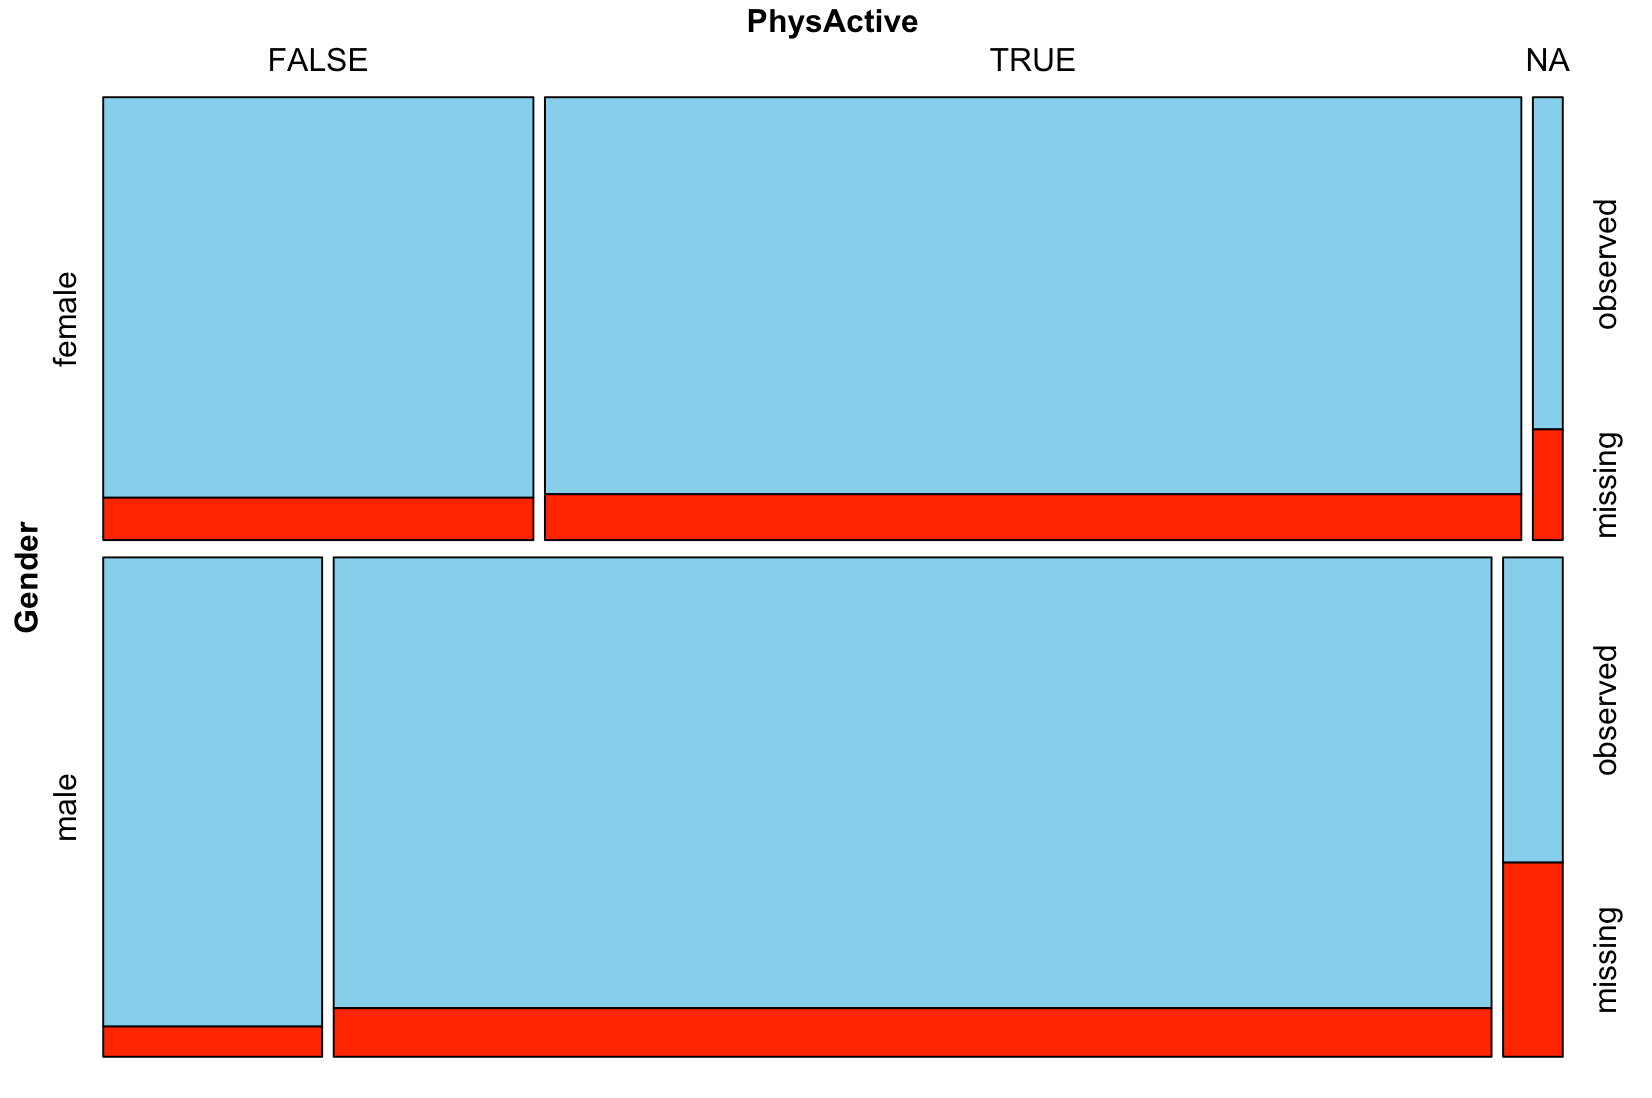
Mozaikový graf tvořený dlaždicemi uspořádanými do obdélníku. Každá dlaždice odpovídá jedné hodnotě proměnné „Gender" a jedné hodnotě proměnné „PhysActive". V každé dlaždici je zobrazeno procento chybějících hodnot celkového cholesterolu.

Práce s chybějícími daty pomocí imputace v R

Pojďme vizualizovat chybějící data!

Práce s chybějícími daty pomocí imputace v R

Preparing Video For Download...