Imputace k-nejbližších sousedů

Práce s chybějícími daty pomocí imputace v R

Michal Oleszak

Machine Learning Engineer

Imputace k-nejbližších sousedů
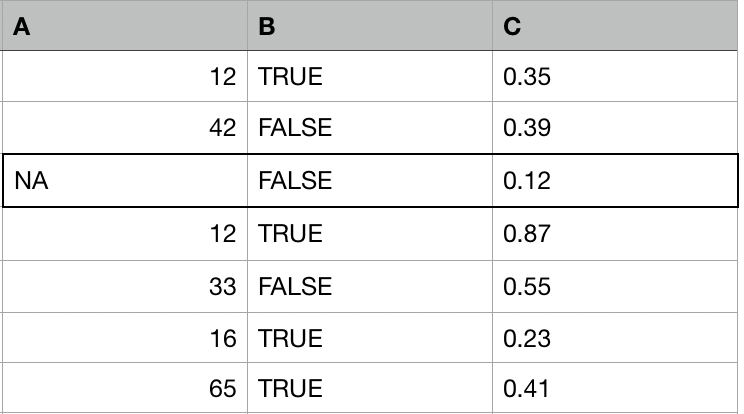
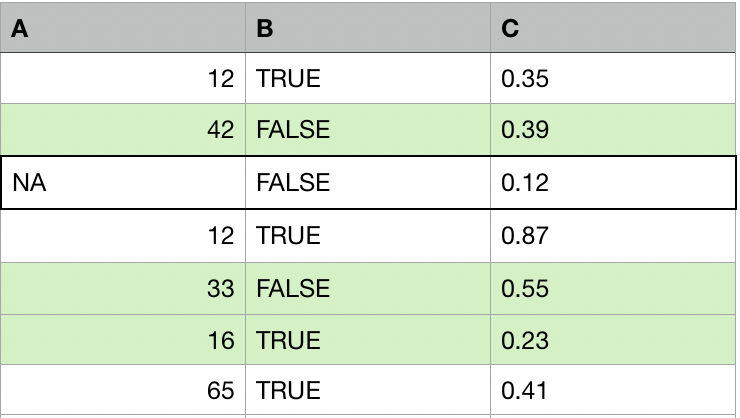
Tabulka se třemi sloupci: A, B a C. Ve sloupci A chybí jedna hodnota.

Práce s chybějícími daty pomocí imputace v R

Imputace k-nejbližších sousedů

Tabulka se třemi sloupci: A, B a C. Ve sloupci A chybí jedna hodnota. Tři řádky bez chybějící hodnoty jsou barevně zvýrazněny.

Pro každé pozorování s chybějícími hodnotami:

  1. Nalezněte k nejpodobnějších pozorování (dárců, sousedů).
Práce s chybějícími daty pomocí imputace v R

Imputace k-nejbližších sousedů

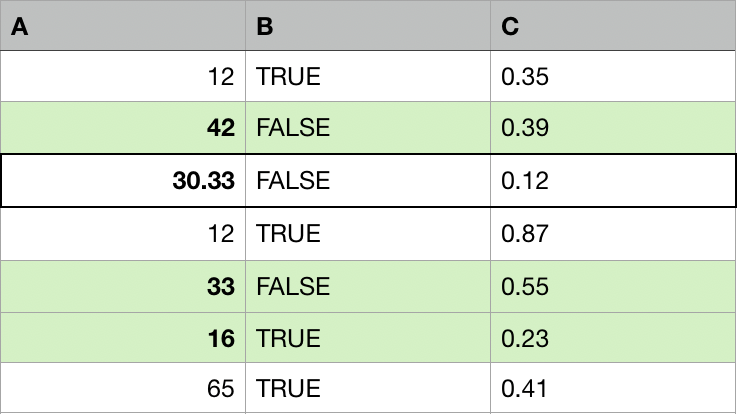
Tabulka se třemi sloupci: A, B a C. Tři řádky bez chybějící hodnoty jsou barevně zvýrazněny. Chybějící hodnota ve sloupci A byla nahrazena průměrem hodnot ve stejném sloupci ve zvýrazněných řádcích.

Pro každé pozorování s chybějícími hodnotami:

  1. Nalezněte k nejpodobnějších pozorování (dárců, sousedů).
  2. Nahraďte chybějící hodnoty agregovanými hodnotami od k dárců (průměr, medián, modus).
Práce s chybějícími daty pomocí imputace v R

Míry vzdálenosti

Vzdálenost mezi dvěma pozorováními a a b:

Euklidovská vzdálenost pro n numerických proměnných:

$\sqrt{\Sigma_{i=1}^{n} (a_i - b_i)^{2}}$

Manhattanská vzdálenost pro f faktorových proměnných:

$\Sigma_{i=1}^{f} |a_i - b_i|$

Hammingova vzdálenost pro c kategorických proměnných:

$\Sigma_{i=1}^{c} I(a_i \neq b_i)$

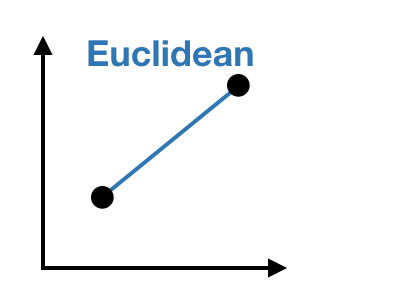
Souřadnicová soustava se dvěma body spojenými přímou úsečkou.

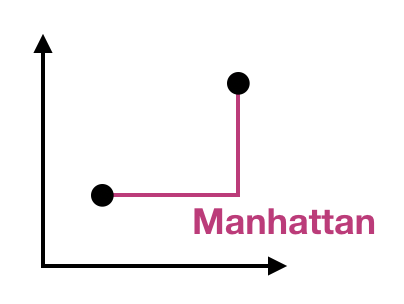
Souřadnicová soustava se dvěma body spojenými dvěma kolmými úsečkami, jako by body byly protilehlými rohy obdélníku.

Práce s chybějícími daty pomocí imputace v R

Gowerova vzdálenost

Simulovaný datový rámec obsahující tři typy proměnných, každý zvýrazněný jinou barvou: numerické, faktorové a kategorické proměnné.

Práce s chybějícími daty pomocí imputace v R

Gowerova vzdálenost

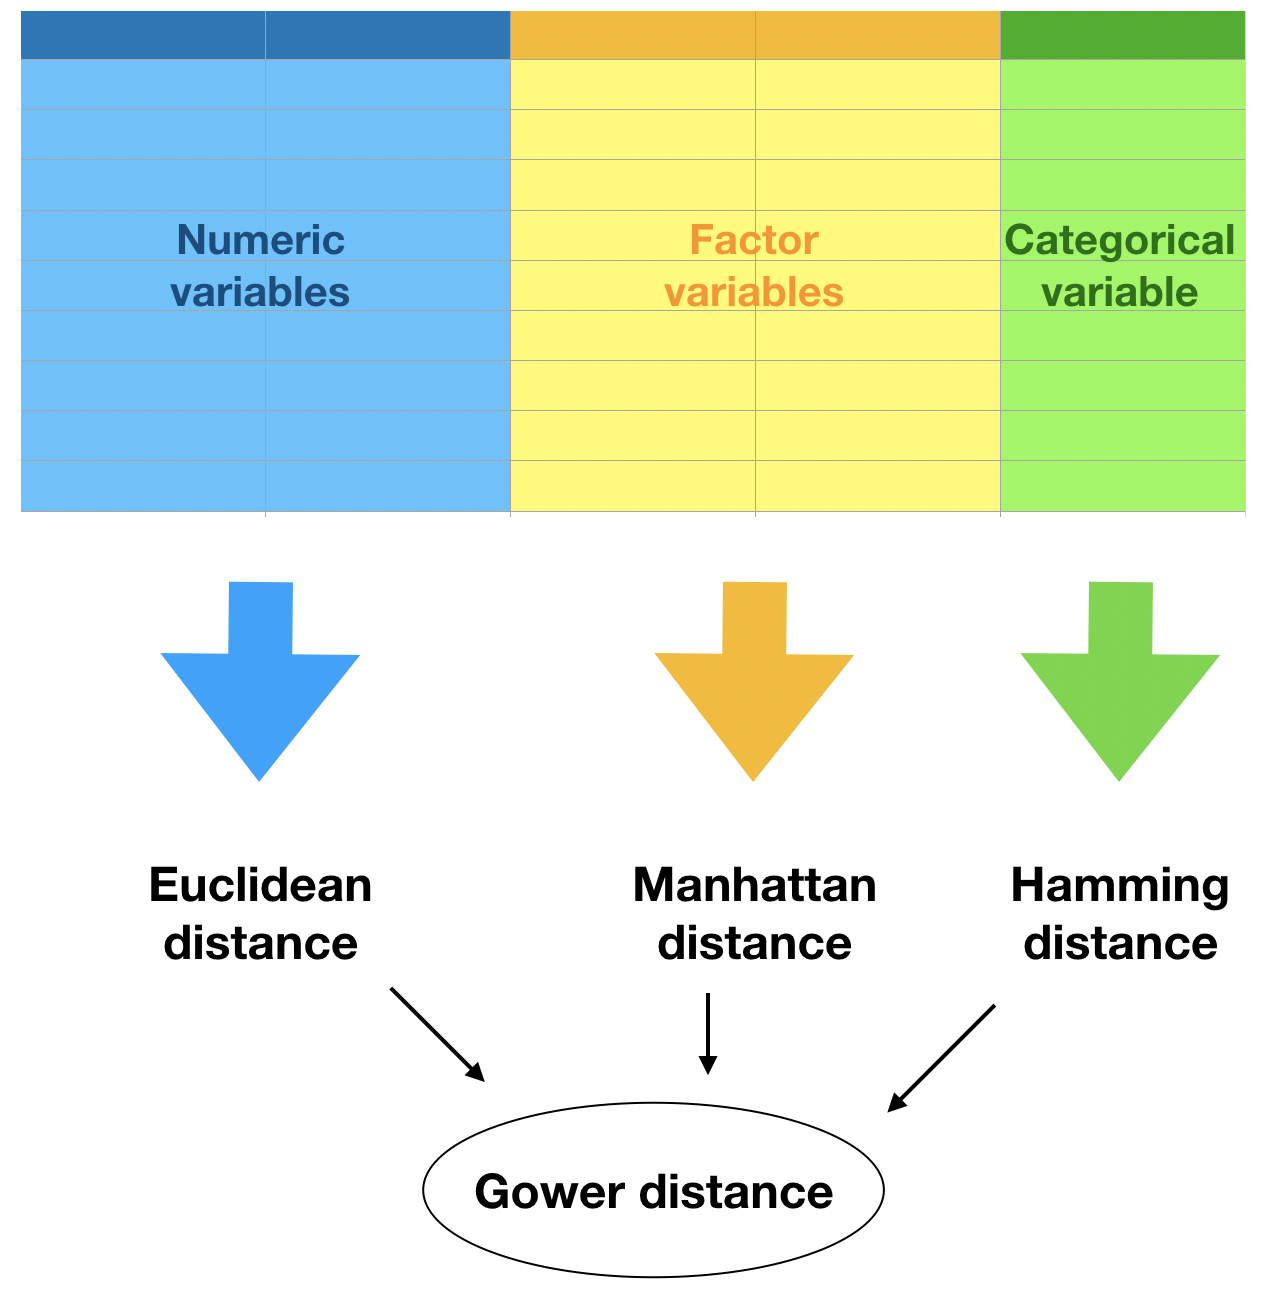
Simulovaný datový rámec obsahující tři typy proměnných, každý zvýrazněný jinou barvou: numerické, faktorové a kategorické proměnné. Každý typ proměnné má přiřazenou šipku ukazující na odpovídající míru vzdálenosti: euklidovskou, manhattanskou a Hammingovu vzdálenost. Všechny tři ukazují na elipsu s Gowerovou vzdáleností, která je jejich kombinací.

Práce s chybějícími daty pomocí imputace v R

kNN imputace v praxi

library(VIM)
nhanes_imp <- kNN(nhanes, k = 5, variable = c("TotChol", "Pulse"))
head(nhanes_imp)
  Age Gender Weight Height Diabetes TotChol Pulse PhysActive TotChol_imp Pulse_imp
1  16   male   73.2  172.0    FALSE    3.00    76       TRUE       FALSE     FALSE
2  17   male   72.3  176.0    FALSE    2.61    74       TRUE       FALSE     FALSE
3  12   male   57.7  158.9    FALSE    4.27    80       TRUE       FALSE     FALSE
4  16   male   88.9  183.3    FALSE    3.62    58       TRUE       FALSE     FALSE
5  13 female   45.1  157.6    FALSE    2.66    92       TRUE       FALSE     FALSE
6  16 female   48.7  158.4    FALSE    4.32    58      FALSE       FALSE     FALSE
Práce s chybějícími daty pomocí imputace v R

Vážení dárců

  • Z k vybraných sousedů jsou některé danému pozorování podobnější než jiné.
  • Bližším sousedům lze při agregaci přiřadit větší váhu.
  • Agregace sousedů váženým průměrem, kde váhy odpovídají převrácené vzdálenosti ke každému sousedovi.
  • Toto je možné pouze pro imputaci numerických proměnných.
nhanes_imp <- nhanes %>% 
  kNN(variable = c("TotChol", "Pulse"),
      k = 5,
      numFun = weighted.mean,
      weightDist = TRUE)
Práce s chybějícími daty pomocí imputace v R

Řazení proměnných

  • Algoritmus kNN prochází proměnné postupně a imputuje je jednu po druhé.
  • Pokaždé se vypočítávají vzdálenosti mezi pozorováními.
  • Pokud první proměnná obsahuje mnoho chybějících hodnot, výpočet vzdálenosti pro druhou proměnnou bude vycházet z mnoha imputovaných hodnot.
  • Před spuštěním kNN je vhodné seřadit proměnné vzestupně podle počtu chybějících hodnot.
Práce s chybějícími daty pomocí imputace v R

Řazení proměnných v praxi

vars_by_NAs <- nhanes %>% 
  is.na() %>%
  colSums() %>%
  sort(decreasing = FALSE) %>% 
  names()
nhanes_imp <- nhanes %>% 
  select(vars_by_NAs) %>% 
  kNN(k = 5)
Práce s chybějícími daty pomocí imputace v R

Pojďme procvičit kNN imputaci!

Práce s chybějícími daty pomocí imputace v R

Preparing Video For Download...