Bootstrapové intervaly spolehlivosti
Případové studie ve statistickém myšlení

Justin Bois
Lecturer, Caltech
EDA jako první krok
„Exploratorní analýza dat nemůže být nikdy celým příběhem, ale nic jiného nemůže sloužit jako základní kámen, jako první krok."
--John Tukey
ECDF délky aktivní fáze
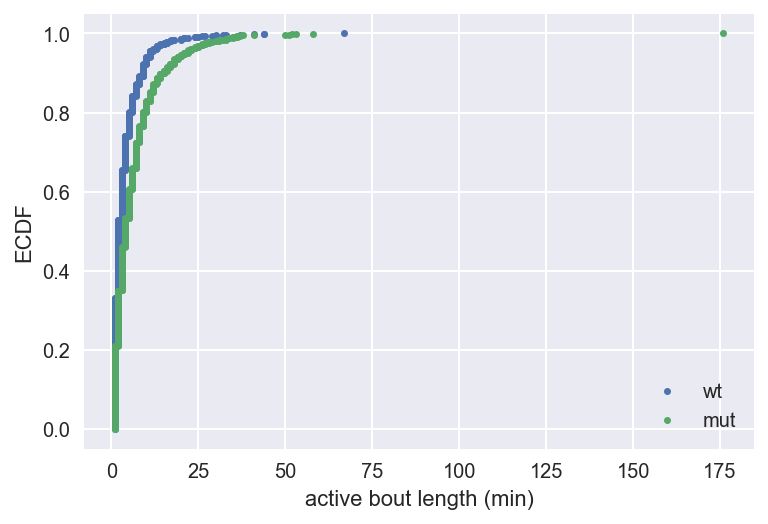
1 Data laskavě poskytli Avni Gandhi, Grigorios Oikonomou a David Prober, Caltech
Optimální hodnota parametru
- Optimální hodnota parametru: Hodnota parametru pravděpodobnostního rozdělení, která nejlépe popisuje data
- Optimální parametr exponenciálního rozdělení: Vypočítá se z průměru dat
np.mean(nuclear_incident_times)
87.140350877192986
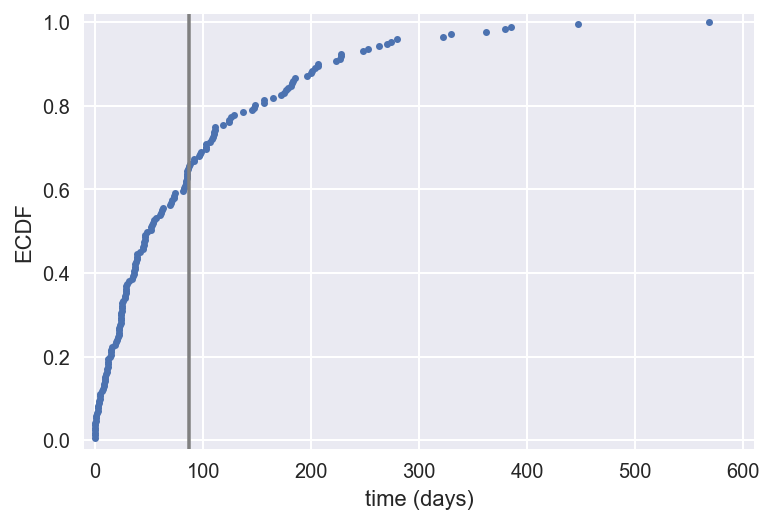
1 Zdroj dat: Wheatley, Sovacool a Sornette, Nuclear Events Database
Bootstrapový vzorek
Převzorkované pole dat
# Resample nuclear_incident_times with replacement
bs_sample = np.random.choice(
  nuclear_incident_times,
  replace=True,
  size=len(inter_times)
)
Bootstrapové replikáty
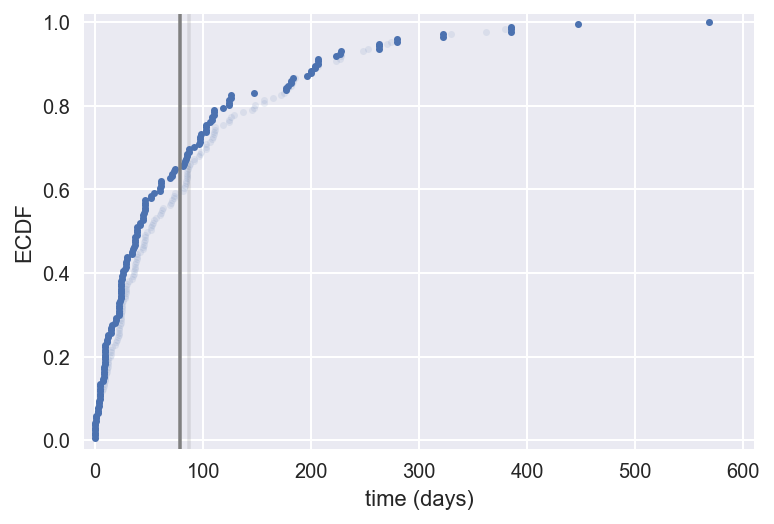
1 Zdroj dat: Wheatley, Sovacool a Sornette, Nuclear Events Database
Bootstrapové replikáty
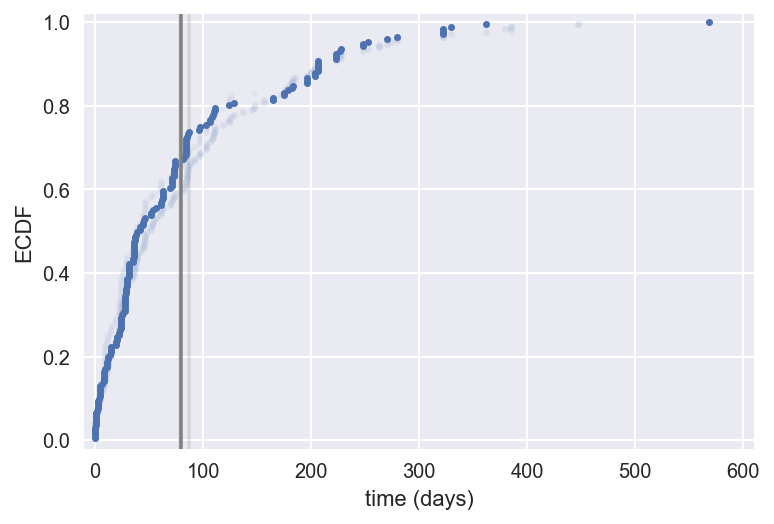
1 Zdroj dat: Wheatley, Sovacool a Sornette, Nuclear Events Database
Bootstrapové replikáty
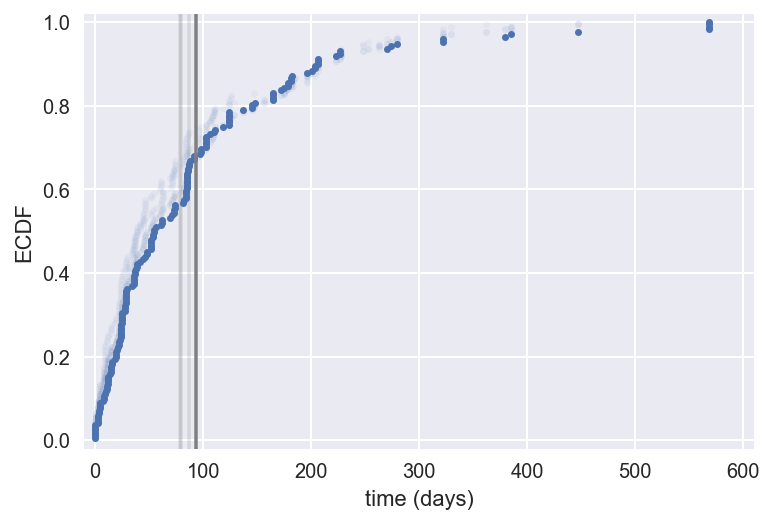
1 Zdroj dat: Wheatley, Sovacool a Sornette, Nuclear Events Database
Bootstrapové replikáty
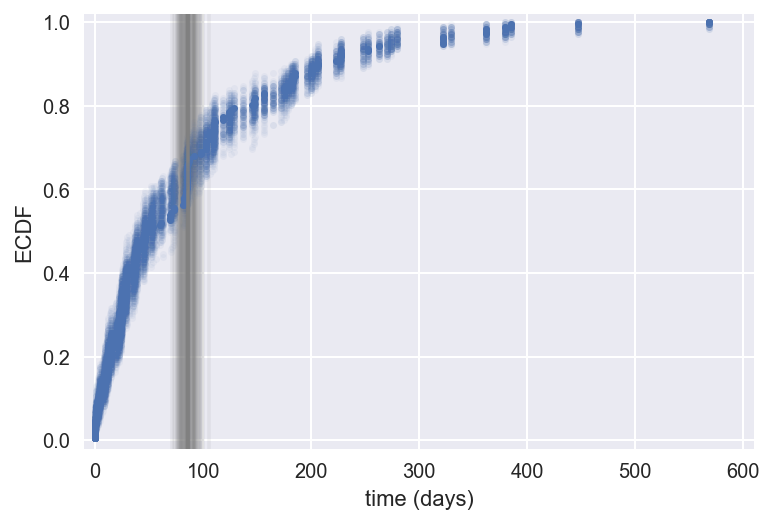
1 Zdroj dat: Wheatley, Sovacool a Sornette, Nuclear Events Database
Bootstrapové replikáty
Bootstrapový replikát: Statistika vypočítaná z bootstrapového vzorku
dcst.draw_bs_reps()
Funkce pro generování bootstrapových replikátů z datové sady
# Draw 10000 replicates of the mean from
# nuclear_incident_times
bs_reps = dcst.draw_bs_reps(
  nuclear_incident_times, np.mean, size=10000
)
Bootstrapový interval spolehlivosti
1 Zdroj dat: Wheatley, Sovacool a Sornette, Nuclear Events Database
Bootstrapový interval spolehlivosti
Pokud bychom měření opakovali znovu a znovu, p% pozorovaných hodnot by leželo uvnitř p% intervalu spolehlivosti
Bootstrapový interval spolehlivosti
np.percentile(bs_reps, [2.5, 97.5])
array([ 73.31505848, 102.39181287])

