Feature engineering

Developing Machine Learning Models for Production

Sinan Ozdemir

Data Scientist and Author

Úvod do feature engineeringu

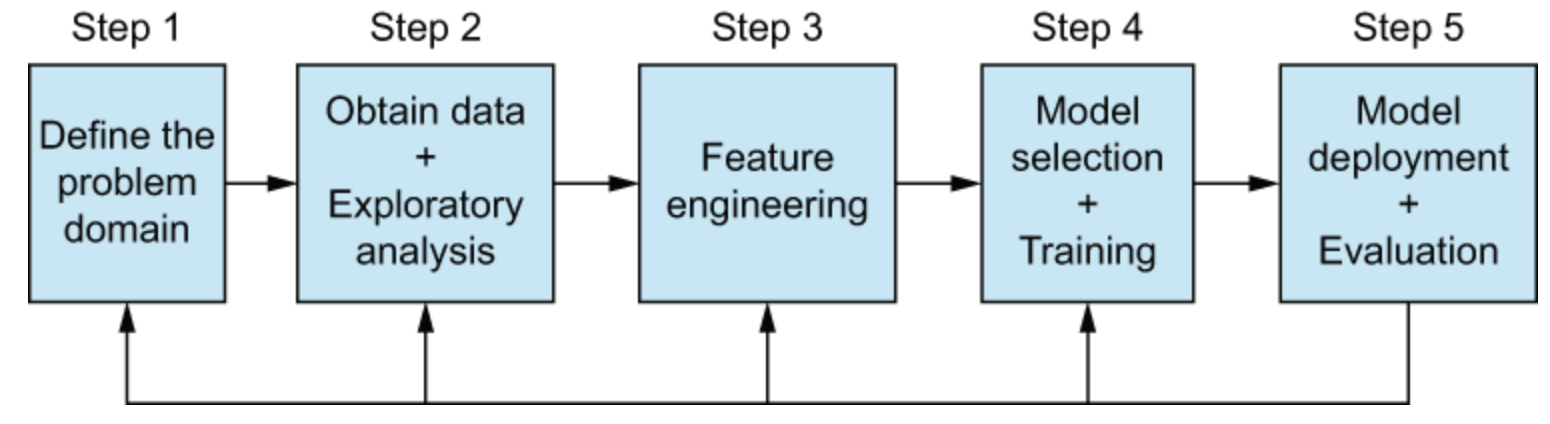
  • Transformace trénovacích dat pro maximální výkon ML pipeline
  • Snížení výpočetní náročnosti
  • Příklady
    • Agregace dat z více zdrojů
    • Vytváření nových příznaků
    • Aplikace transformací příznaků

pipeline feature engineeringu

1 https://www.manning.com/books/feature-engineering-bookcamp
Developing Machine Learning Models for Production

Agregace dat z více zdrojů

  • Kombinování dat z různých datových sad
  • Používání více typů dat (např. číselných a kategoriálních)

To pomáhá:

  • Zvýšit přesnost modelů
  • Umožnit použití složitějších modelů

grafy na obrazovce

Developing Machine Learning Models for Production

Příklad agregace dat

class DataAggregator:
    def __init__(self):
        pass

    def fit(self, X, y=None):
        return self  # nothing to fit

    def transform(self, X, y=None):
        # Load data from multiple sources
        data1 = pd.read_csv('data1.csv')
        data2 = pd.read_csv('data2.csv')
        data3 = pd.read_csv('data3.csv')

        # Combine data from all sources (including X) into a single data frame
        aggregated_data = pd.concat([X, data1, data2, data3], axis=0)

        return aggregated_data  # Return aggregated data
Developing Machine Learning Models for Production

Konstrukce příznaků

  • Vytváření nových příznaků z existujících
  • Generování nových příznaků z existujících dat
  • Zlepšení výkonu modelu
  • Zvýšení interpretovatelnosti modelu
Developing Machine Learning Models for Production

Příklad konstrukce příznaků

class FeatureConstructor:
    def __init__(self):
        pass

    def fit(self, X, y=None):
        return self

    def transform(self, X, y=None):
        # Calculate the mean of each column in the data
        mean_values = X.mean()

        # Create new features based on the mean values
        X['mean_col1'] = X['col1'] - mean_values['col1']
        X['mean_col2'] = X['col2'] - mean_values['col2']

        return X  # Return the augmented data set
Developing Machine Learning Models for Production

Transformace příznaků

Transformace existujících příznaků na místě

  • Normalizace rozložení dat
  • Odstranění odlehlých hodnot
  • Zlepšení přesnosti a výkonu modelu
```py
```py

Developing Machine Learning Models for Production

Výběr příznaků

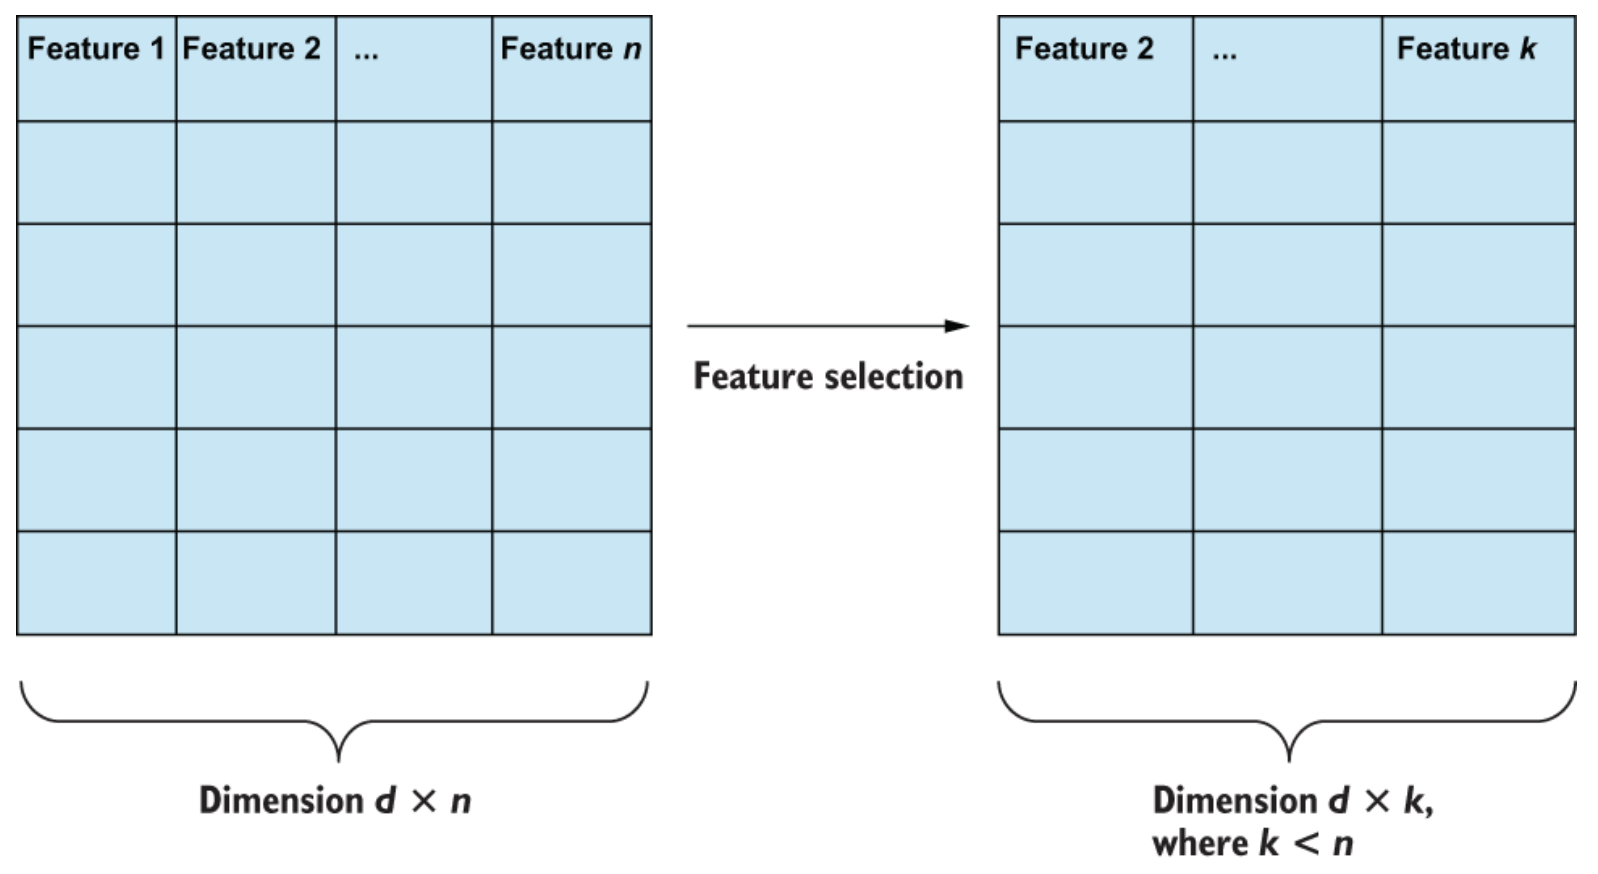
Výběr podmnožiny příznaků z větší sady odstraněním nadbytečných a irelevantních příznaků

  • Snižuje přetrénování
  • Zvyšuje přesnost a výkon modelu
  • Zlepšuje interpretovatelnost modelu

výběr příznaků

1 https://www.manning.com/books/feature-engineering-bookcamp
Developing Machine Learning Models for Production

Příklad feature engineeringu (pokračování)

```py
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.feature_selection import SelectKBest, chi2

from sklearn.pipeline import Pipeline

pipeline = Pipeline([  # Define feature engineering pipeline

    ('aggregate', DataAggregator()),  # Aggregate data from multiple sources
    ('construction', FeatureConstructor()),  # Feature Construction

    ('scaler', StandardScaler()),  # Feature Transformation

    ('select', SelectKBest(chi2, k=10)),  # Feature Selection
])
X_transformed = pipeline.fit_transform(X)  # Fit and transform data using pipeline
Developing Machine Learning Models for Production

Dozvěz se víc o feature engineeringu

kniha o feature engineeringu

Developing Machine Learning Models for Production

Pojďme cvičit!

Developing Machine Learning Models for Production

Preparing Video For Download...