External- und Iceberg-Tabellen

Automatisierung von Datenpipelines in Snowflake

Emily Melhuish

Technical Curriculum Developer, Snowflake

Was ist eine External Table?

Use Case:

  • Harbr erhält täglich Dateien von Dutzenden Partnern
  • Laden nach Snowflake ist nicht sinnvoll
external table.png

External Tables

  • Daten bleiben in S3, GCS oder Azure Blob — nie in Snowflake verschoben
  • Snowflake speichert Metadaten: Dateipfade, Schemata
  • Liest Dateien zur Abfragezeit
Automatisierung von Datenpipelines in Snowflake

External Table erstellen

CREATE EXTERNAL TABLE logistics.supplier_inventory
  WITH LOCATION = @harbr_stage/inventory/
  FILE_FORMAT = (TYPE = 'PARQUET')
  AUTO_REFRESH = TRUE;
Automatisierung von Datenpipelines in Snowflake

Wann External Tables nutzen

  • Daten gehören einem Partner — abfragen ohne Datenmanagement zu übernehmen
  • Dateien groß, selten abgefragt — kein Laden für monatlich genutzte Daten
  • Daten dürfen aus Compliance-Gründen nicht bewegt werden — bleiben am Ursprungsort
  • Erkunden vor dem Commit — Rohdateien lesen, bevor entschieden wird, was geladen wird
-- Partnerbestand abfragen 
SELECT supplier_id,
       COUNT(*)       AS file_count,
       SUM(quantity)  AS total_units
FROM logistics.supplier_inventory
WHERE delivery_date >= '2024-01-01'
GROUP BY supplier_id;
Automatisierung von Datenpipelines in Snowflake

External Tables vs. Daten laden

External Tables

  • Kein Snowflake-Speicherbedarf
  • Spiegelt stets den aktuellen Cloud-Storage-Zustand
  • Ideal für selten abgefragte, archivierte Daten
-- Direkt abfragen, kein Laden nötig
SELECT * FROM 
logistics.supplier_inventory
WHERE supplier_id = 'SUP-042';

Laden mit COPY INTO

  • Volle Snowflake-Abfrageleistung
  • Ideal für häufig abgefragte, Live-Daten
-- Einmal laden, schnell abfragen
COPY INTO logistics.delivery_events
FROM @harbr_stage/events/;
Automatisierung von Datenpipelines in Snowflake

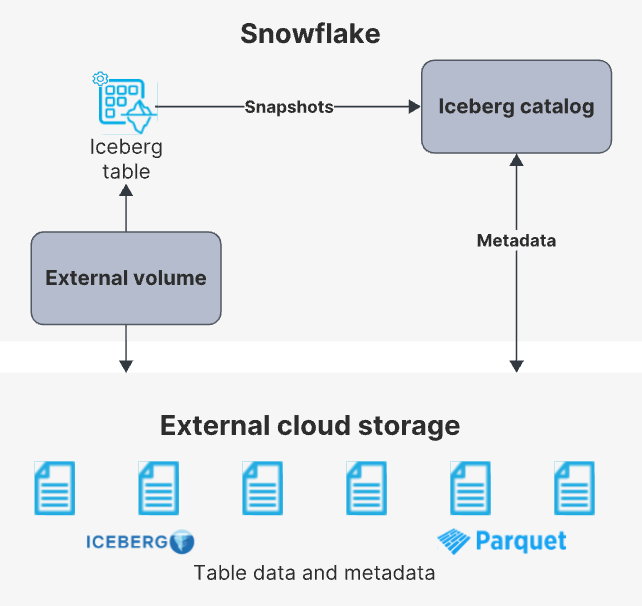
Apache Iceberg-Tabellen

  • Wie stellen wir korrektes Lesen aus S3, Azure Blob oder GCS sicher?

    • Apache
  • Apache = Offenes Tabellenformat: Daten nicht an eine Engine gebunden

    • Parquet-Dateien + Metadatenebene (Time Travel, Schema-Historie, Partitionen)
    • Zuverlässigkeit auf Datenbank-Niveau

Screenshot 2026-05-11 at 12.14.31 pm.png

1 * Snowflake Lernmaterial
Automatisierung von Datenpipelines in Snowflake

Snowflake-gemanagt vs. extern gemanagt

Snowflake-gemanagt

  • Snowflake besitzt und schreibt die Iceberg-Metadaten
  • Voller Lese-/Schreibzugriff per SQL
CREATE ICEBERG TABLE 
logistics.shipments
  CATALOG = 'SNOWFLAKE'
  EXTERNAL_VOLUME = 'harbr_s3_vol'
  BASE_LOCATION = 'iceberg/shipments/';

Extern gemanagt

  • Externer Katalog besitzt Metadaten – AWS Glue, Apache Polaris
CREATE ICEBERG TABLE 
logistics.partner_data
  CATALOG = 'glue_catalog'
  EXTERNAL_VOLUME = 'harbr_s3_vol'
  CATALOG_TABLE_NAME = 
  'partner.deliveries';
Automatisierung von Datenpipelines in Snowflake

Lass uns üben!

Automatisierung von Datenpipelines in Snowflake

Preparing Video For Download...