Fortgeschrittene Aggregatfunktionen

Automatisierung von Datenpipelines in Snowflake

Emily Melhuish

Technical Curriculum Developer, Snowflake

Reihenfolge der Operationen
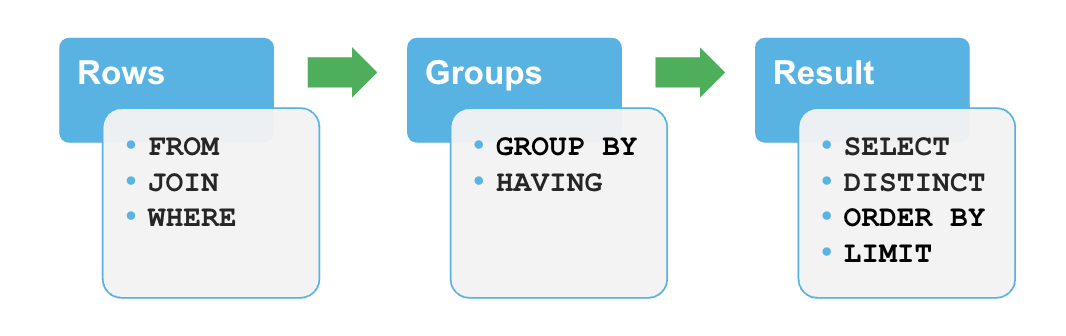
Reihenfolge der Operationen.png

SQL läuft nicht in der Reihenfolge, in der du es schreibst

  1. Zeilen: Datensatz aufbauen
  2. Gruppen: zusammenfassen
  3. Ergebnis: Ausgabe formen
1 * Snowflake Lernmaterial
Automatisierung von Datenpipelines in Snowflake

Häufige Aggregatfunktionen

  • COUNT(*) / COUNT(DISTINCT col) — Gesamtzeilen; eindeutige Werte
  • SUM — Spaltensumme
  • AVG — Mittelwert
  • MIN / MAX — Spannweite
SELECT COUNT(*) AS total_shipments,
       COUNT(DISTINCT carrier_id) AS unique_carriers,
       SUM(delivery_days) AS total_days,
       AVG(delivery_days) AS avg_days
FROM shipments;
Automatisierung von Datenpipelines in Snowflake

Das Problem mit mehreren Abfragen

Nutzung nach Region und Warehouse

SELECT 
region
, warehouse_name
, SUM(credits_used) 
FROM usage 
GROUP BY region, warehouse_name; 

Regionen-Teilsummen der Nutzung

SELECT region
, SUM(credits_used) 
FROM usage GROUP BY region; 

Gesamtnutzung

SELECT 
SUM(credits_used) 
FROM usage;
Automatisierung von Datenpipelines in Snowflake

GROUPING SETS

Eingabe

SELECT region
, warehouse_name
, SUM(credits_used) AS total 
FROM usage 
GROUP BY GROUPING SETS ( 
  (region, warehouse_name)
  , (region)
  , () 
);

Ausgabe

REGION WAREHOUSE_NAME TOTAL
EMEA harbr_wh_prod 1240.50
EMEA harbr_wh_dev 380.00
EMEA NULL 1620.50
APAC harbr_wh_prod 890.25
APAC NULL 890.25
NULL NULL 2510.75
  • Hinweis: Gib NULLs per CASE-Anweisung Bedeutung
Automatisierung von Datenpipelines in Snowflake

ROLLUP

Eingabe

SELECT 
region
, warehouse_name
, SUM(credits_used) AS total 
FROM usage 
GROUP BY ROLLUP (region, warehouse_name);

Ausgabe

REGION WAREHOUSE_NAME TOTAL
EMEA harbr_wh_prod 1240.50
EMEA harbr_wh_dev 380.00
EMEA NULL 1620.50
APAC harbr_wh_prod 890.25
APAC NULL 890.25
NULL NULL 2510.75
Automatisierung von Datenpipelines in Snowflake

CUBE

Eingabe

SELECT 
region
, warehouse_name
, SUM(credits_used) AS total
FROM usage 
GROUP BY CUBE (region, warehouse_name);

Ausgabe

REGION WAREHOUSE_NAME TOTAL
EMEA harbr_wh_prod 1240.50
EMEA harbr_wh_dev 380.00
EMEA NULL 1620.50
APAC harbr_wh_prod 890.25
APAC NULL 890.25 }
NULL harbr_wh_prod 2130.75
NULL harbr_wh_dev 380.00
NULL NULL 2510.75
Automatisierung von Datenpipelines in Snowflake

GROUPING() und GROUPING_ID()

SELECT region, warehouse_name, SUM(credits_used) AS total_credits, GROUPING(region) AS is_region_agg, GROUPING(warehouse_name) AS is_wh_agg , 
GROUPING_ID(region, warehouse_name) AS grouping_level 
FROM usage 
GROUP BY ROLLUP (region, warehouse_name);
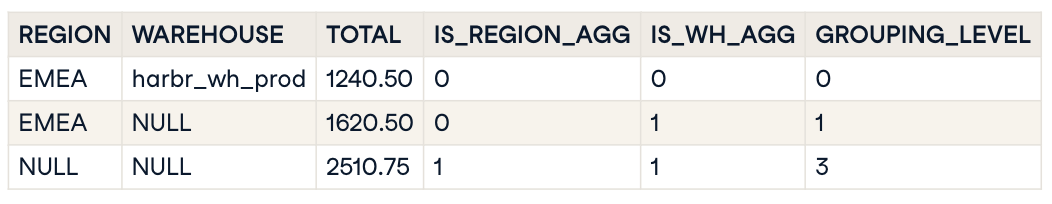
Screenshot der Markdown-Tabellenausgabe

Automatisierung von Datenpipelines in Snowflake

Lass uns üben!

Automatisierung von Datenpipelines in Snowflake

Preparing Video For Download...