Automatización de canalizaciones de datos en Snowflake
Emily Melhuish
Technical Curriculum Developer, Snowflake
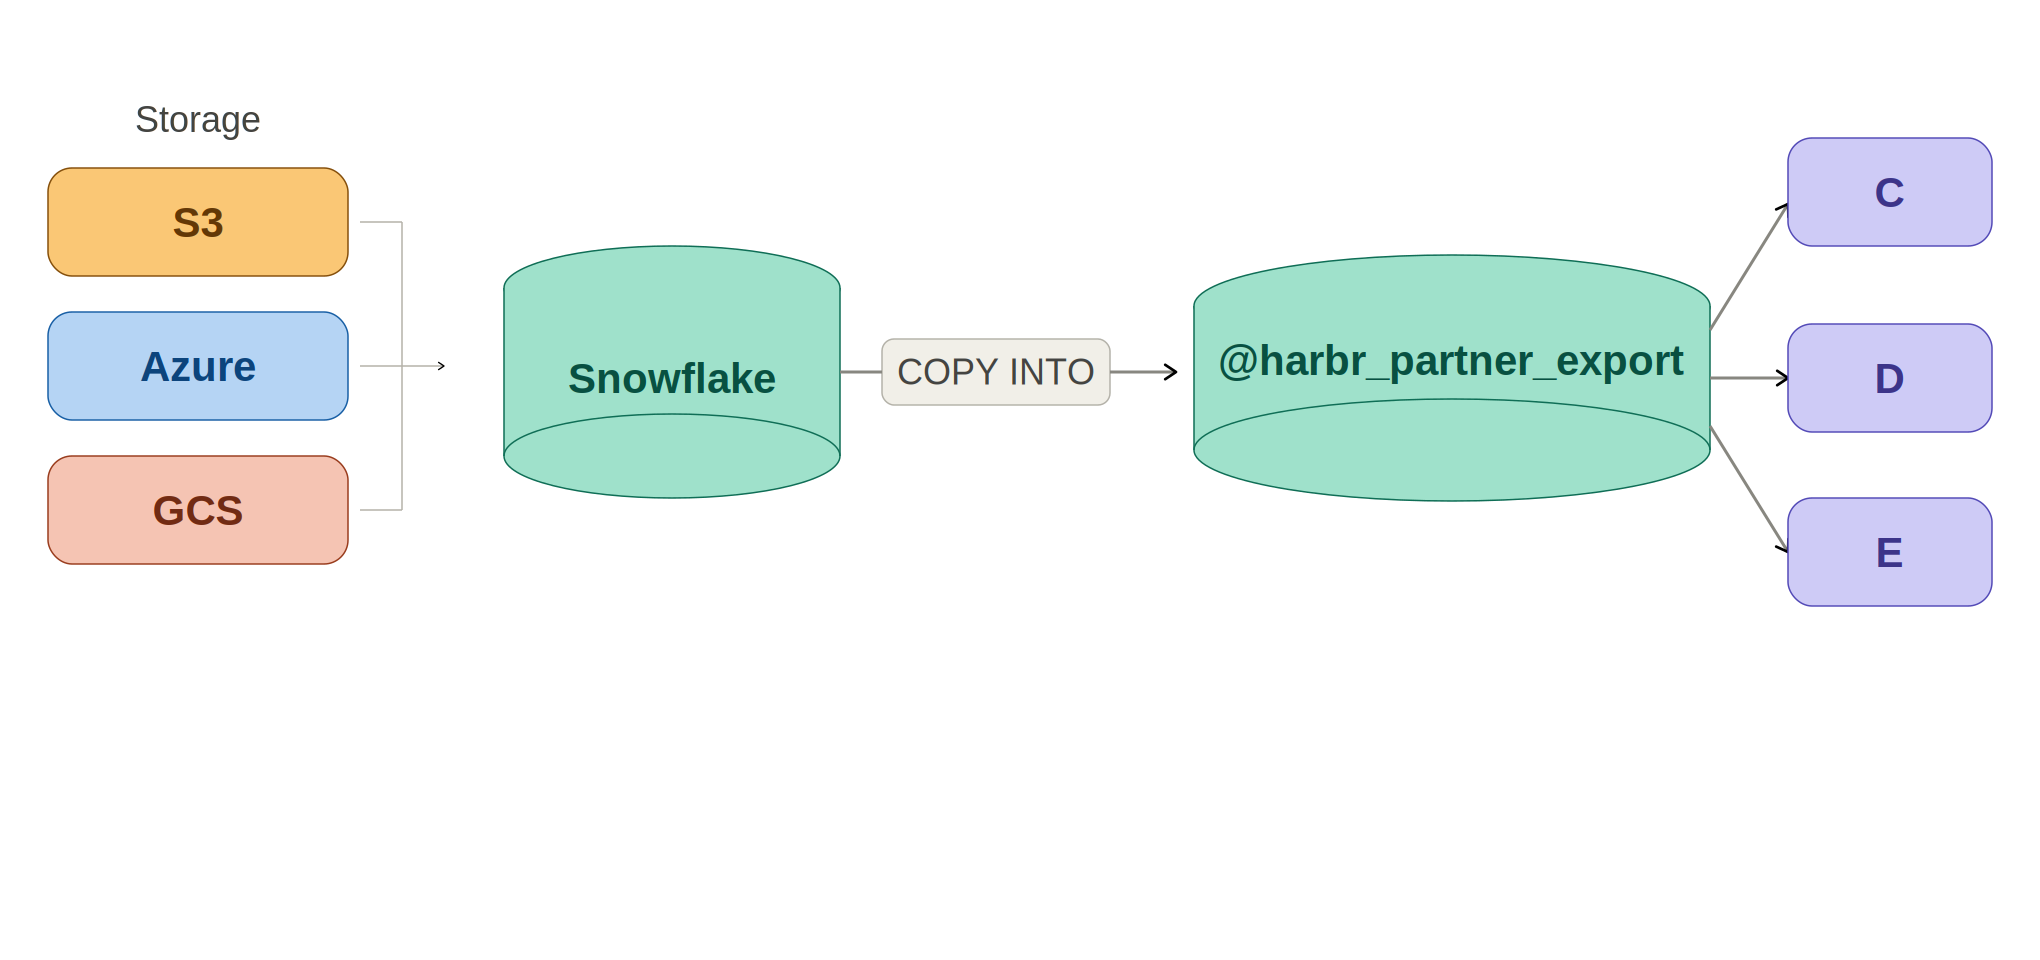
Exportar datos a almacenamiento en la nube
COPY INTO escribe resultados directo en un stageCOPY INTO @harbr_partner_export/
daily_summary/
FROM (SELECT * FROM
logistics.shipment_summary
WHERE export_date =
CURRENT_DATE() - 1);

COPY INTO @harbr_partner_export/shipment_summary/
FROM (
SELECT shipment_id,
origin,
destination,
delivery_status,
delivery_time_hours
FROM logistics.shipments
WHERE delivery_date = CURRENT_DATE()
)
FILE_FORMAT = (TYPE = 'CSV' HEADER = TRUE)
OVERWRITE = TRUE;
| Formato | Mejor para |
|---|---|
| CSV | Universal: casi cualquier sistema lo lee; ideal para exportar a partners |
| JSON | Conserva estructuras anidadas; útil para consumidores semiestructurados |
| Parquet | Grandes datasets analíticos; compresión columnar = archivos más chicos, lecturas más rápidas |
Opciones clave de descarga
-- Divide exportaciones grandes en varios archivos (bytes)
HEADER = TRUE -- incluir nombres de columnas en la primera fila
OVERWRITE = TRUE -- reemplazar archivos existentes en esa ruta
MAX_FILE_SIZE = 104857600 -- 100 MB por archivo de salida

Conector Kafka
# connector.properties (Kafka settings)
snowflake.topic2table.map=events:
delivery_events
snowflake.ingestion.method=
SNOWPIPE_STREAMING
Conector Spark
// Read from Snowflake into a Spark DataFrame
val df = spark.read.format("snowflake")
.options(sfOptions).option("dbtable",
"shipments").load()
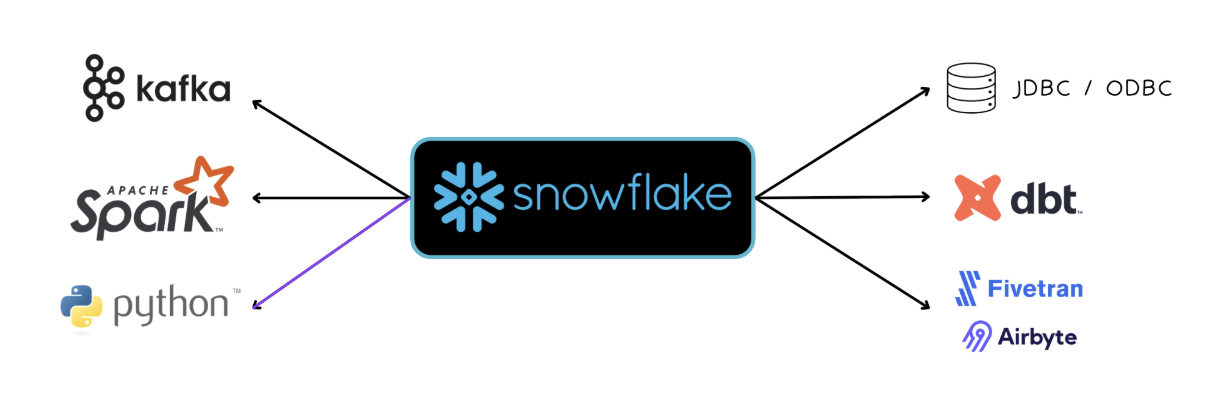
Conectividad universal
| Integración | Tipo | Uso en Harbr |
|---|---|---|
| JDBC / ODBC | Controladores universales | Herramientas BI (Tableau, Power BI, Looker): consulta directa |
| Conector de Python | Driver nativo de Python | Pipelines, ETL programado, ciencia de datos |
| dbt | Transformación SQL | Ejecuta modelos directamente en Snowflake compute |
| Fivetran / Airbyte | Ingesta gestionada | SaaS → Snowflake, sin código a medida |
Automatización de canalizaciones de datos en Snowflake