Imputace průměrem, mediánem a modem

Dealing with Missing Data in Python

Suraj Donthi

Deep Learning & Computer Vision Consultant

Základní techniky imputace

  • konstanta (např. 0)
  • průměr
  • medián
  • modus (nejčastější hodnota)
Dealing with Missing Data in Python

Imputace průměrem

from sklearn.impute import SimpleImputer

diabetes_mean = diabetes.copy(deep=True)
mean_imputer = SimpleImputer(strategy='mean')
Dealing with Missing Data in Python

Imputace průměrem

from sklearn.impute import SimpleImputer
diabetes_mean = diabetes.copy(deep=True)
mean_imputer = SimpleImputer(strategy='mean')
diabetes_mean.iloc[:, :] = mean_imputer.fit_transform(diabetes_mean)
Dealing with Missing Data in Python

Imputace mediánem

diabetes_median = diabetes.copy(deep=True)
median_imputer = SimpleImputer(strategy='median')
diabetes_median.iloc[:, :] = median_imputer.fit_transform(diabetes_median)
Dealing with Missing Data in Python

Imputace modem

diabetes_mode = diabetes.copy(deep=True)
mode_imputer = SimpleImputer(strategy='most_frequent')
diabetes_mode.iloc[:, :] = mode_imputer.fit_transform(diabetes_mode)
Dealing with Missing Data in Python

Imputace konstantou

diabetes_constant = diabetes.copy(deep=True)
constant_imputer = SimpleImputer(strategy='constant', fill_value=0))
diabetes_constant.iloc[:, :] = constant_imputer.fit_transform(diabetes_constant)
Dealing with Missing Data in Python

Bodový graf imputace

nullity = diabetes['Serum_Insulin'].isnull()+diabetes['Glucose'].isnull()
diabetes_mean.plot(x='Serum_Insulin', y='Glucose', kind='scatter', alpha=0.5,

c=nullity, cmap='rainbow', title='Mean Imputation')
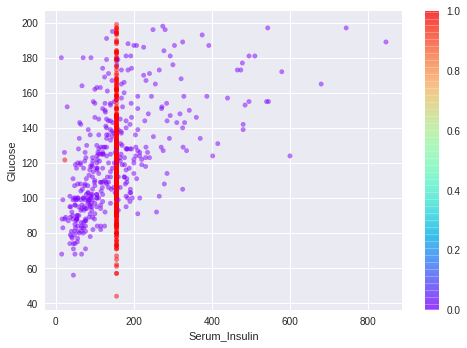
Bodový graf datového rámce diabetes s imputací průměrem

Dealing with Missing Data in Python

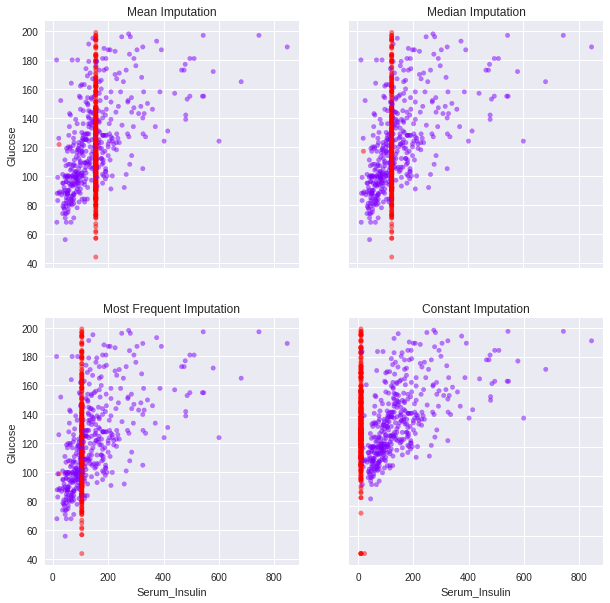
Vizualizace imputací

fig, axes = plt.subplots(nrows=2, ncols=2, figsize=(10, 10))

nullity = diabetes['Serum_Insulin'].isnull()+diabetes['Glucose'].isnull()
imputations = {'Mean Imputation': diabetes_mean, 'Median Imputation': diabetes_median, 'Most Frequent Imputation': diabetes_mode, 'Constant Imputation': diabetes_constant}
for ax, df_key in zip(axes.flatten(), imputations):
imputations[df_key].plot(x='Serum_Insulin', y='Glucose', kind='scatter', alpha=0.5, c=nullity, cmap='rainbow', ax=ax, colorbar=False, title=df_key)
Dealing with Missing Data in Python

Grafická vizualizace imputací datového rámce diabetes

Dealing with Missing Data in Python

Shrnutí

Nyní umíš:

  • Imputovat pomocí statistických parametrů jako průměr, medián a modus
  • Graficky porovnat imputace
  • Analyzovat imputace
Dealing with Missing Data in Python

Pojďme cvičit!

Dealing with Missing Data in Python

Preparing Video For Download...