Czy rzeczywiście dobrze przewidzieliśmy sentyment?

Analiza sentymentu w Pythonie

Violeta Misheva

Data Scientist

Podział na zbiór treningowy i testowy
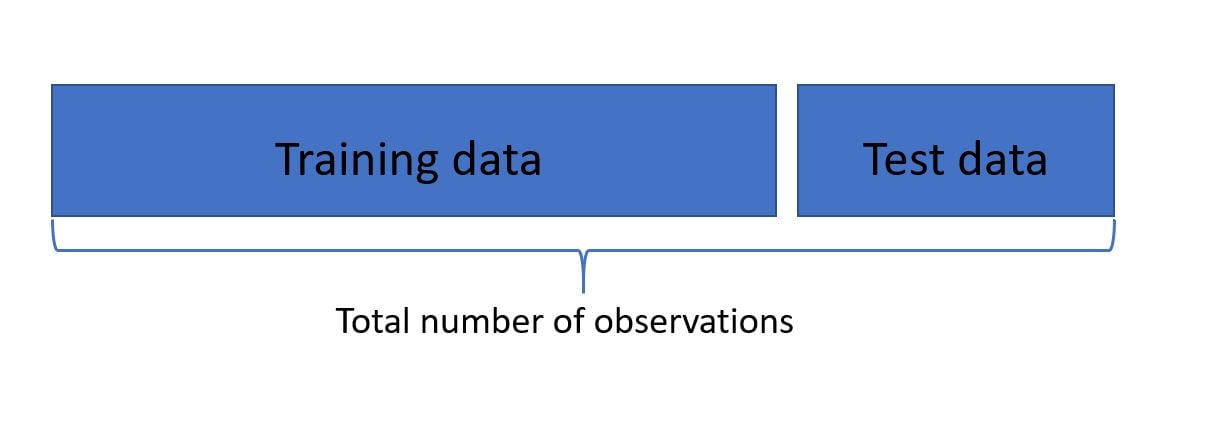
łączna liczba obserwacji podzielona na zbiór treningowy i testowy, gdzie zbiór treningowy jest większy

  • Zbiór treningowy: służy do uczenia modelu (70–80% wszystkich danych)
  • Zbiór testowy: służy do oceny wydajności modelu
Analiza sentymentu w Pythonie

Podział treningowy/testowy w Pythonie

from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=123, stratify=y)
  • X : cechy
  • y : etykiety
  • test_size: udział danych używanych do testowania
  • random_state: generator ziarna podziału
  • stratify: proporcje klas w próbce będą takie same jak w podanym parametrze
Analiza sentymentu w Pythonie

Regresja logistyczna z podziałem treningowym/testowym

log_reg = LogisticRegression().fit(X_train, y_train)
print('Accuracy on training data: ', log_reg.score(X_train, y_train))
0.76
print('Accuracy on testing data: ', log_reg.score(X_test, y_test))
0.73
Analiza sentymentu w Pythonie

Dokładność z podziałem treningowym/testowym

from sklearn.metrics import accuracy_score
log_reg = LogisticRegression().fit(X_train, y_train)
y_predicted = log_reg.predict(X_test)
print('Accuracy score on test data: ', accuracy_score(y_test, y_predicted))
0.73
Analiza sentymentu w Pythonie

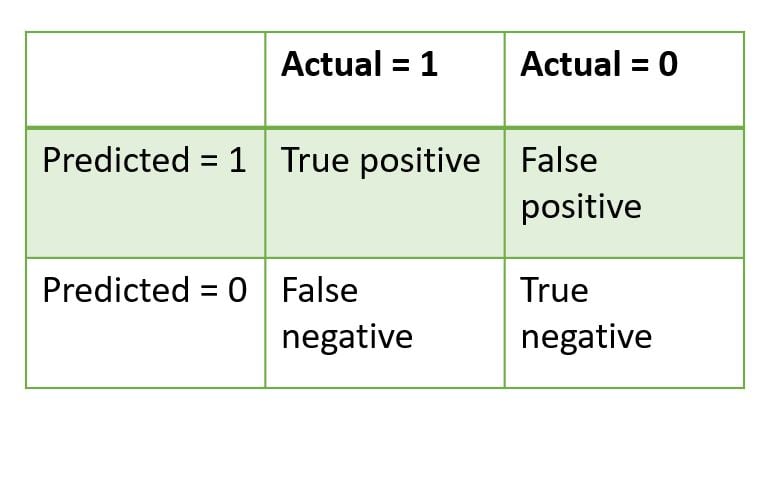
Macierz pomyłek

przykład macierzy pomyłek dla binarnego problemu klasyfikacji

Analiza sentymentu w Pythonie

Macierz pomyłek w Pythonie

from sklearn.metrics import confusion_matrix
log_reg = LogisticRegression().fit(X_train, y_train)
y_predicted = log_reg.predict(X_test)
print(confusion_matrix(y_test, y_predicted)/len(y_test))
[[0.3788 0.1224]
 [0.1352 0.3636]]
Analiza sentymentu w Pythonie

Czas na ćwiczenia!

Analiza sentymentu w Pythonie

Preparing Video For Download...