TfIdf: Więcej sposobów na przekształcanie tekstu

Analiza sentymentu w Pythonie

Violeta Misheva

Data Scientist

Składniki TfIdf

  • TF: częstość terminu: Jak często dane słowo pojawia się w dokumencie z korpusu

  • Odwrotna częstość dokumentowa: Logarytmiczny stosunek całkowitej liczby dokumentów do liczby dokumentów zawierających dane słowo

    • Służy do obliczania wagi słów, które występują rzadko
Analiza sentymentu w Pythonie

Wynik TfIdf słowa

  • Wynik TfIdf:
TfIdf = term frequency * inverse document frequency
  • BOW nie uwzględnia długości dokumentu, TfIdf tak.
  • TfIdf lepiej wychwytuje słowa częste w dokumencie, lecz rzadkie w korpusie.
Analiza sentymentu w Pythonie

Zastosowania TfIdf

Sentyment linii lotniczych na Twitterze
  • Niskie wyniki TfIdf: United, Virgin America
  • Wysokie wyniki TfIdf: proces odprawy (jeśli rzadkie w korpusie)
Więcej o TfIdf
  • Penalizuje częste słowa, więc mniejsza potrzeba jawnego usuwania stop words.
  • Przydatny w wyszukiwaniu i wyszukiwaniu informacji do rankingu trafności wyników.
Analiza sentymentu w Pythonie

TfIdf w Pythonie

# Import the TfidfVectorizer
from sklearn.feature_extraction.text import TfidfVectorizer
  • Argumenty TfidfVectorizer: max_features, ngram_range, stop_words, token_pattern, max_df, min_df
vect = TfidfVectorizer(max_features=100).fit(tweets.text)
X = vect.transform(tweets.text)
Analiza sentymentu w Pythonie

TfidfVectorizer

X
<14640x100 sparse matrix of type '<class 'numpy.float64'>'
    with 119182 stored elements in Compressed Sparse Row format>
X_df = pd.DataFrame(X_txt.toarray(), columns=vect.get_feature_names())
X_df.head()
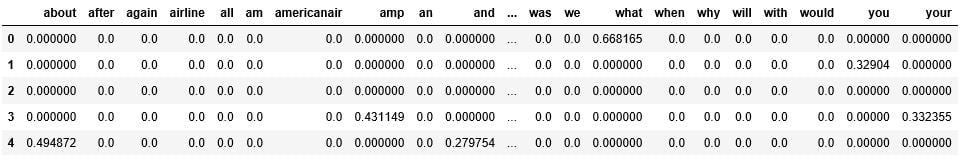
5 pierwszych wierszy danych utworzonych za pomocą TfIdf

Analiza sentymentu w Pythonie

Czas na ćwiczenia!

Analiza sentymentu w Pythonie

Preparing Video For Download...