Wprowadzenie do głębokiego Q-learningu
Głębokie uczenie ze wzmocnieniem w Pythonie

Timothée Carayol
Principal Machine Learning Engineer, Komment
Czym jest głęboki Q-learning?
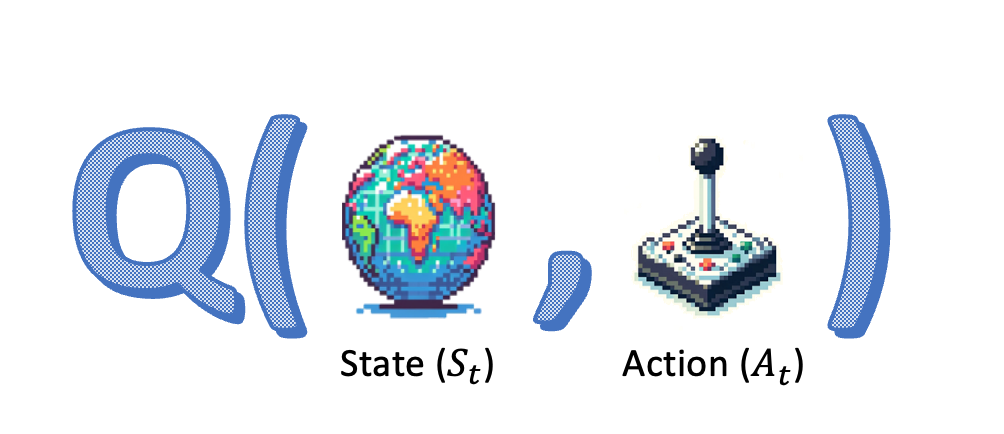
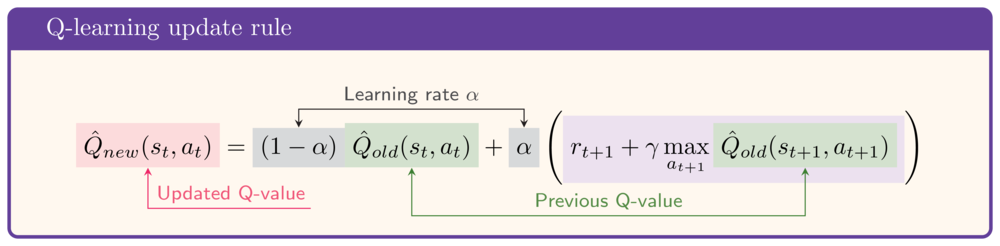
Przypomnienie Q-learningu
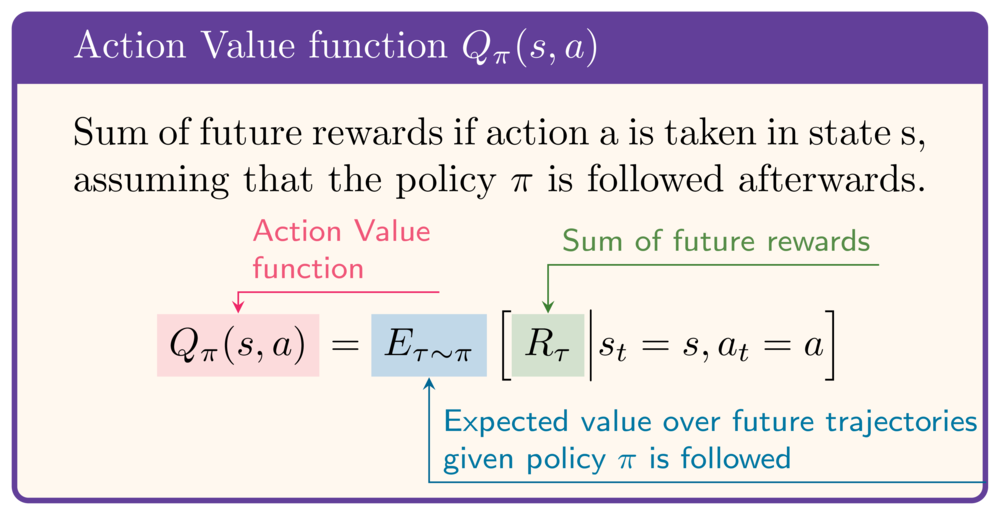
Przypomnienie Q-learningu
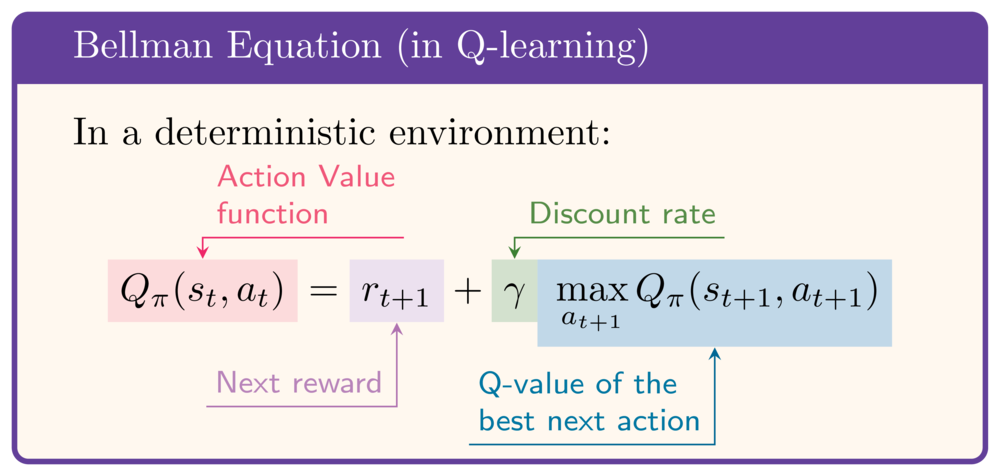
- Równanie Bellmana: rekurencyjna formuła dla $Q$
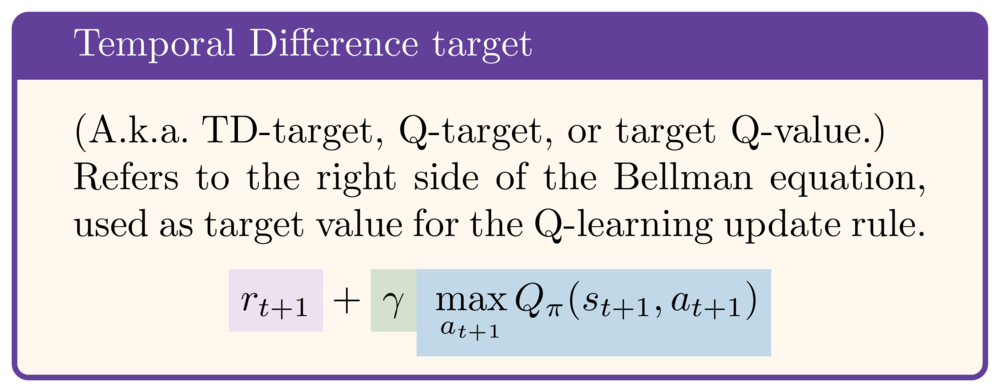
- Prawa strona równania Bellmana: „TD-target"
- TD-target służy do aktualizacji $\hat{Q}$ po każdym kroku
Sieć Q
Sieć Q
Sieć Q
Sieć Q
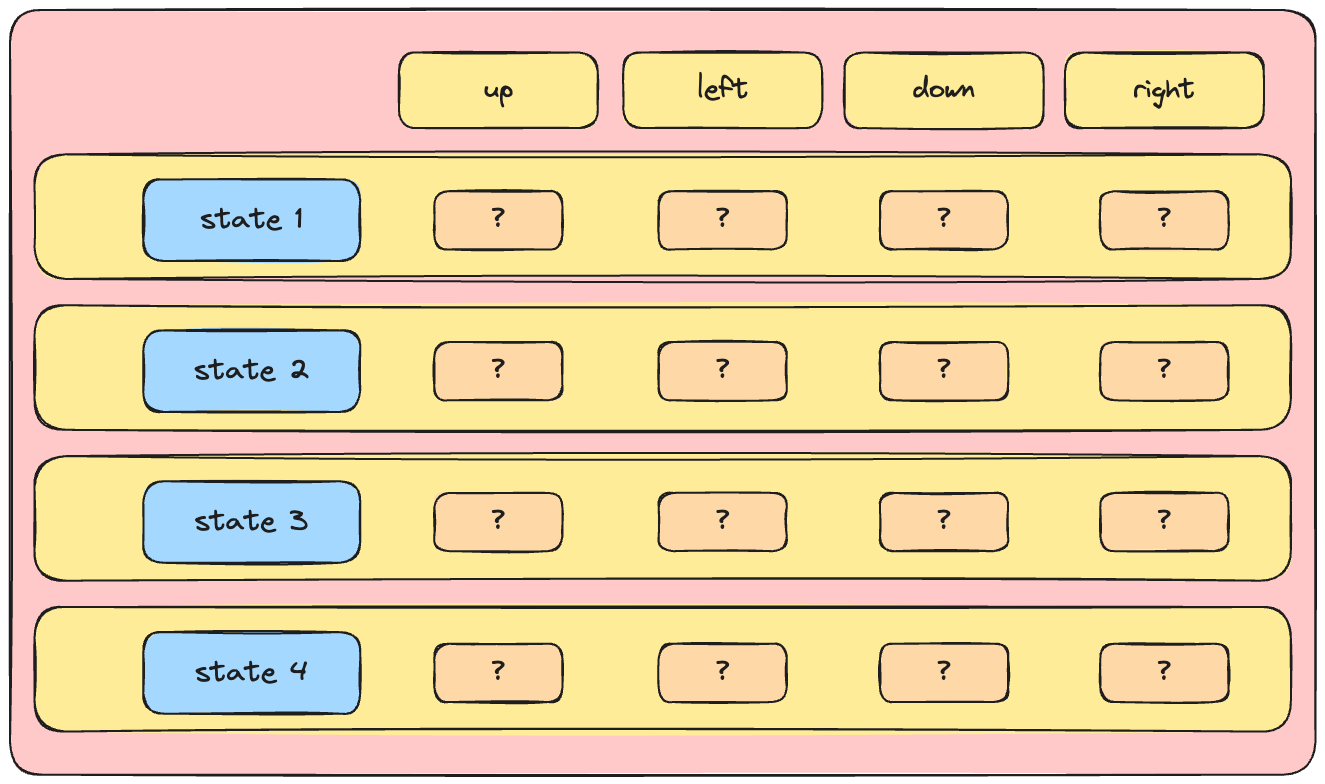
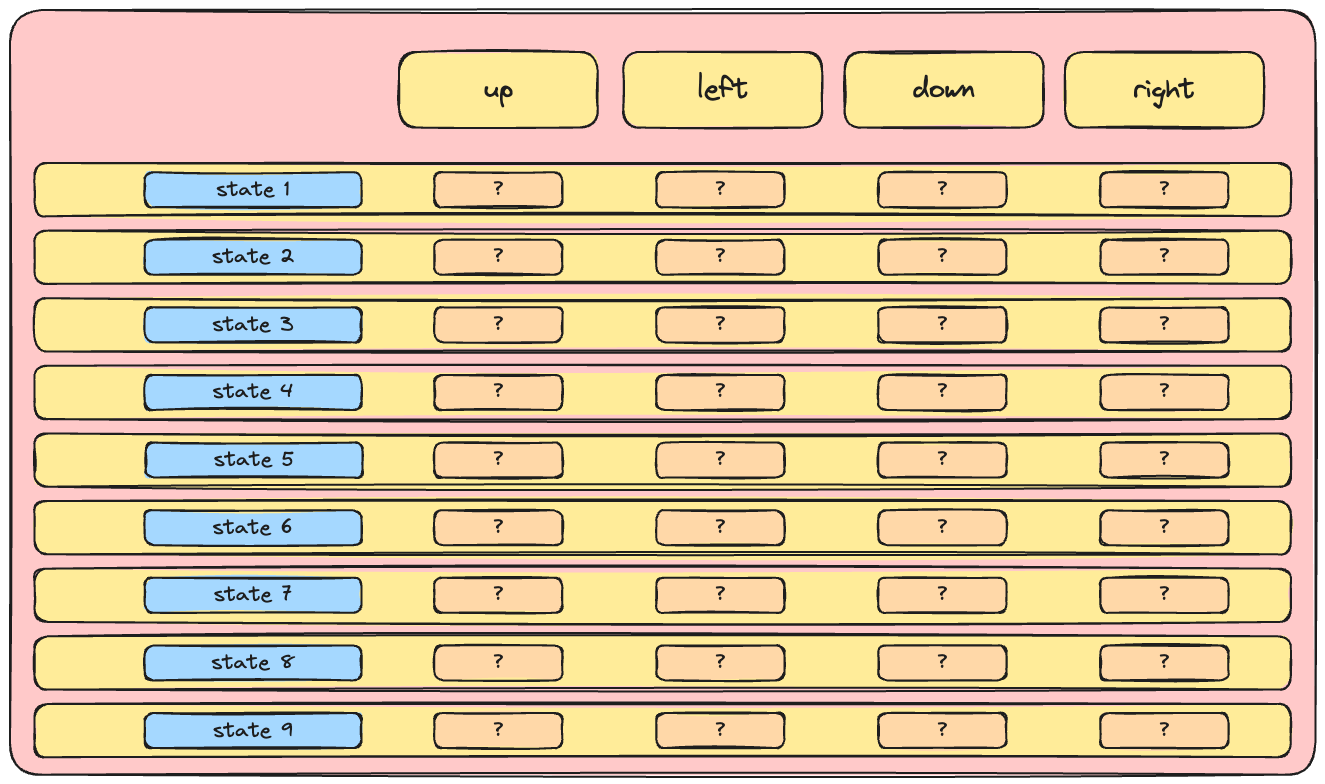
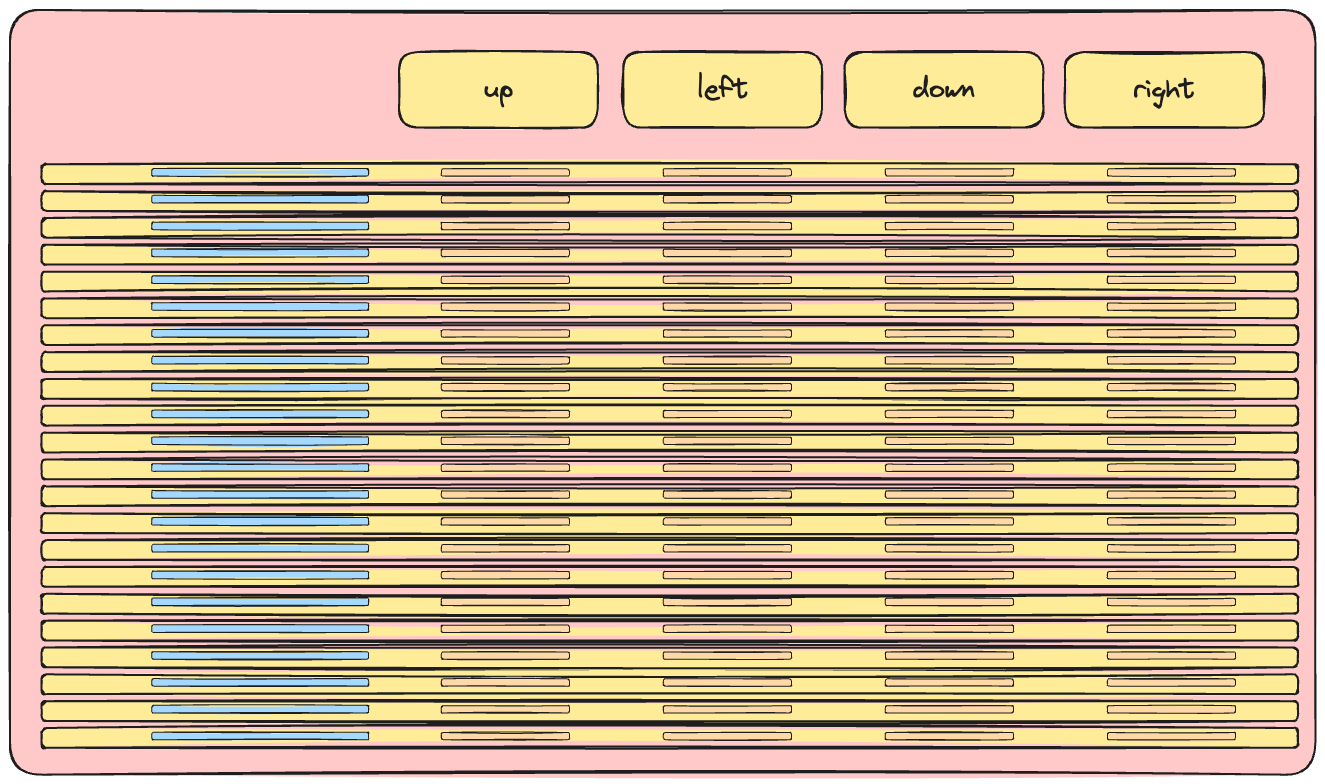
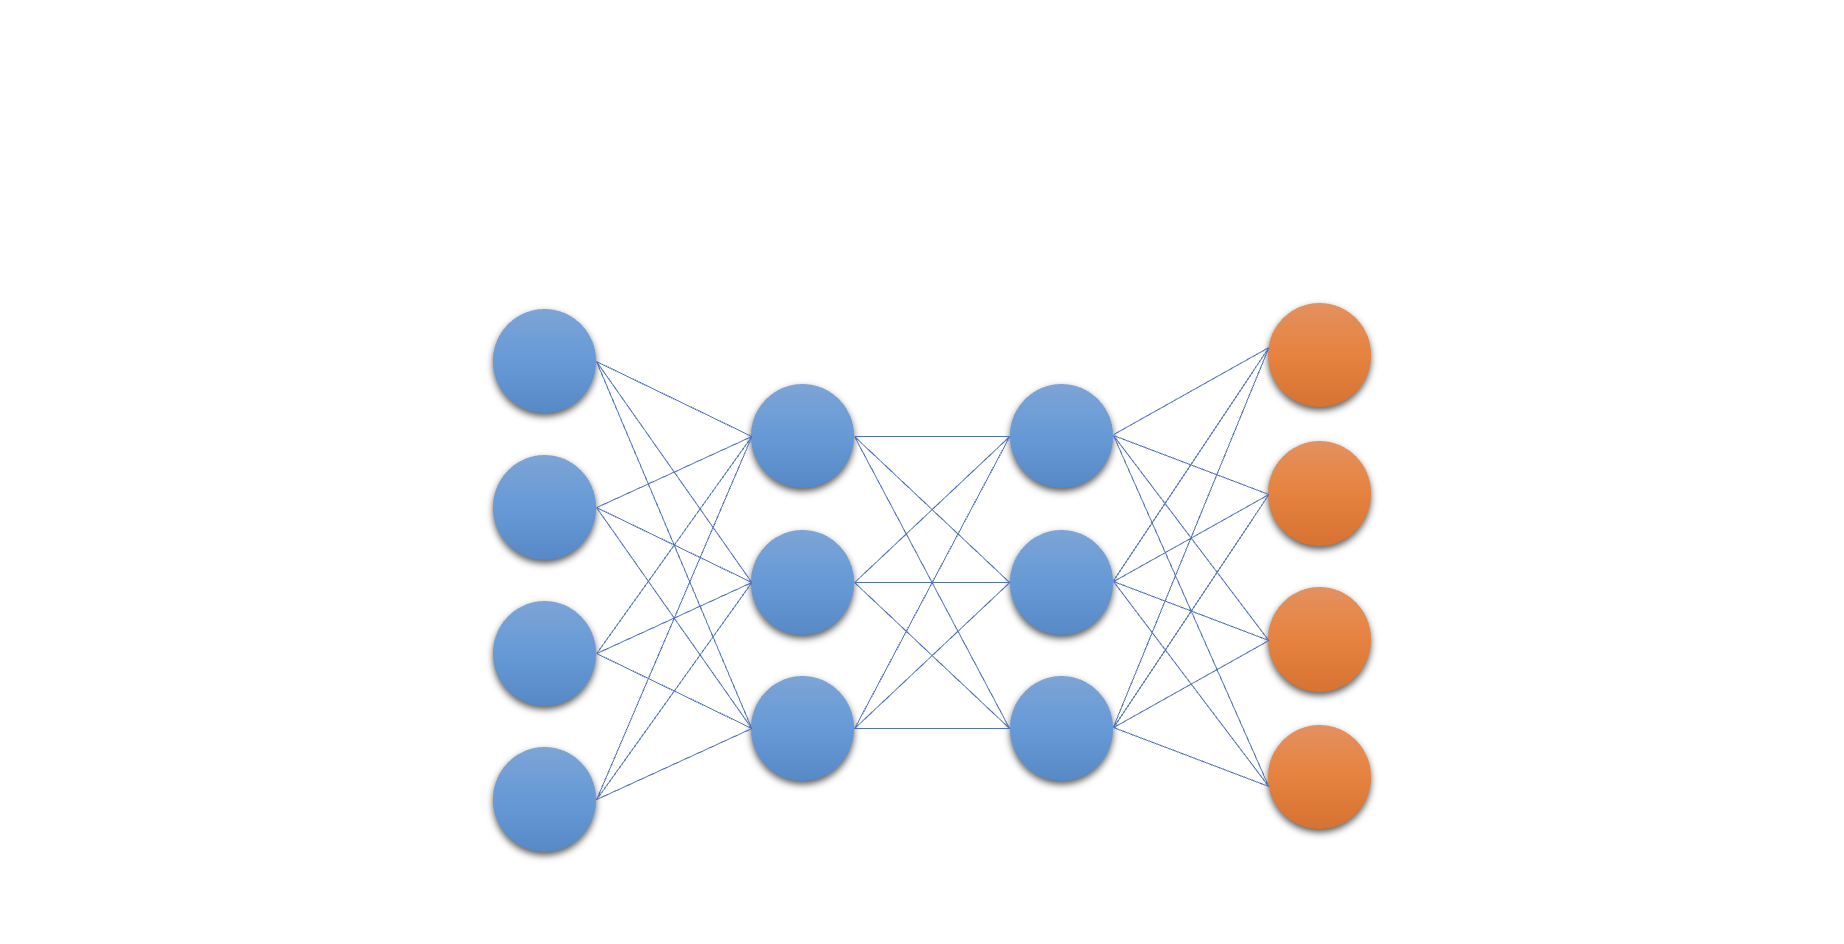
- Rdzeń głębokiego Q-learningu: sieć neuronowa
Sieć Q
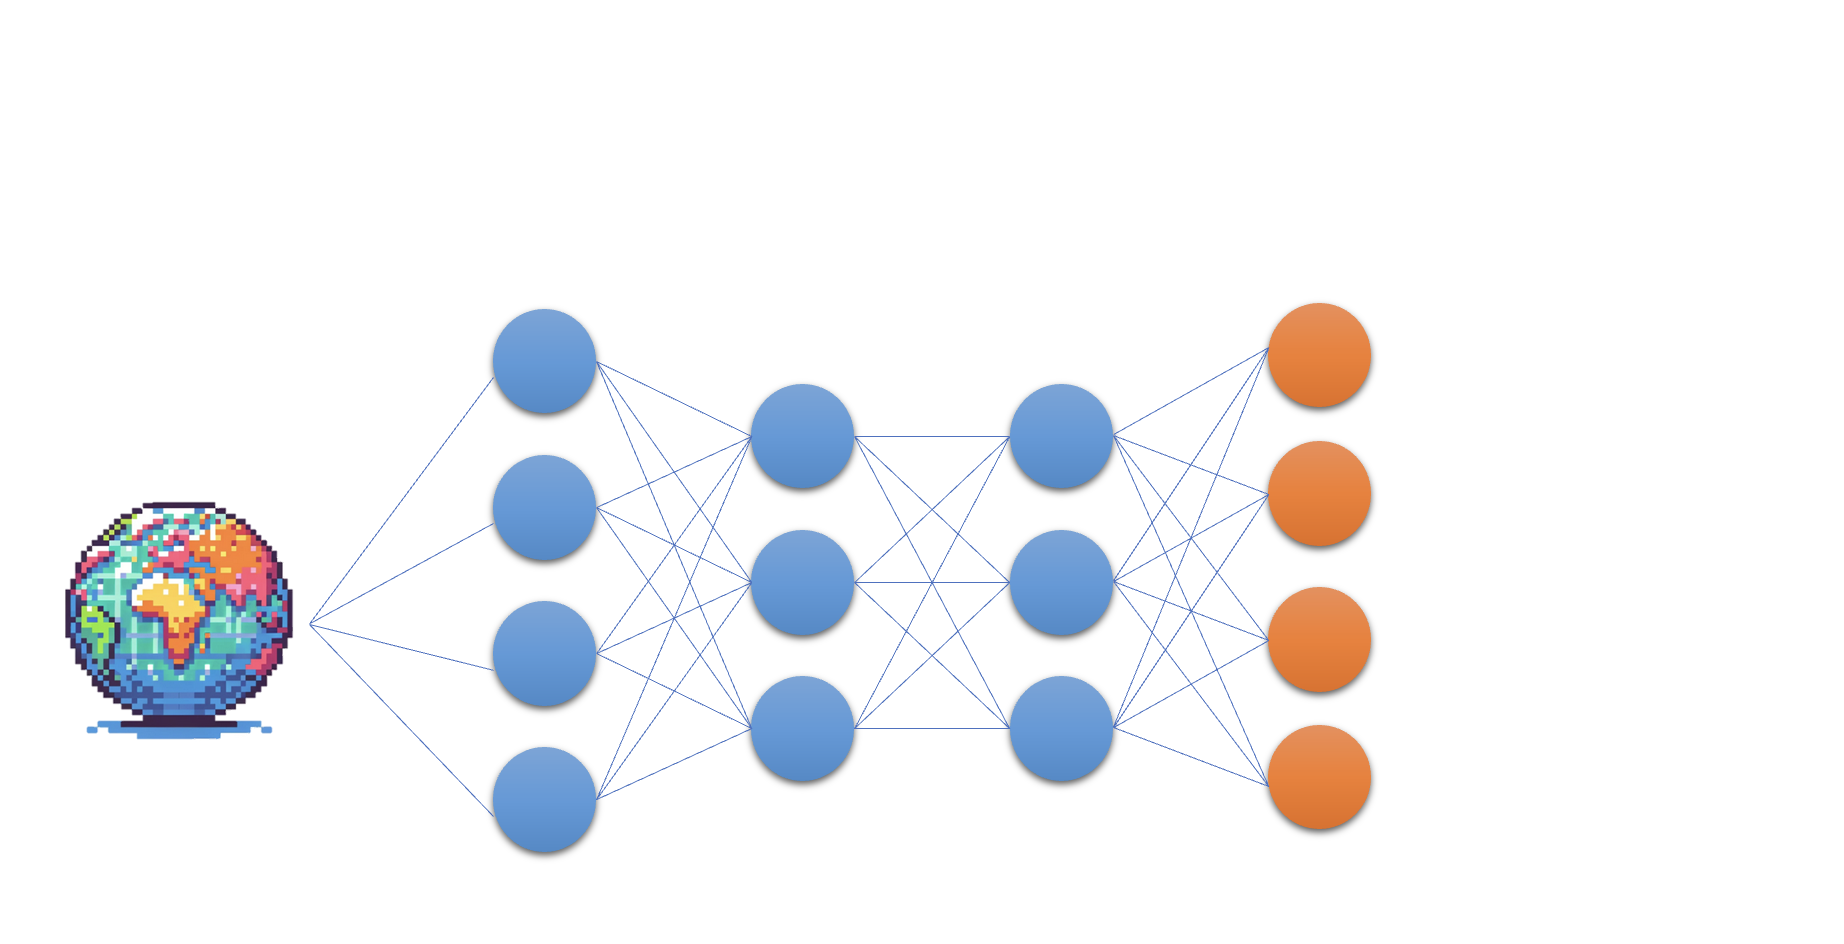
- Rdzeń głębokiego Q-learningu: sieć neuronowa
Sieć Q
- Rdzeń głębokiego Q-learningu: sieć neuronowa mapująca stany na wartości Q
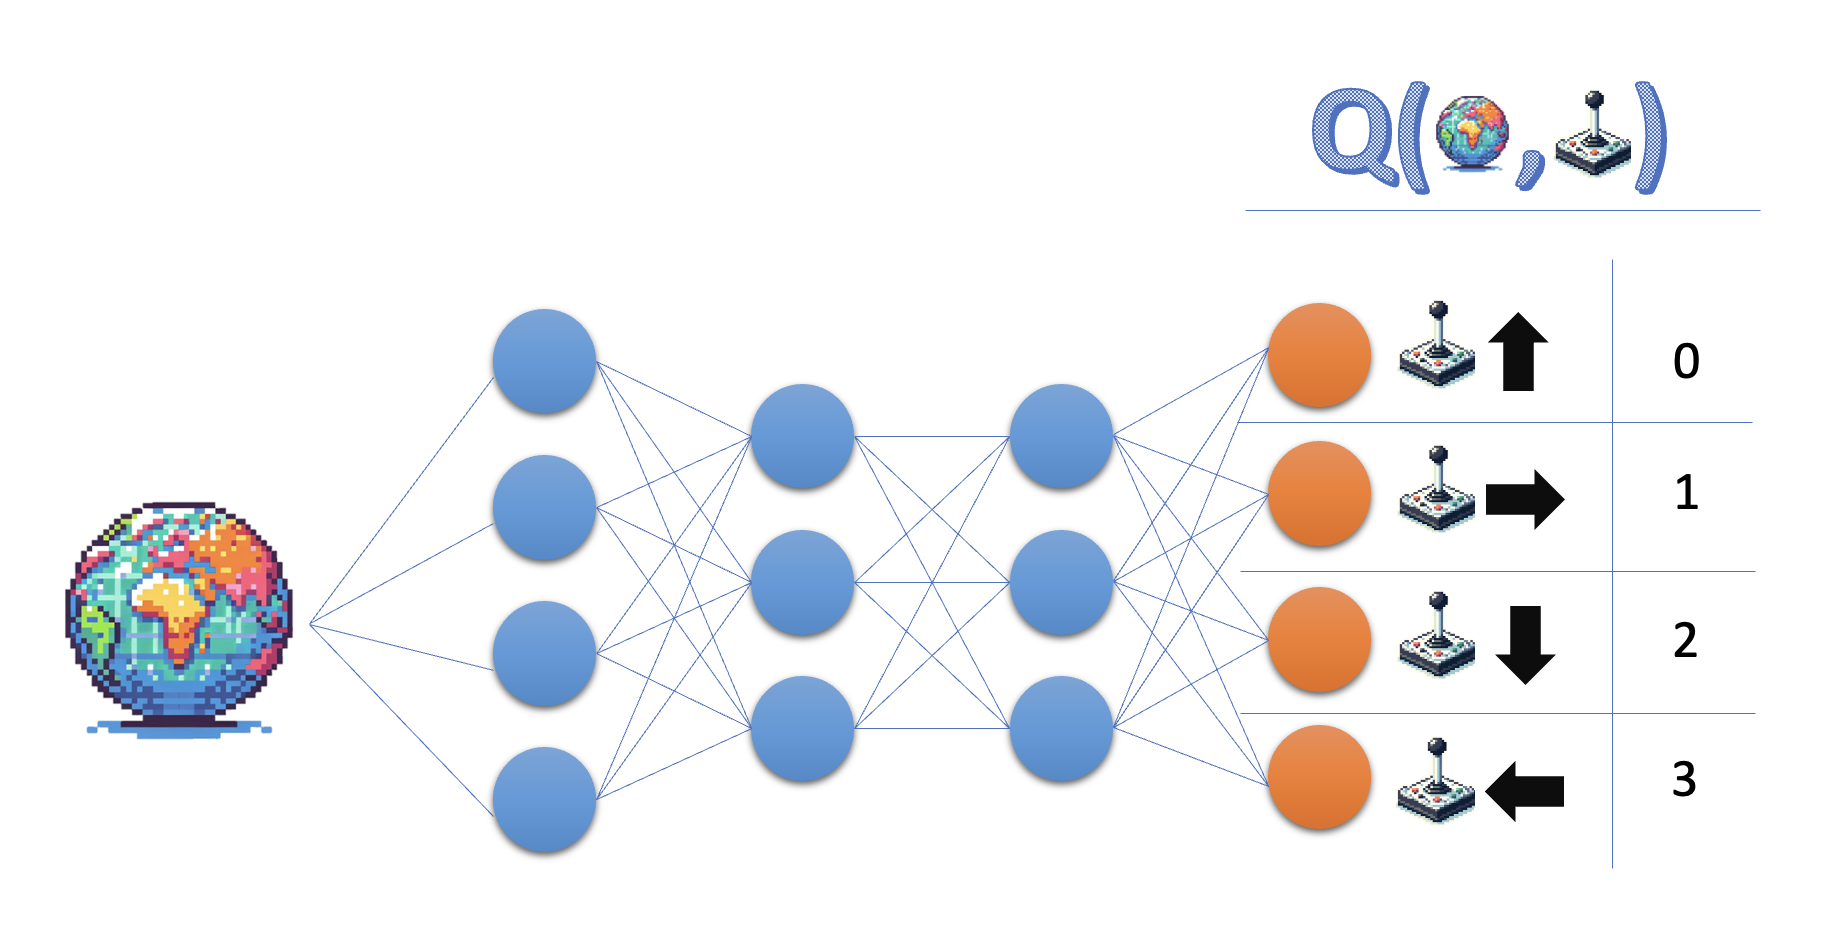
- Sieć aproksymująca funkcję wartości akcji nazywa się „siecią Q"
- Sieci Q są powszechnie stosowane w algorytmach głębokiego Q-learningu, np. DQN.

