DQN z powtarzaniem doświadczeń

Głębokie uczenie ze wzmocnieniem w Pythonie

Timothée Carayol

Principal Machine Learning Engineer, Komment

Wprowadzenie do powtarzania doświadczeń
 

  • Podstawowy agent DQN uczy się wyłącznie z ostatniego doświadczenia
    • Kolejne aktualizacje są silnie skorelowane
    • Agent jest zapominalski
  • Rozwiązanie: powtarzanie doświadczeń
    • Przechowywanie doświadczeń w buforze
    • Na każdym kroku uczenie się z losowej partii przeszłych doświadczeń


Lotnicze zdjęcie labiryntu z żywopłotu

Głębokie uczenie ze wzmocnieniem w Pythonie

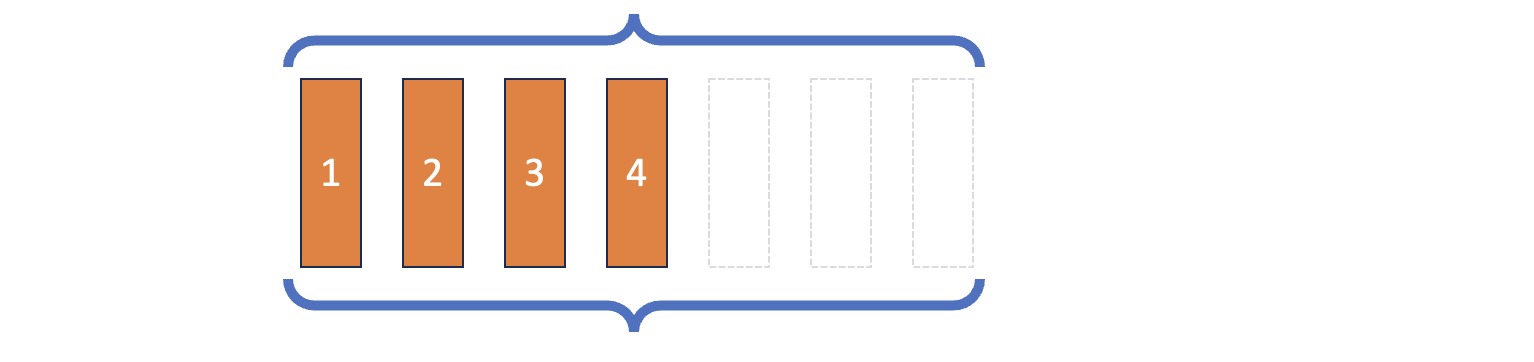
Kolejka dwustronna


from collections import deque

# Instantiate with limited capacity buffer = deque([1,2,3,4], maxlen=7)
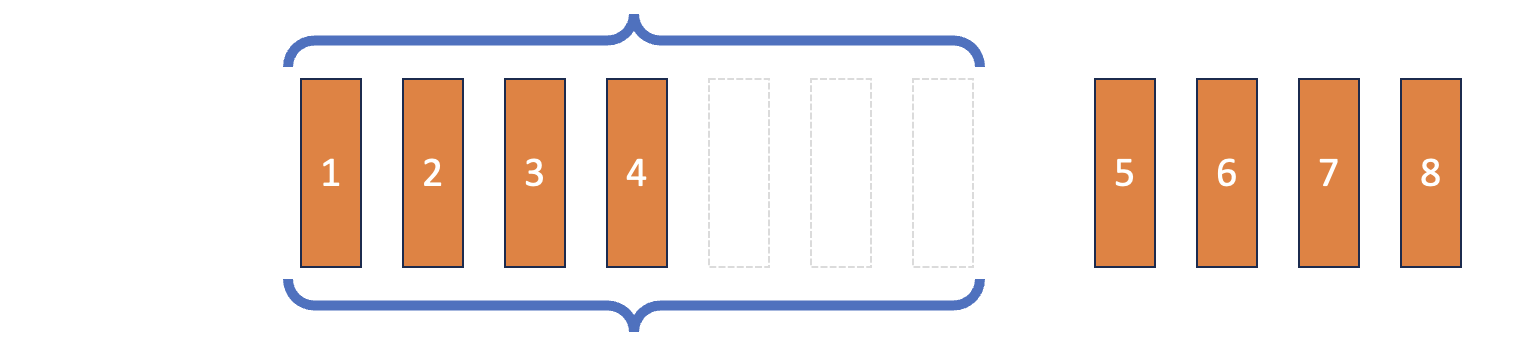
# Extend to the right side buffer.extend([5,6,7,8])
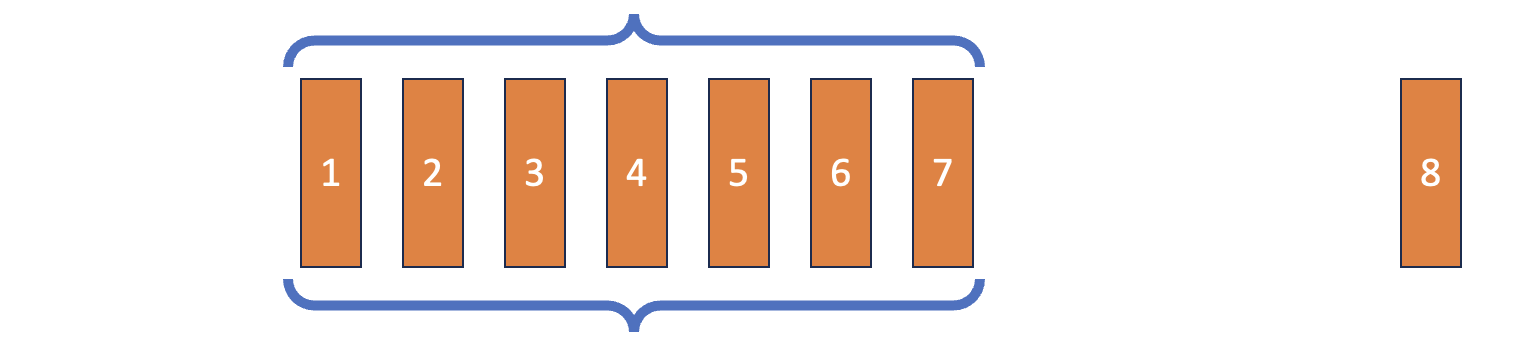
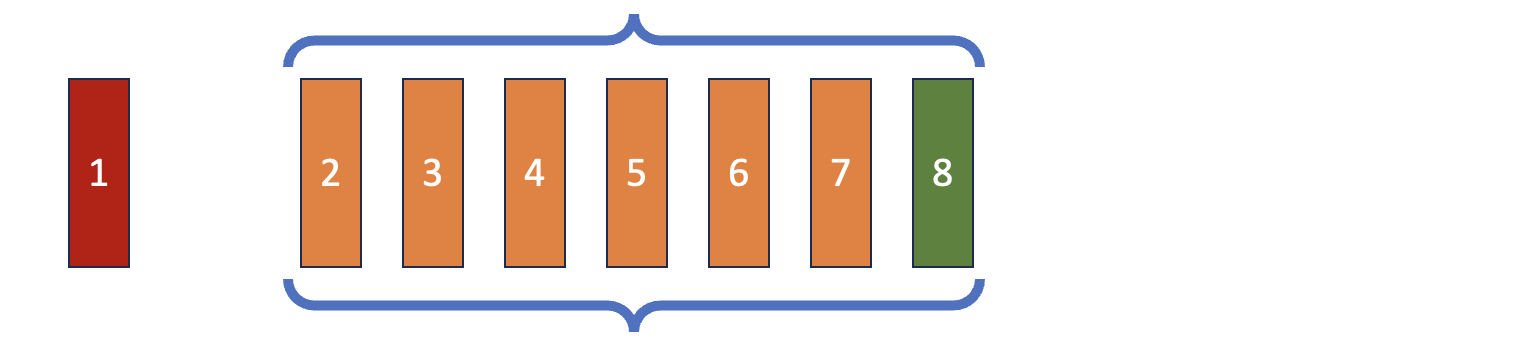
  • Po przekroczeniu pojemności najstarsze elementy są usuwane

Kolejka deque o pojemności siedmiu elementów, zawierająca cztery elementy oznaczone liczbami od jeden do cztery.

Kolejka deque o pojemności siedmiu elementów, zawierająca cztery elementy oznaczone liczbami od jeden do cztery. Po prawej widoczne są cztery dodatkowe elementy oznaczone liczbami od pięć do osiem.

Kolejka deque o pojemności siedmiu elementów, zawierająca siedem elementów oznaczonych liczbami od jeden do siedem. Po prawej widoczny jest jeden dodatkowy element oznaczony liczbą 8.

Kolejka deque o pojemności siedmiu elementów, zawierająca siedem elementów oznaczonych liczbami od dwa do osiem. Po lewej widoczny jest jeden dodatkowy element oznaczony liczbą 1.

Głębokie uczenie ze wzmocnieniem w Pythonie

Implementacja bufora powtórek

import random

class ReplayBuffer:
def __init__(self, capacity):
self.memory = deque([], maxlen=capacity)
def push(self, state, action, reward, next_state, done):
experience_tuple = (state, action, reward, next_state, done)
self.memory.append(experience_tuple)
def __len__(self): return len(self.memory)
...
  • Pamięć powtórek: deque o ograniczonej pojemności
  • .push():
    • Doświadczenie jako krotka przejścia
    • Dodanie doświadczenia do bufora
    • Po osiągnięciu pojemności: usunięcie najstarszego doświadczenia
Głębokie uczenie ze wzmocnieniem w Pythonie

Implementacja bufora powtórek

...
def sample(self, batch_size):

batch = random.sample(self.memory, batch_size)
states, actions, rewards, next_states, dones = ( zip(*batch))
states_tensor = torch.tensor( states, dtype=torch.float32) ... # repeat identically for # rewards, next_states, dones
actions_tensor = torch.tensor( actions, dtype=torch.long).unsqueeze(1)
return states_tensor, actions_tensor, rewards_tensor, next_states_tensor, dones_tensor


  • Losowe pobieranie z przeszłych doświadczeń
  • batch: z listy krotek przejść...
  • ...do krotki list...
  • ...do krotki tensorów PyTorch
Głębokie uczenie ze wzmocnieniem w Pythonie

Integracja powtarzania doświadczeń w DQN

  1. Przed pętlą treningową: replay_buffer = ReplayBuffer(10000)

  2. W pętli treningowej, po wyborze akcji:

replay_buffer.push((state, action, 
                    reward, next_state, done))

if len(replay_buffer) >= batch_size:
states, actions, rewards, next_states, dones = ( replay_buffer.sample(batch_size))
q_values = ( q_network(states).gather(1, actions).squeeze(1))
next_states_q_values = q_network(next_states).amax(1)
target_q_values = ( rewards + gamma * next_states_q_values * (1-dones))
loss = nn.MSELoss()(target_q_values, q_values)
  • Inicjalizacja bufora powtórek
  • Dodanie ostatniego przejścia do bufora

Jeśli długość bufora $\geq$ batch_size:

  • Losowe pobieranie partii z bufora i obliczanie straty
  • Obliczanie straty koncepcyjnie niezmienione
  • Średni kwadratowy błąd Bellmana na partii z pamięci powtórek
    • Nauka jest bardziej stabilna i efektywna
Głębokie uczenie ze wzmocnieniem w Pythonie

Czas na ćwiczenia!

Głębokie uczenie ze wzmocnieniem w Pythonie

Preparing Video For Download...