Kompletny algorytm DQN

Głębokie uczenie ze wzmocnieniem w Pythonie

Timothée Carayol

Principal Machine Learning Engineer, Komment

Algorytm DQN


  • Omówiliśmy DQN z Experience Replay
  • Bliskie oryginalnej publikacji DQN (2015)
  • Brakuje jeszcze dwóch elementów:
    • Epsilon-chciwość -> większa eksploracja
    • Stałe Q-targety -> stabilniejsze uczenie

Awanturniczka stoi z grecką literą epsilon u boku

Wielka litera Q zamrożona w bryle lodu

Głębokie uczenie ze wzmocnieniem w Pythonie

Epsilon-chciwość w algorytmie DQN

  • Implementacja malejącej epsilon-chciwości w select_action()
def select_action(q_values, step, start, end, decay):

# Calculate the threshold value for this step epsilon = ( end + (start-end) * math.exp(-step / decay))
# Draw a random number between 0 and 1 sample = random.random()
if sample < epsilon: # Return a random action index return random.choice(range(len(q_values)))
# Return the action index with highest Q-value return torch.argmax(q_values).item()
  • $\varepsilon = end + (start-end) \cdot e^{-\frac{step}{decay}}$
  • Losowa akcja z prawdopodobieństwem $\varepsilon$
  • Akcja o najwyższej wartości z prawdopodobieństwem $1 - \varepsilon$
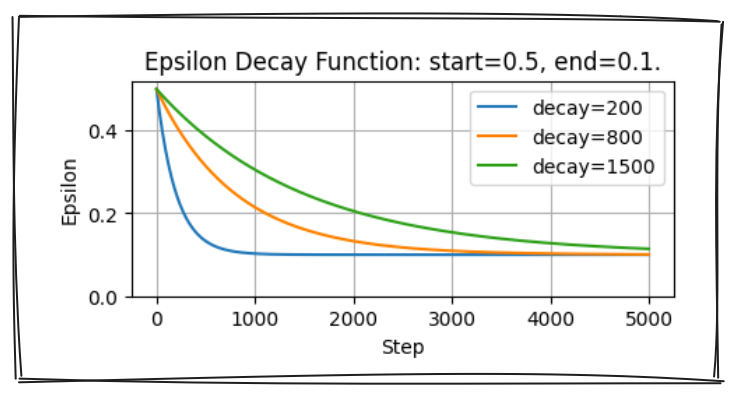
Wykres harmonogramu zaniku epsilon dla różnych wartości parametru decay.

Głębokie uczenie ze wzmocnieniem w Pythonie

Stałe Q-targety


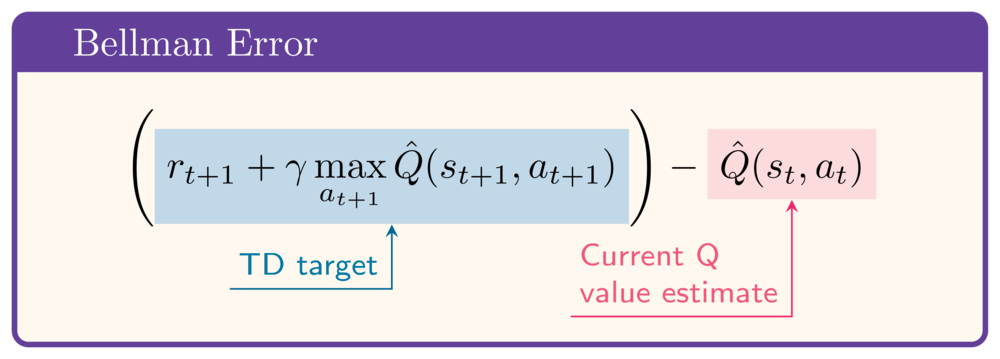
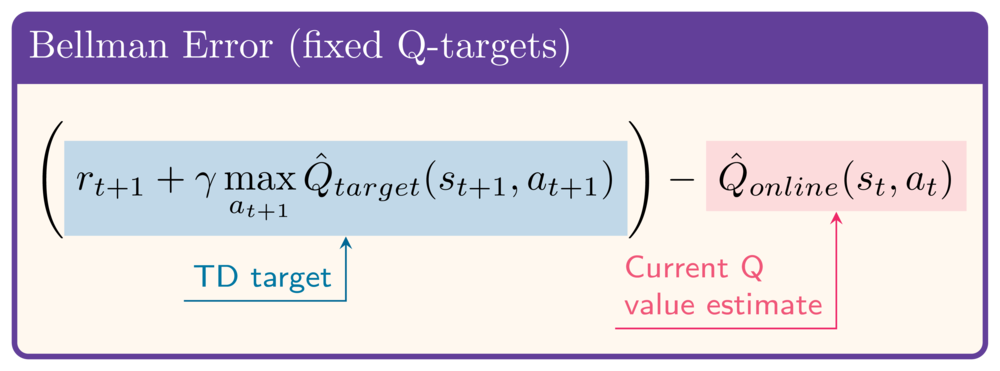
  • W błędzie Bellmana:
    • Q-Network w obliczeniach zarówno Q-Value, jak i TD-Target
    • Niestabilność wynikająca z przesuwającego się targetu


  • Wprowadzenie target network stabilizuje target


Błąd Bellmana: (r_t+1 + gamma max(Q(s_t+1, a))) - Q(s_t, a_t)

(r_t+1 + gamma max(Q_target(s_t+1, a))) - Q_online(s_t, a_t)

Głębokie uczenie ze wzmocnieniem w Pythonie

Implementacja stałych Q-targetów

online_network = QNetwork(state_size, action_size)
target_network = QNetwork(state_size, action_size)

target_network.load_state_dict( online_network.state_dict())
def update_target_network( target_network, online_network, tau):
target_net_state_dict = target_network.state_dict() online_net_state_dict = online_network.state_dict() for key in online_net_state_dict:
target_net_state_dict[key] = ( online_net_state_dict[key] * tau + target_net_state_dict[key] * (1 - tau))
target_network.load_state_dict( target_net_state_dict)
return None
  • Początkowo Online Network = Target Network
  • Słownik stanu sieci zawiera wszystkie wagi: Reprezentacja słownika stanu sieci z wpisami fc1.weight, fc1.bias i fc2.weight; wartość każdego wpisu to tensor.
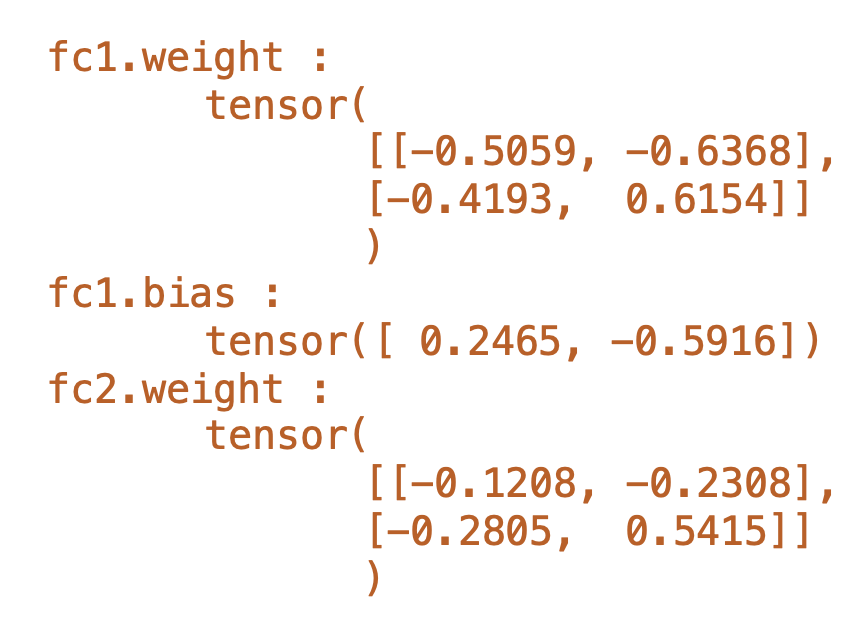
  • W każdym kroku wagi Target Network zbliżają się do Online Network
Głębokie uczenie ze wzmocnieniem w Pythonie

Obliczanie straty ze stałymi Q-targetami

# In the inner loop, after action selection
if len(replay_buffer) >= batch_size:
  states, actions, rewards, next_states, dones = 
      replay_buffer.sample(64)

q_values = (online_network(states) .gather(1, actions).squeeze(1))
with torch.no_grad():
next_q_values = ( target_network(next_states).amax(1)) target_q_values = ( rewards + gamma * next_q_values * (1 - dones))
loss = torch.nn.MSELoss()(target_q_values, q_values) optimizer.zero_grad() loss.backward() optimizer.step()
update_target_network( target_network, online_network, tau)


  • Wartości Q używają online_network
  • Docelowe wartości Q używają target_network
  • torch.no_grad() wyłącza śledzenie gradientów dla docelowych wartości Q
  • Błąd Bellmana (MSE) nadal służy do obliczania straty
  • update_target_network() stopniowo aktualizuje target_network
Głębokie uczenie ze wzmocnieniem w Pythonie

Czas na ćwiczenia!

Głębokie uczenie ze wzmocnieniem w Pythonie

Preparing Video For Download...