Aktualizacje wsadowe w gradiencie strategii

Głębokie uczenie ze wzmocnieniem w Pythonie

Timothée Carayol

Principal Machine Learning Engineer, Komment

Aktualizacje krokowe vs. wsadowe
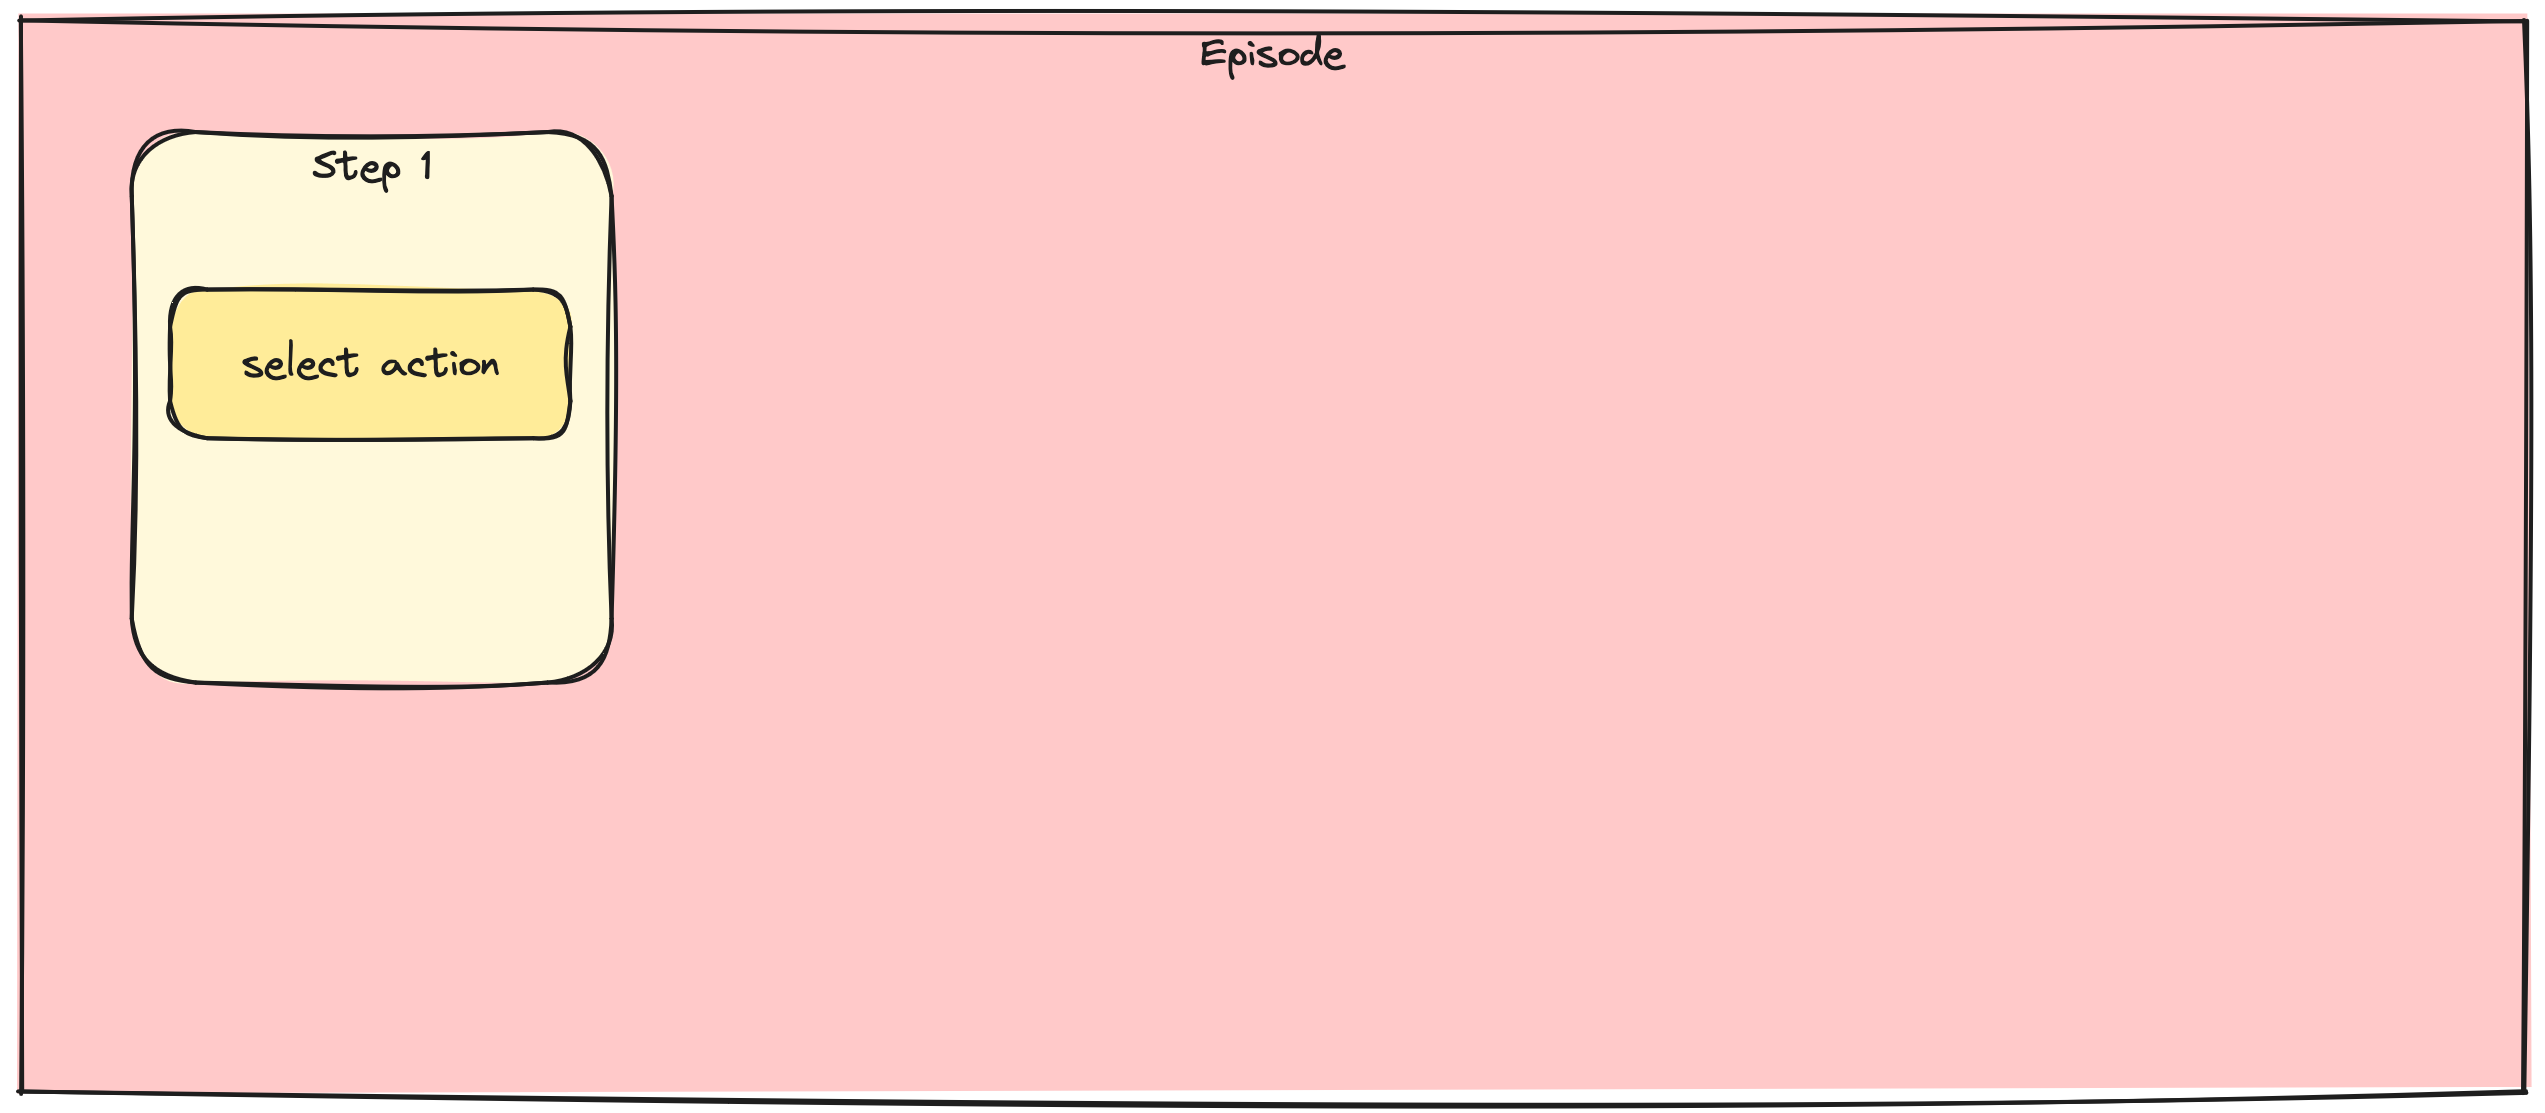
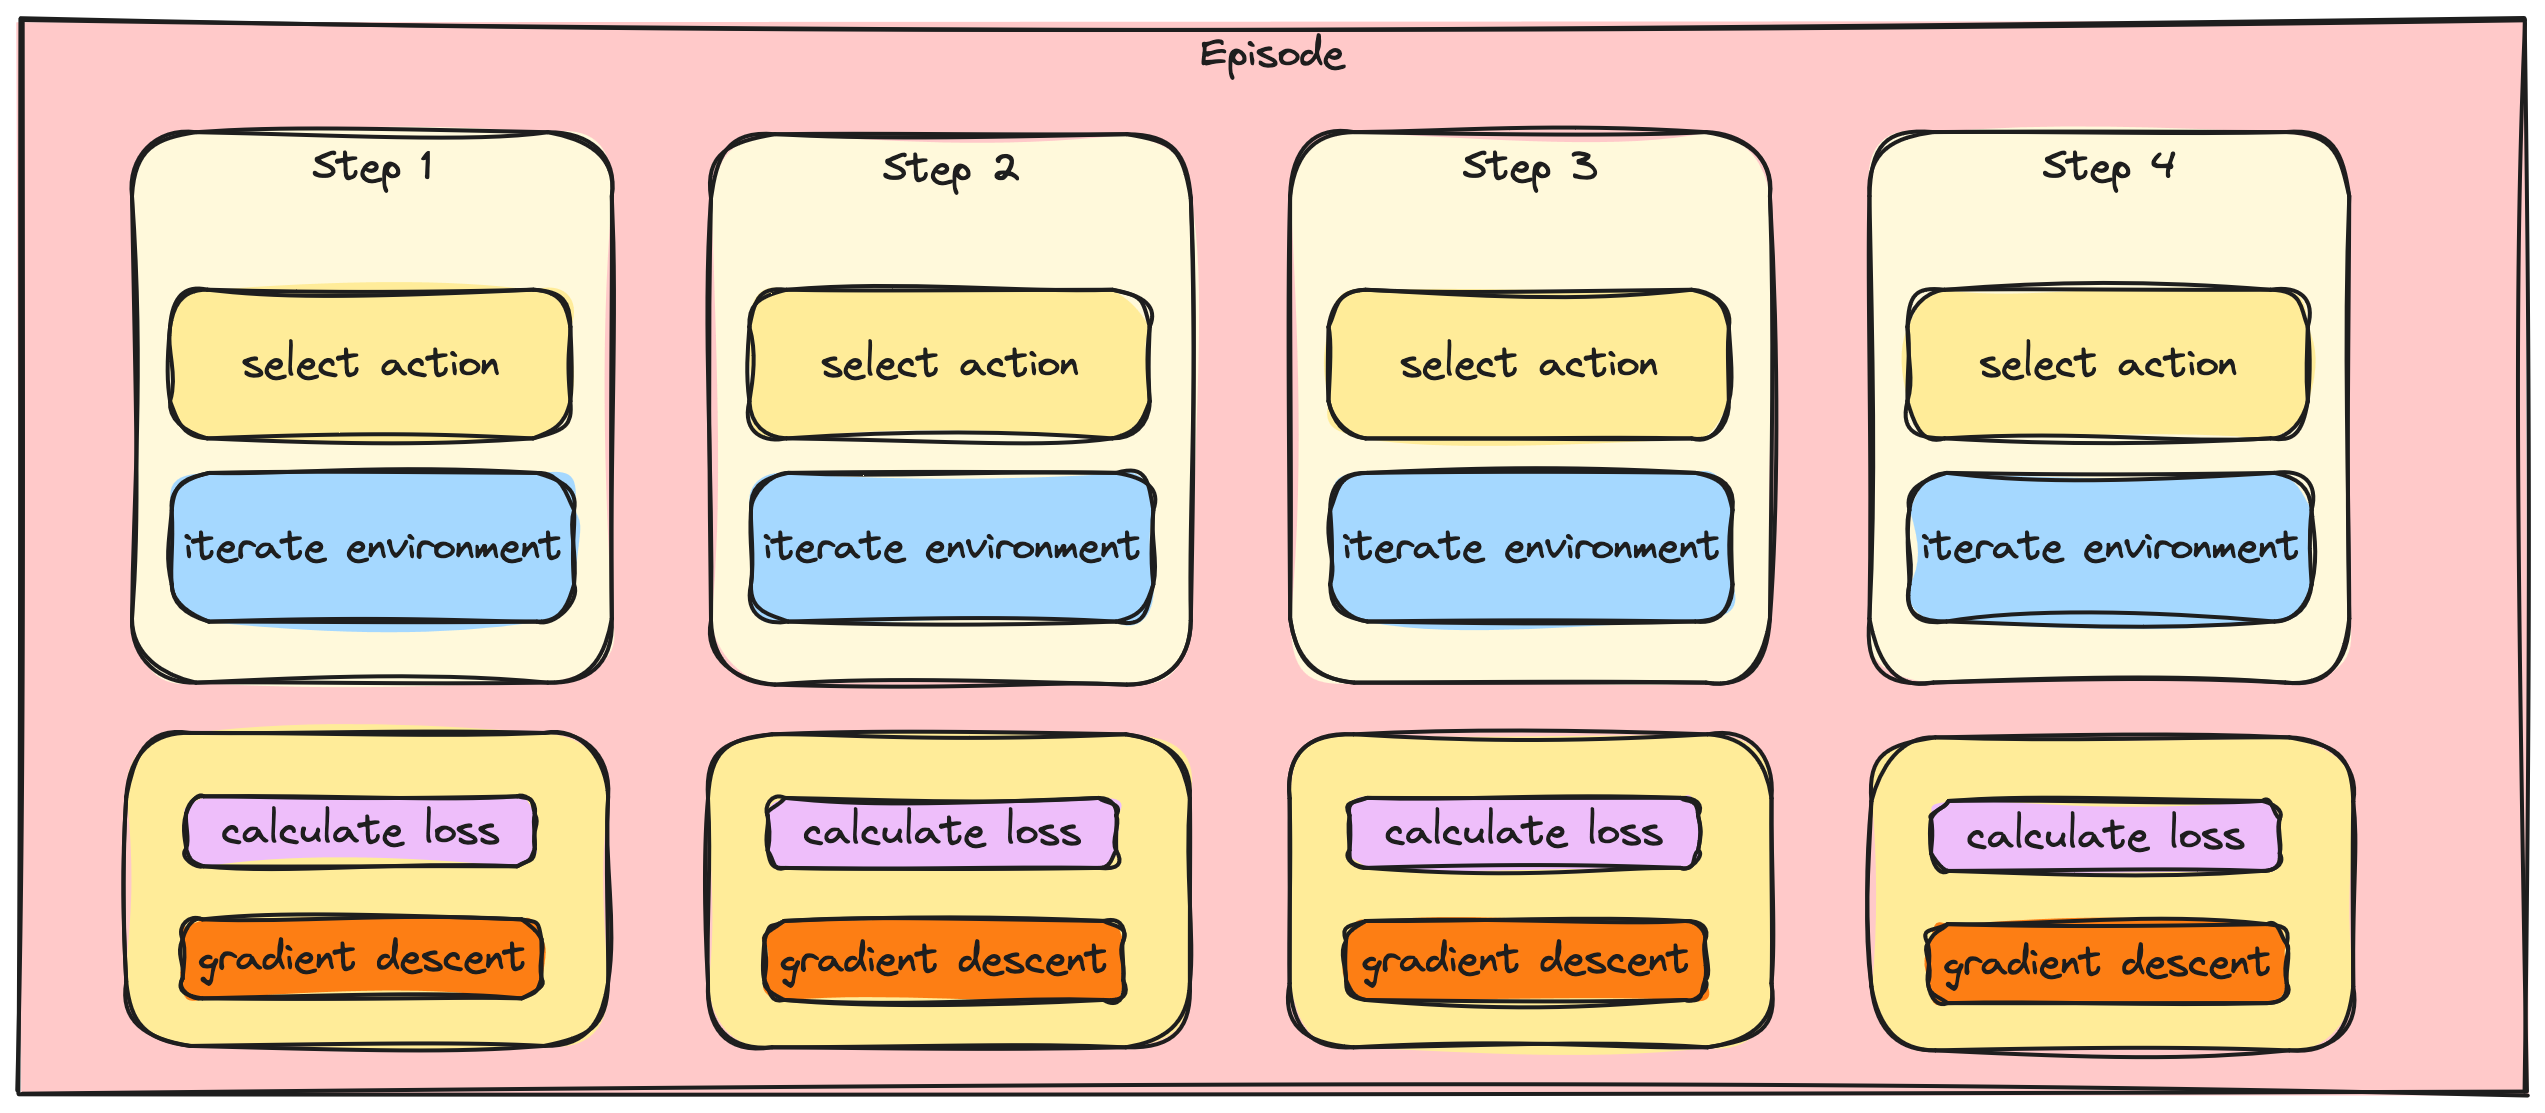
Duże pole reprezentujące epizod.

Głębokie uczenie ze wzmocnieniem w Pythonie

Aktualizacje krokowe vs. wsadowe

W dużym polu pojawia się mniejsze pole reprezentujące krok 1. Wewnątrz niego kolejne pole z tekstem 'wybierz akcję'.

Głębokie uczenie ze wzmocnieniem w Pythonie

Aktualizacje krokowe vs. wsadowe

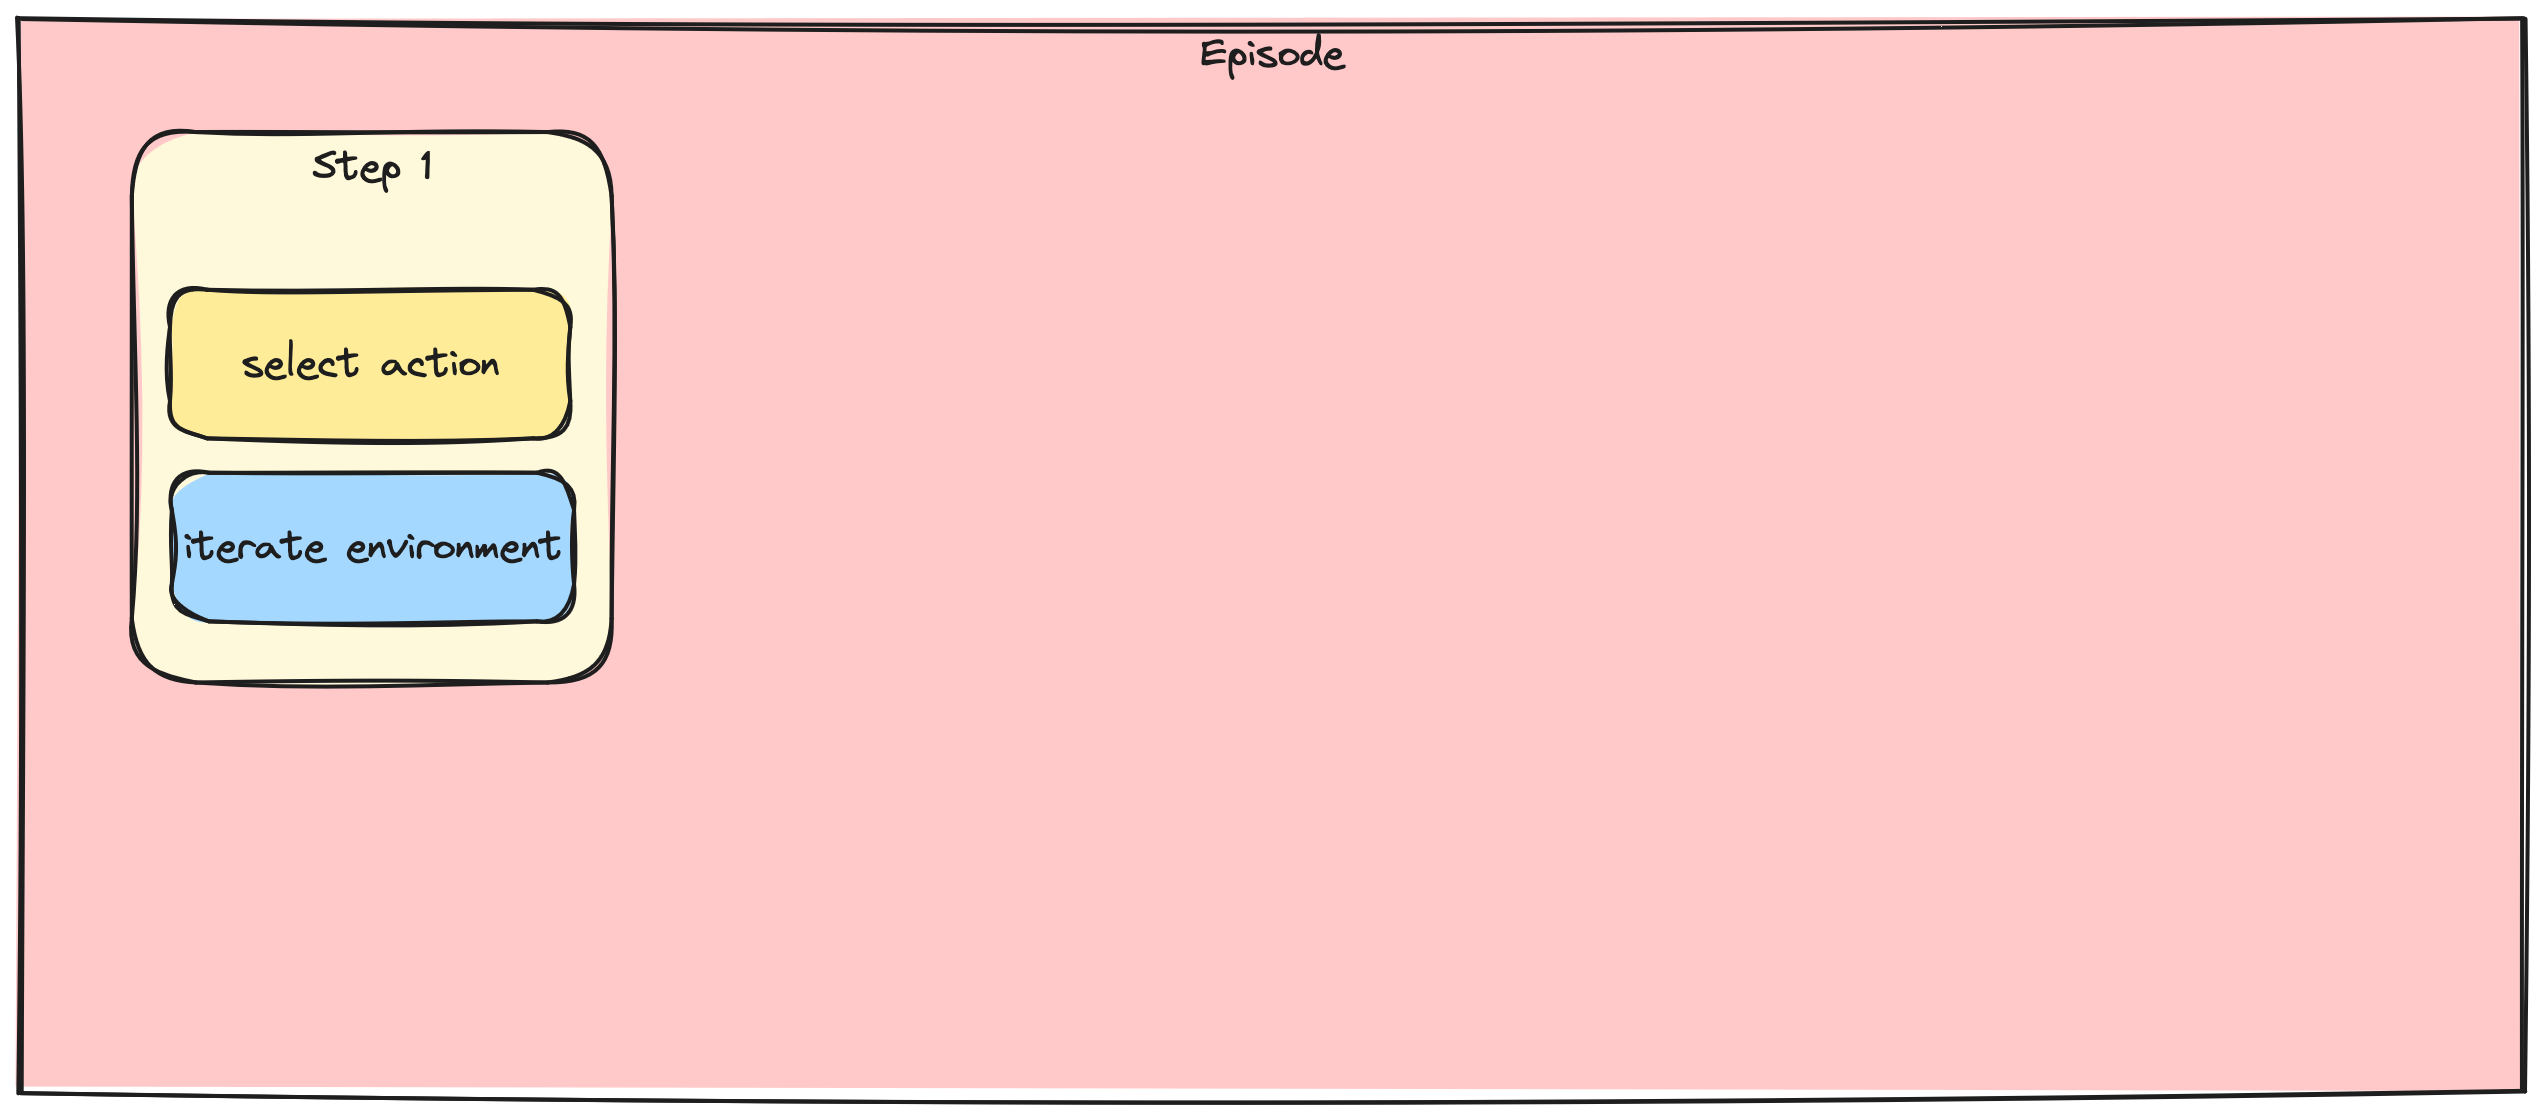
W polu kroku 1 pojawia się kolejne małe pole z tekstem 'iteruj środowisko'

Głębokie uczenie ze wzmocnieniem w Pythonie

Aktualizacje krokowe vs. wsadowe

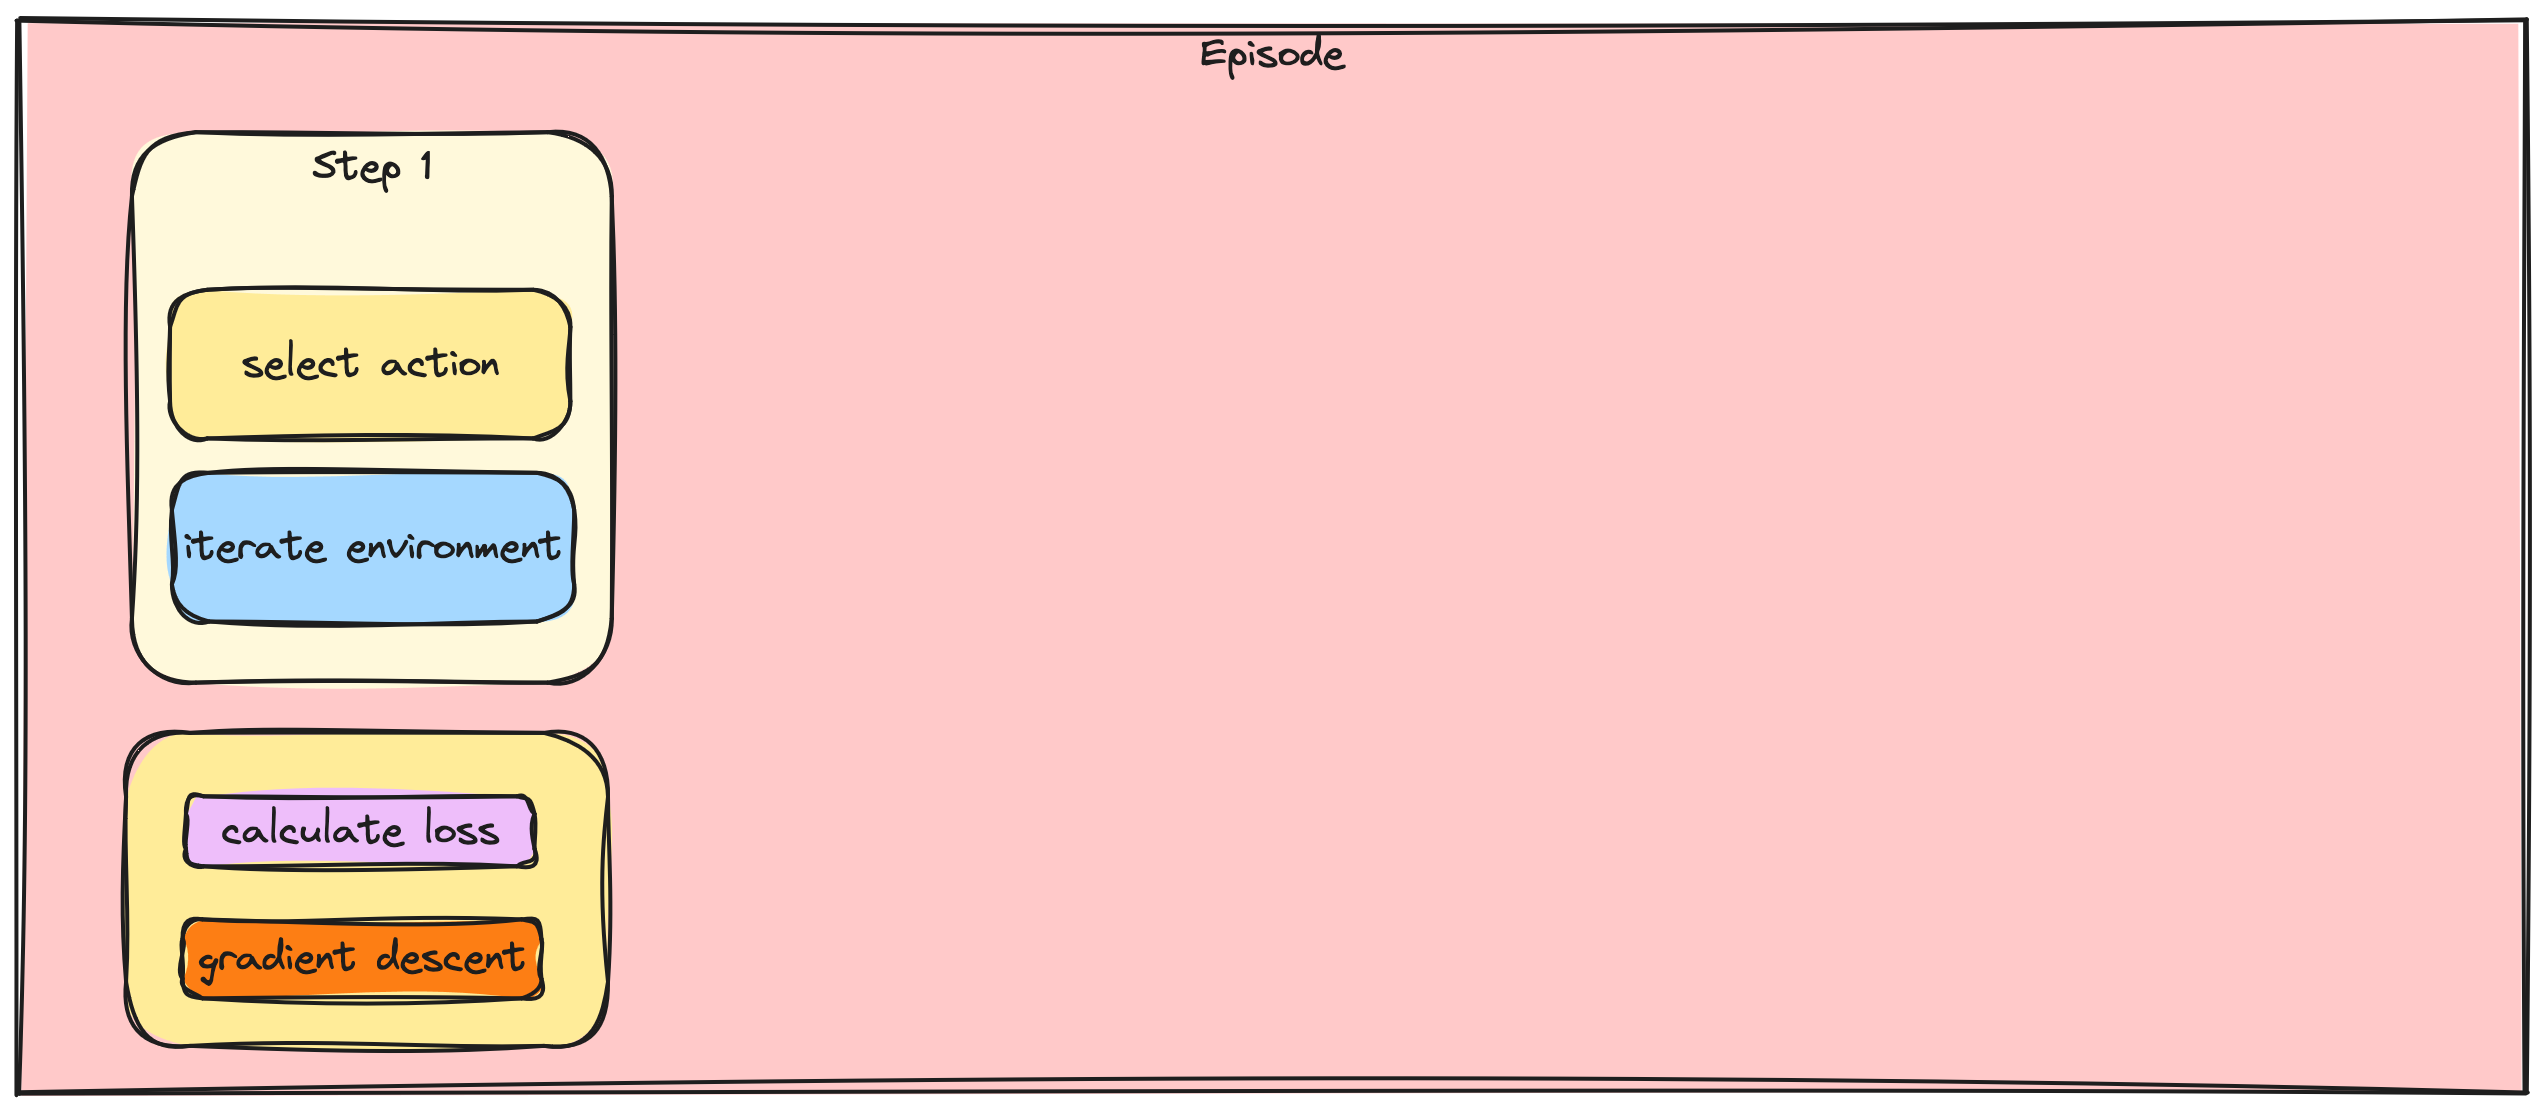
Pod polem kroku 1 pojawia się kolejne pole z etykietami 'oblicz stratę' i 'zejście gradientowe'

Głębokie uczenie ze wzmocnieniem w Pythonie

Aktualizacje krokowe vs. wsadowe

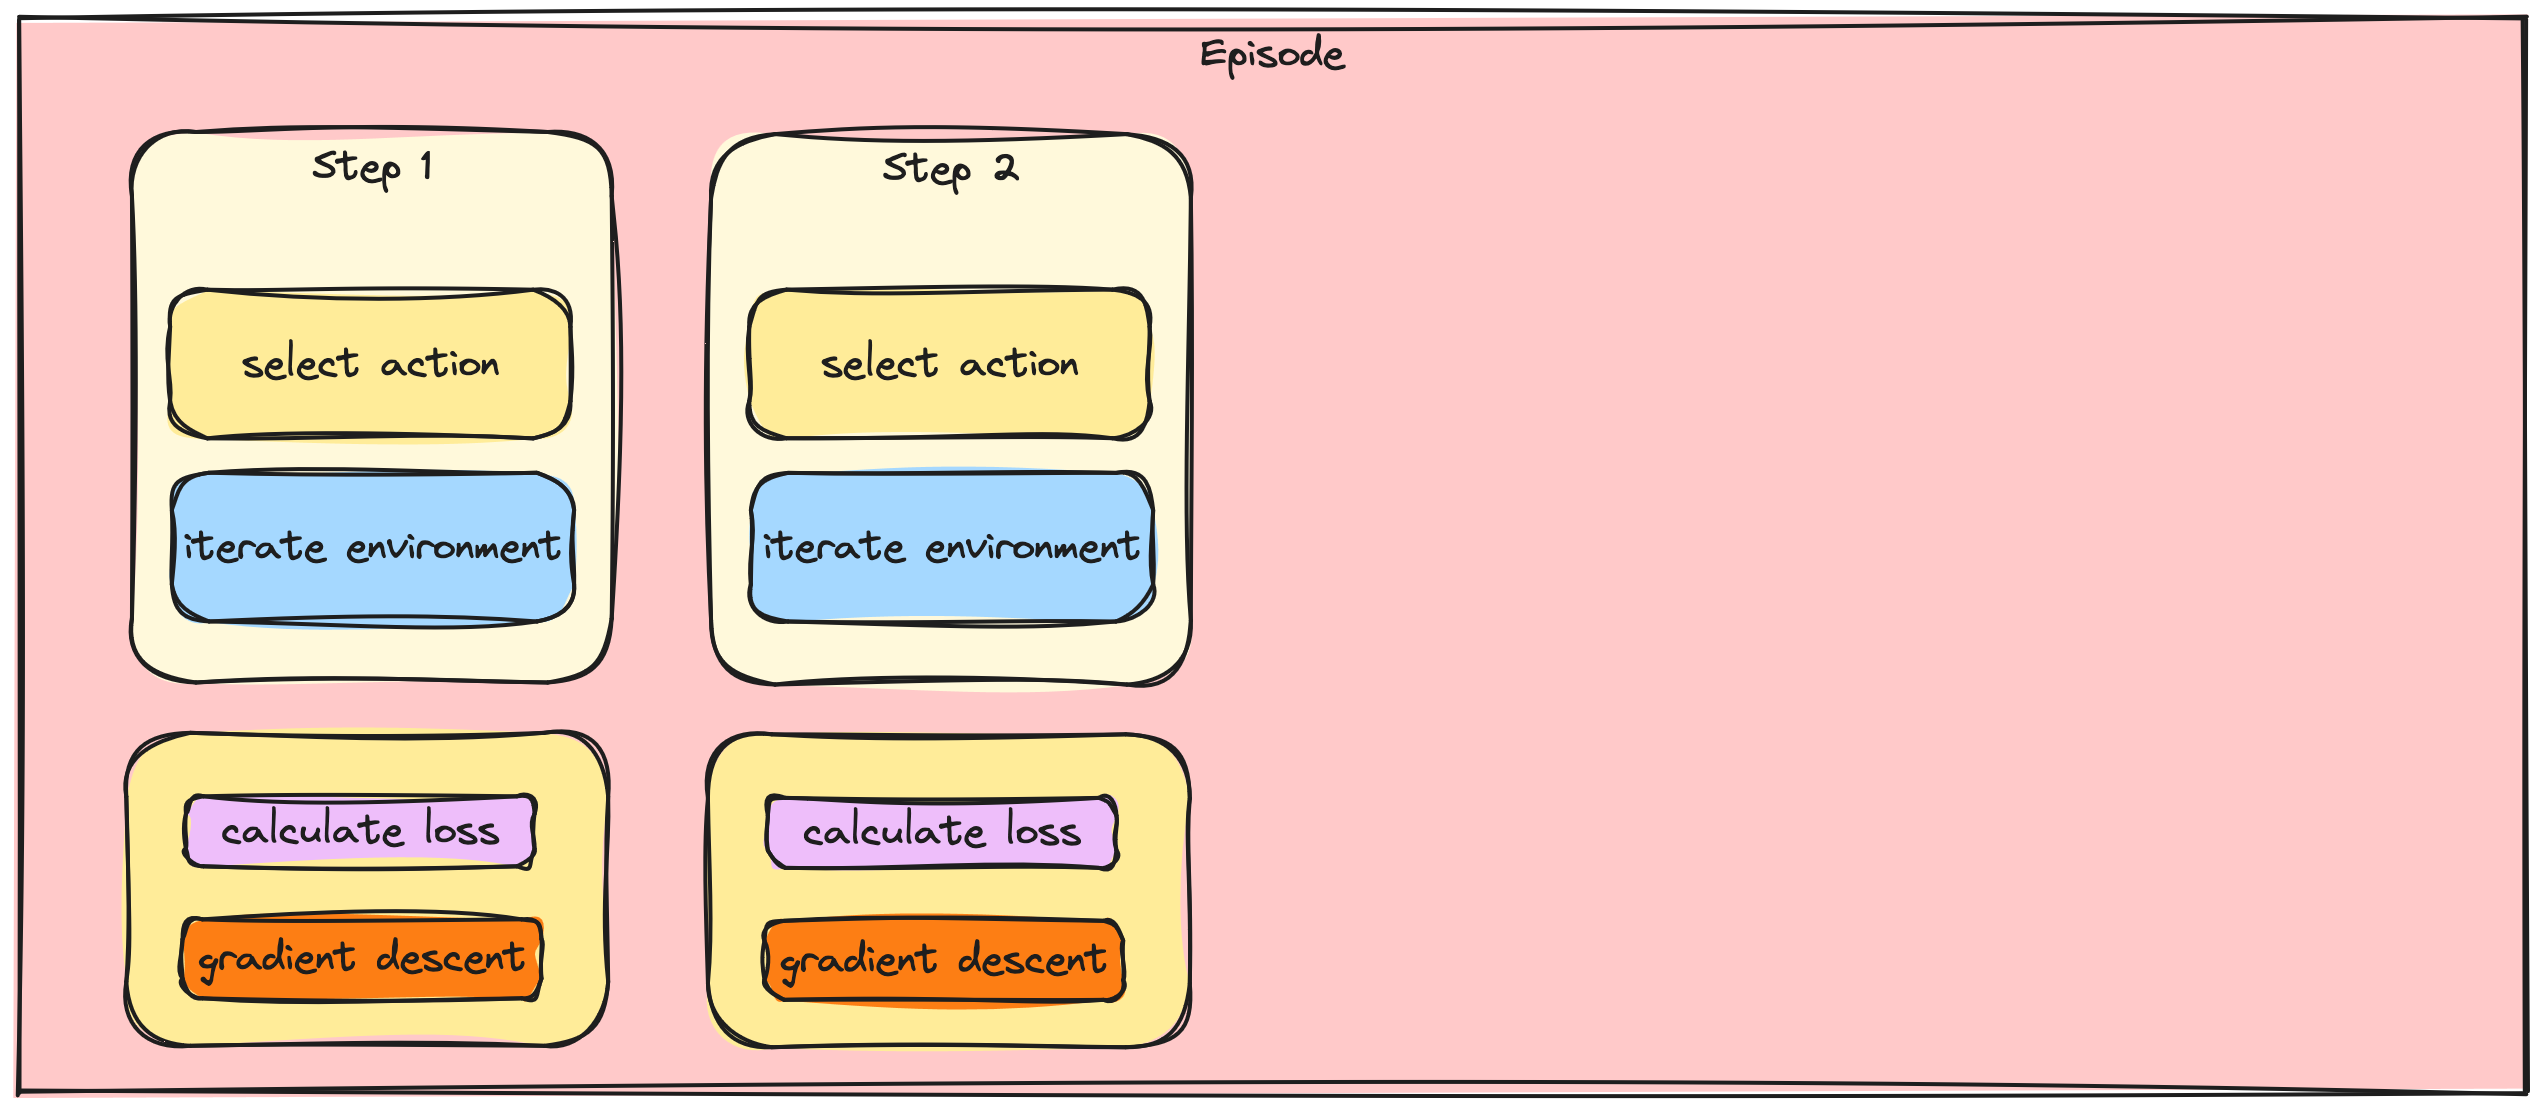
Dla drugiego kroku pojawia się identyczna para pól z tą samą zawartością

Głębokie uczenie ze wzmocnieniem w Pythonie

Aktualizacje krokowe vs. wsadowe

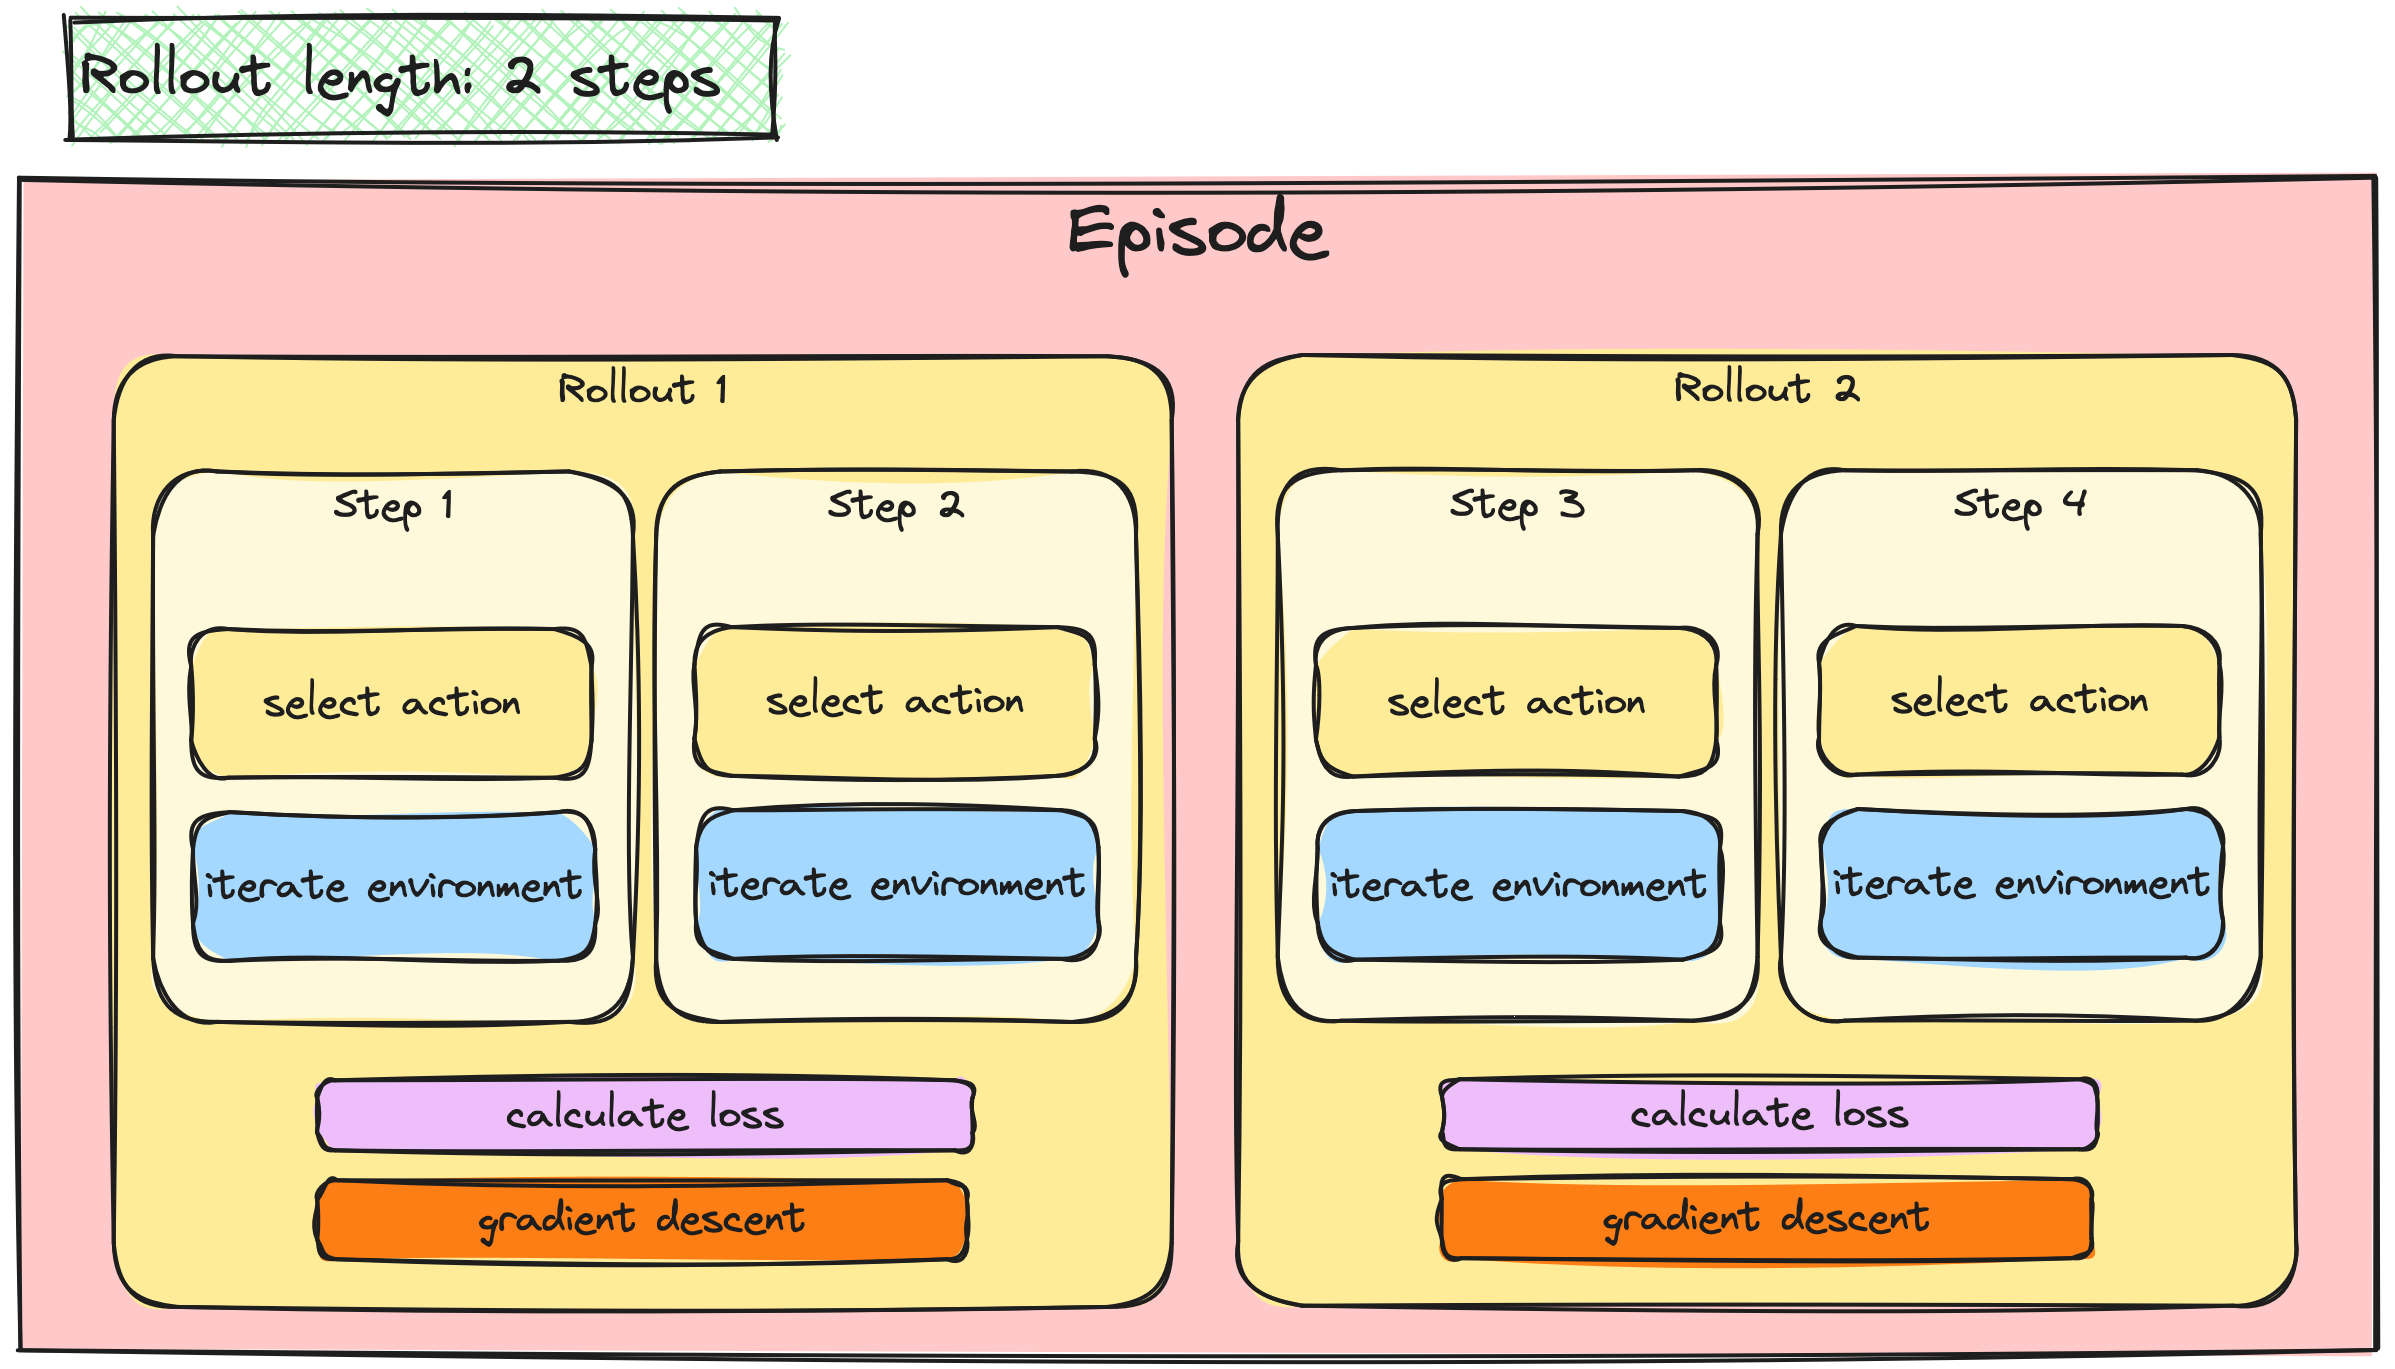
Pojawiają się również kroki 3 i 4.

Głębokie uczenie ze wzmocnieniem w Pythonie

Grupowanie aktualizacji A2C / PPO

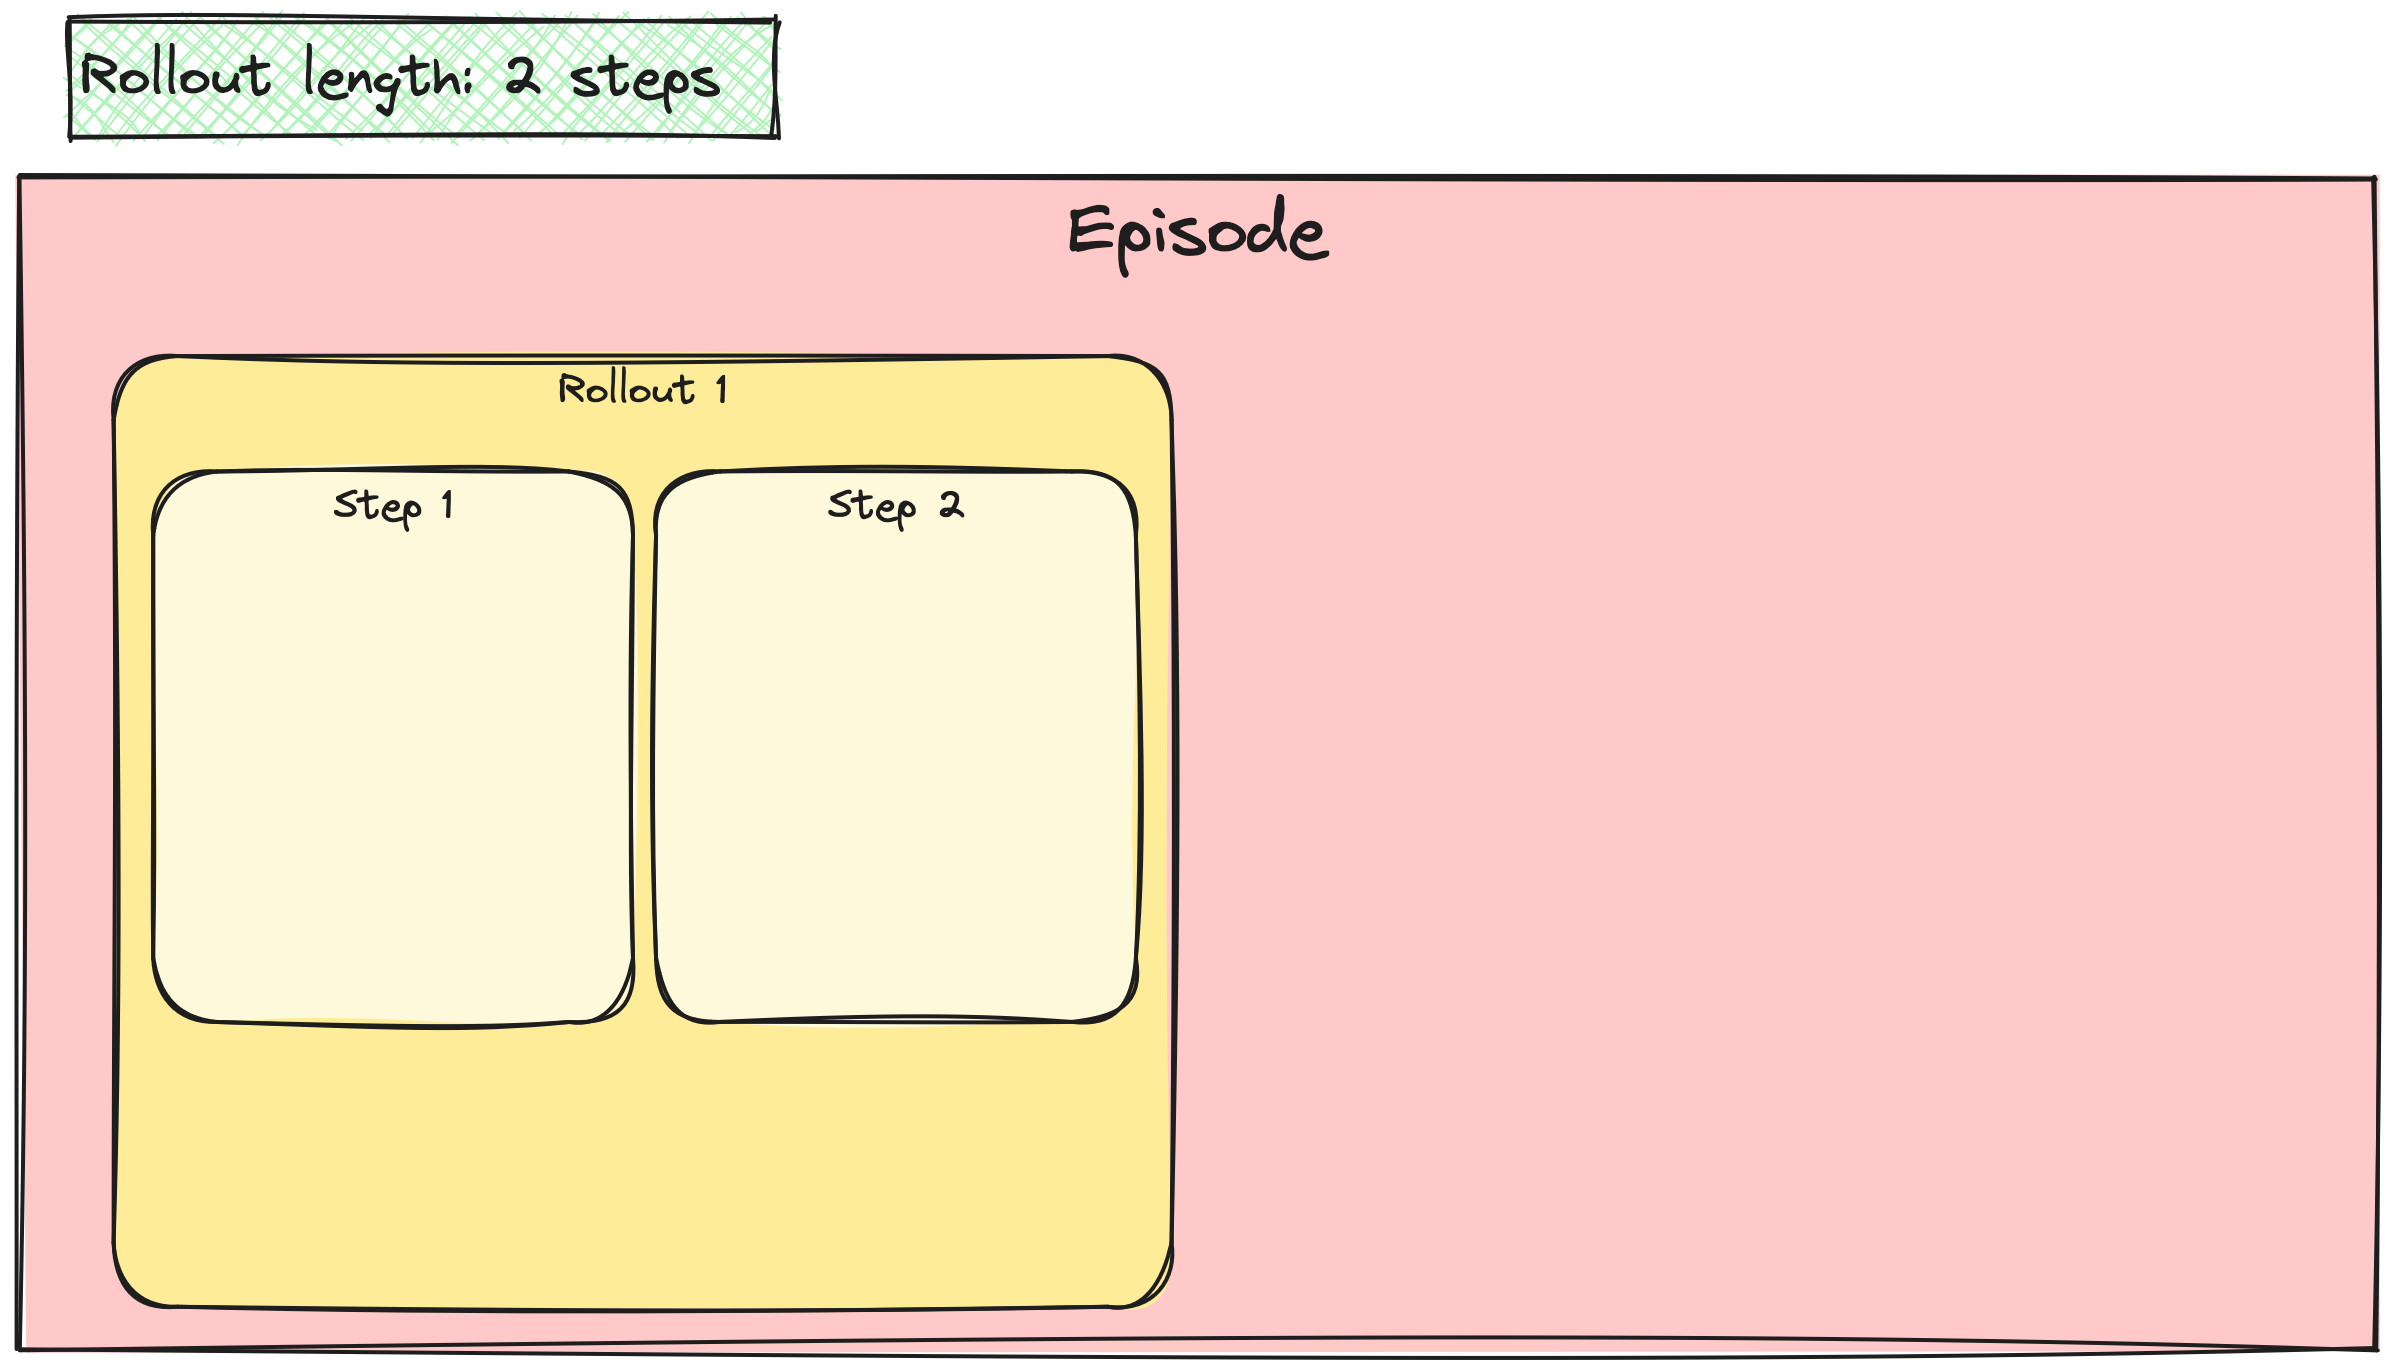
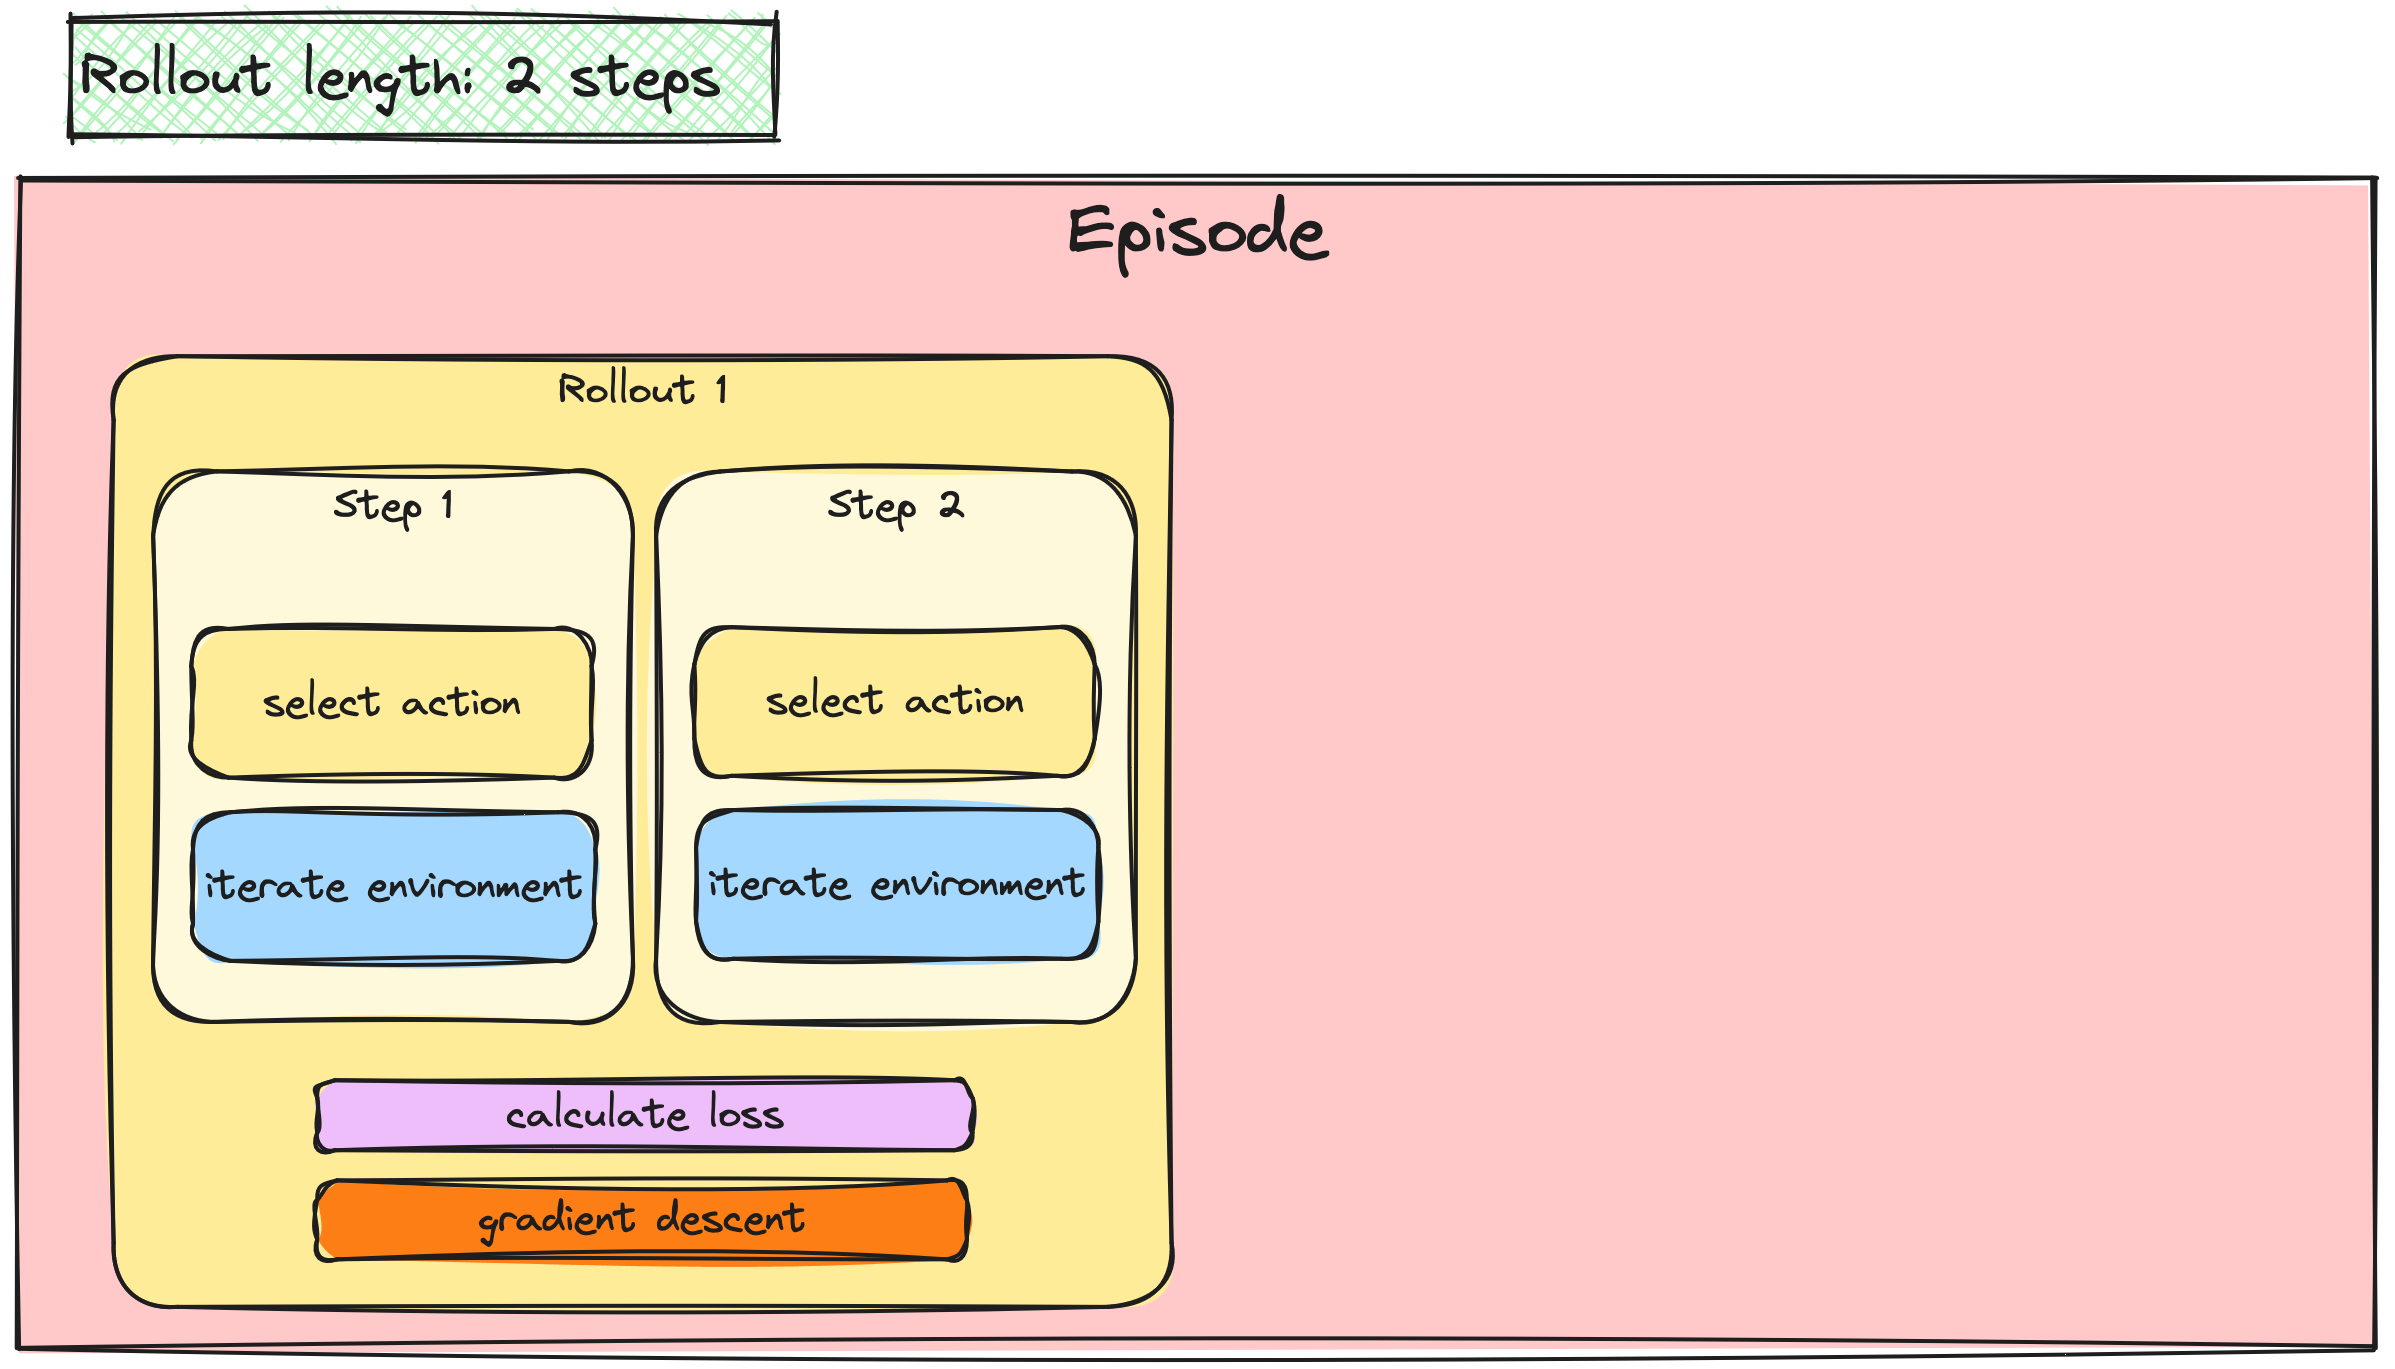
Duże pole epizodu; zajmując jego połowę, pole oznaczone 'rollout 1'; wewnątrz dwa puste pola oznaczone 'krok 1' i 'krok 2'

Głębokie uczenie ze wzmocnieniem w Pythonie

Grupowanie aktualizacji A2C / PPO

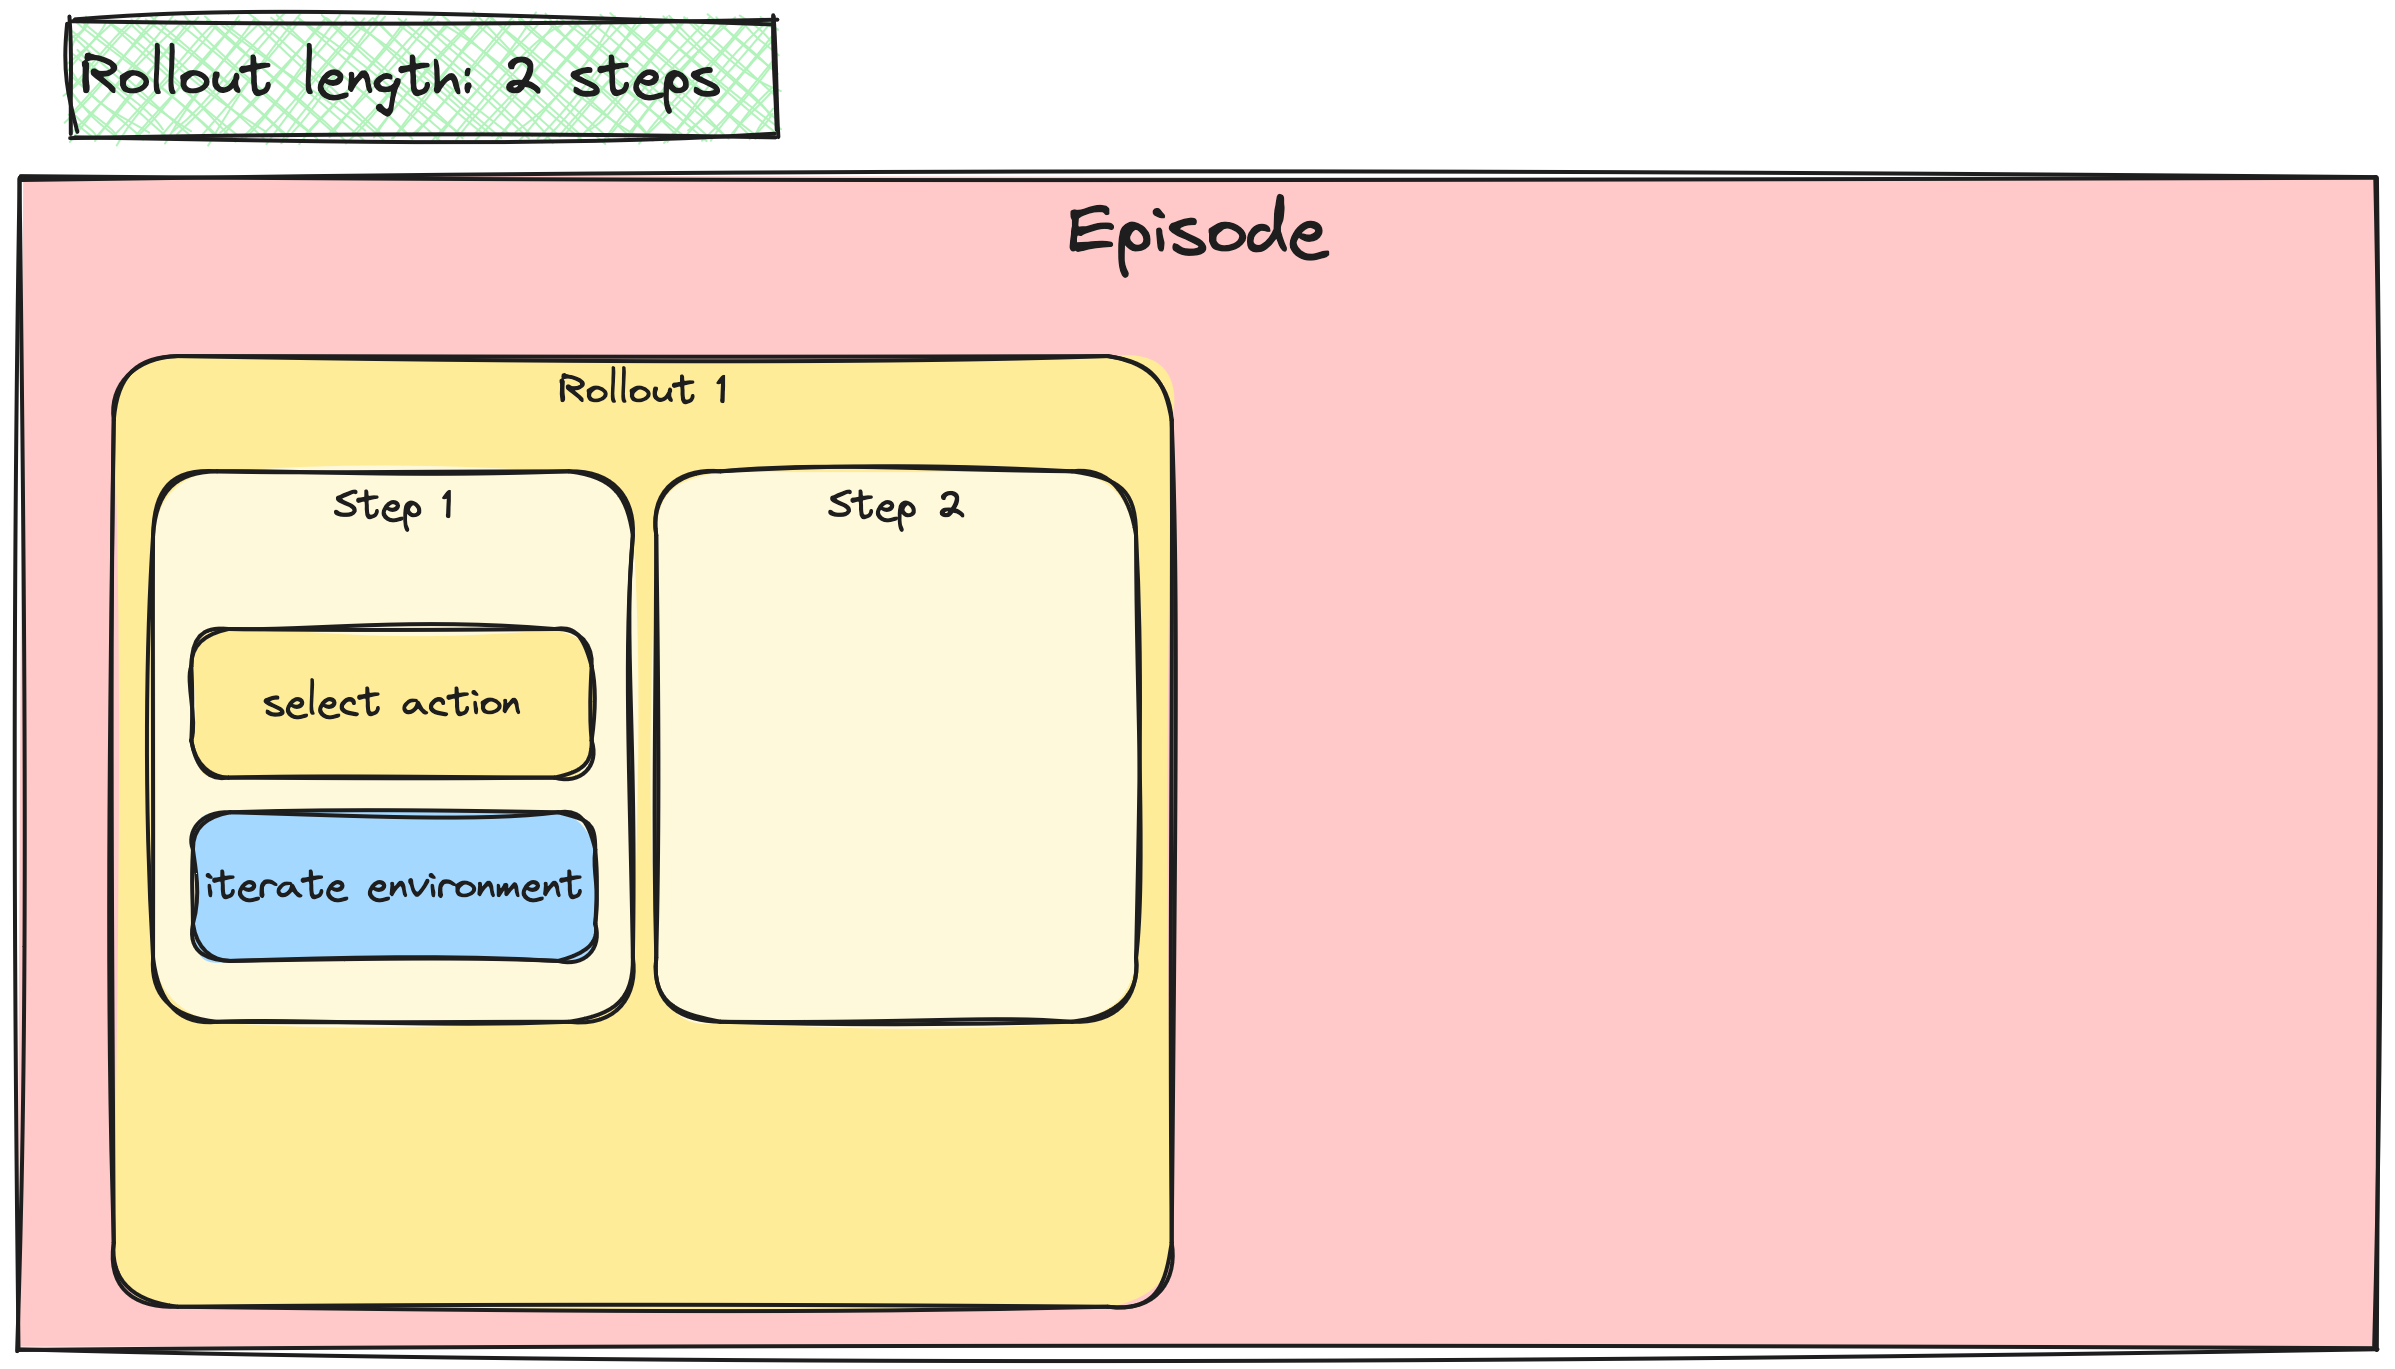
W polu kroku 1 pojawiają się etykiety 'wybierz akcję' i 'iteruj środowisko'.

Głębokie uczenie ze wzmocnieniem w Pythonie

Grupowanie aktualizacji A2C / PPO

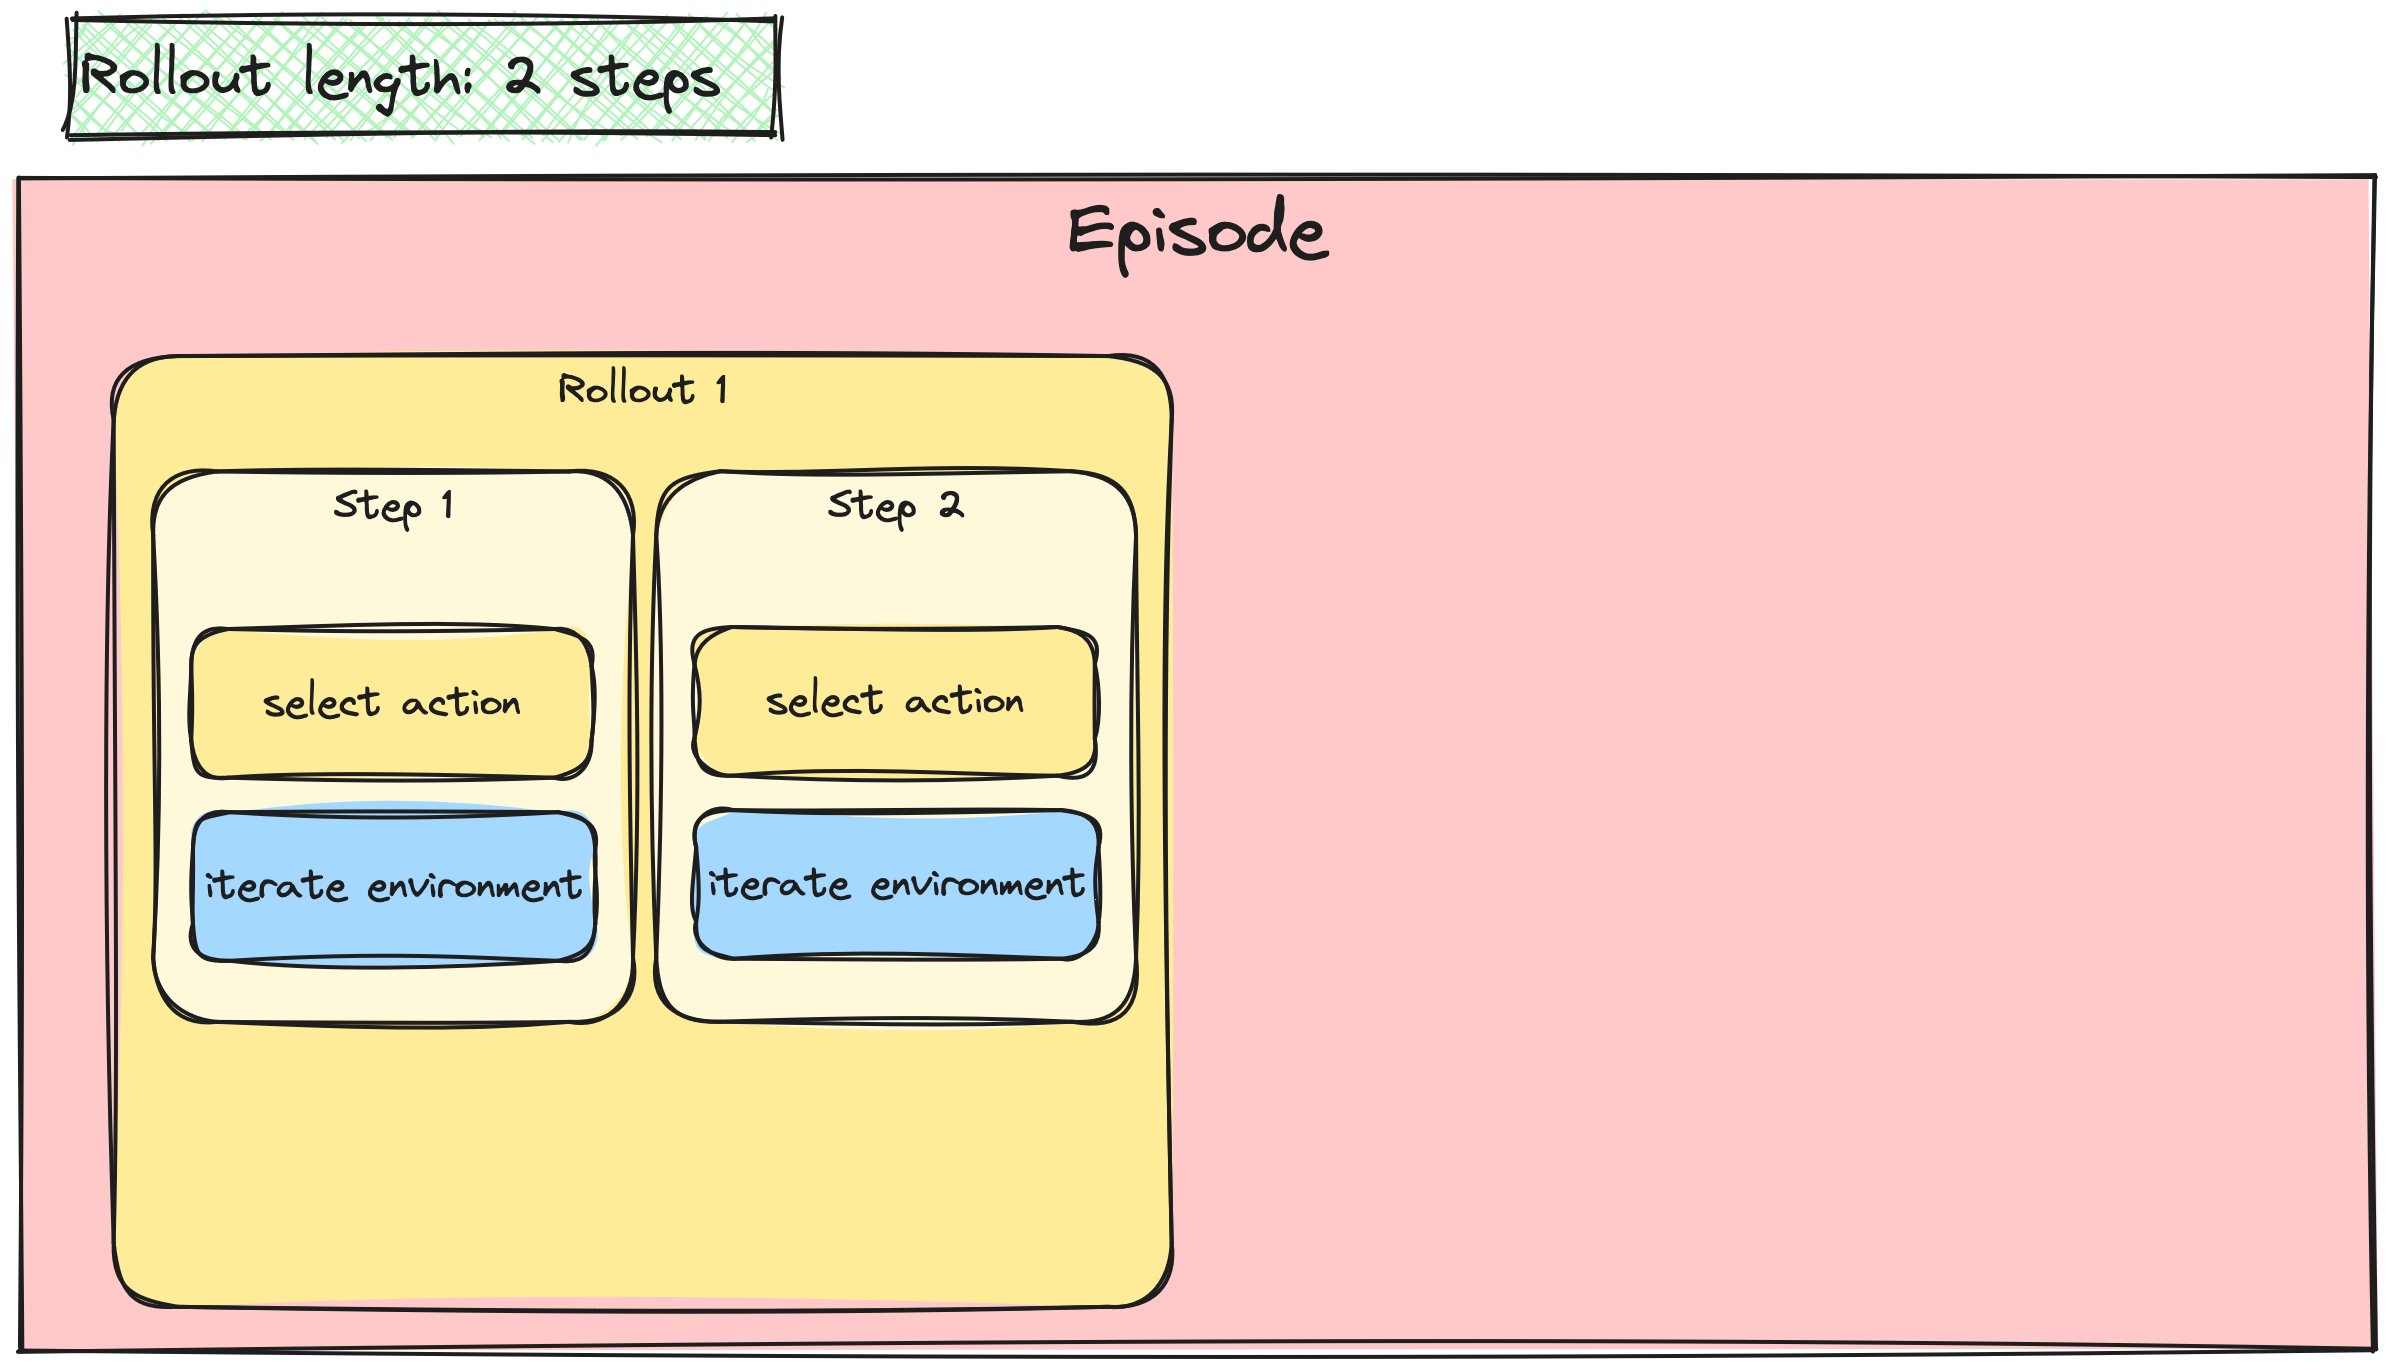
To samo dla kroku 2.

Głębokie uczenie ze wzmocnieniem w Pythonie

Grupowanie aktualizacji A2C / PPO

Pod polami kroku 1 i kroku 2 pojawia się pojedyncza etykieta 'oblicz stratę' i pojedyncza etykieta 'zejście gradientowe'.

Głębokie uczenie ze wzmocnieniem w Pythonie

Grupowanie aktualizacji A2C / PPO

Pozostała połowa obszaru epizodu zajęta jest przez kolejne identyczne pole rollout z dwoma krokami, oznaczone 'rollout 2'.

Głębokie uczenie ze wzmocnieniem w Pythonie

Pętla treningowa A2C z aktualizacjami wsadowymi


# Set rollout length
rollout_length = 10

# Initiate loss batches
actor_losses = torch.tensor([]) critic_losses = torch.tensor([])
  • Zainicjuj partie strat
  • Iteruj przez epizody i kroki jak zwykle


for episode in range(10):
  state, info = env.reset()
  done = False
  while not done:
    action, action_log_prob = select_action(actor, 
                                            state)                
    next_state, reward, terminated, truncated, _ = (
                                   env.step(action))
    done = terminated or truncated    
    actor_loss, critic_loss = calculate_losses(
        critic, action_log_prob, 
        reward, state, next_state, done)
    ...
Głębokie uczenie ze wzmocnieniem w Pythonie

Pętla treningowa A2C z aktualizacjami wsadowymi

  ...
  actor_losses = torch.cat((actor_losses, actor_loss))
  critic_losses = torch.cat((critic_losses, critic_loss))

# If rollout is full, update the networks if len(actor_losses) >= rollout_length:
actor_loss_batch = actor_losses.mean() critic_loss_batch = critic_losses.mean()
actor_optimizer.zero_grad() actor_loss_batch.backward() actor_optimizer.step() critic_optimizer.zero_grad() critic_loss_batch.backward() critic_optimizer.step()
actor_losses = torch.tensor([]) critic_losses = torch.tensor([])
state = next_state


  • Dodaj stratę kroku do partii strat
  • Gdy rollout jest pełny:
    • Oblicz średnią stratę partii za pomocą .mean()
    • Wykonaj zejście gradientowe
    • Zresetuj partie strat
Głębokie uczenie ze wzmocnieniem w Pythonie

A2C / PPO z wieloma agentami


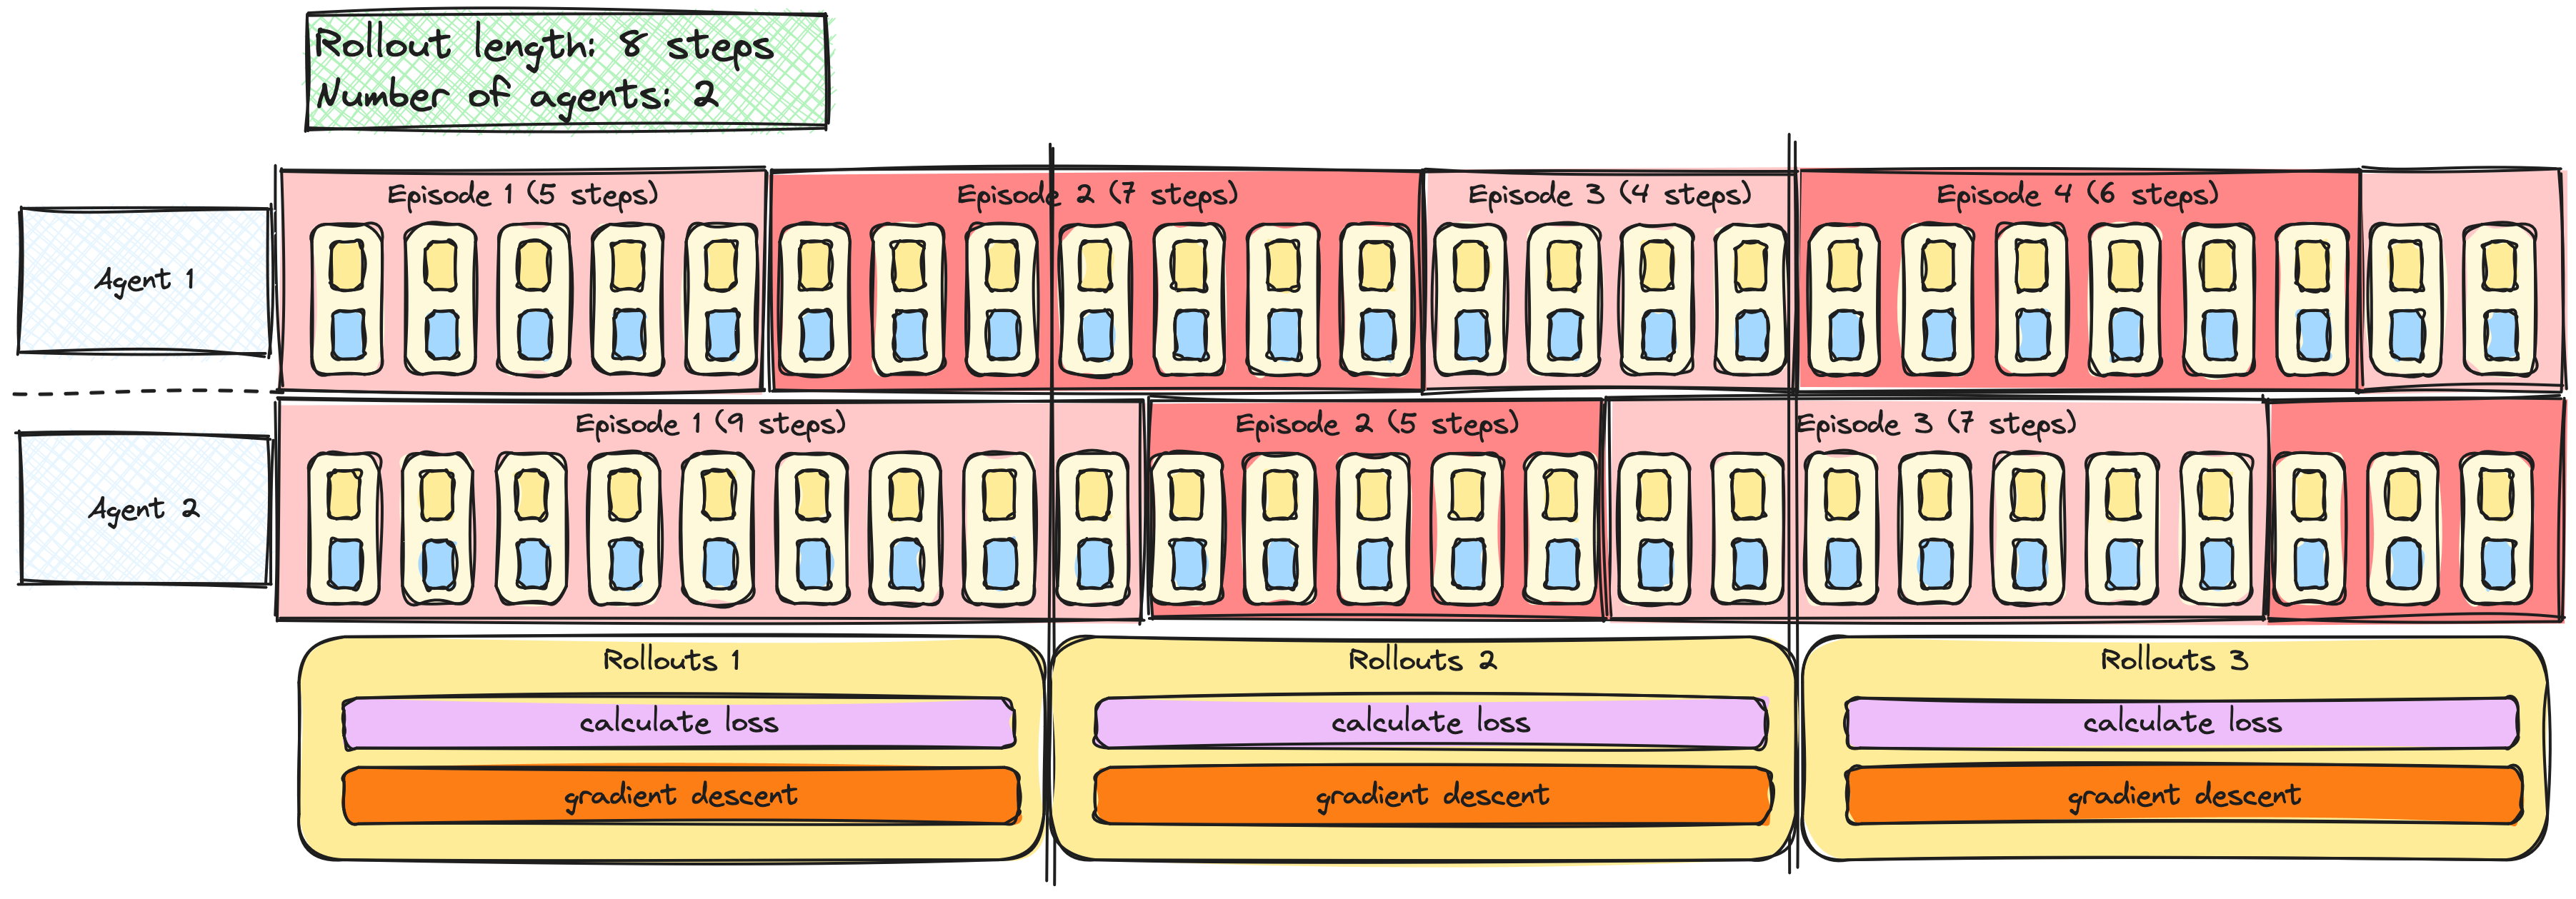
Dwa poziome pasy reprezentują agenta 1 i agenta 2. Każdy agent doświadcza odpowiednio 4 i 3 epizodów o różnej długości. W każdym epizodzie widoczne są pola kroków jak na poprzednich slajdach. Pod paskami widoczne są trzy pola rollout, każde obejmujące 8 kroków. W każdym polu rollout widoczne są etykiety 'oblicz stratę' i 'zejście gradientowe'. Na górze wykresu legenda wskazuje: 'długość rollout: 8 kroków; liczba agentów: 2'

Głębokie uczenie ze wzmocnieniem w Pythonie

Rollouty i minibatche

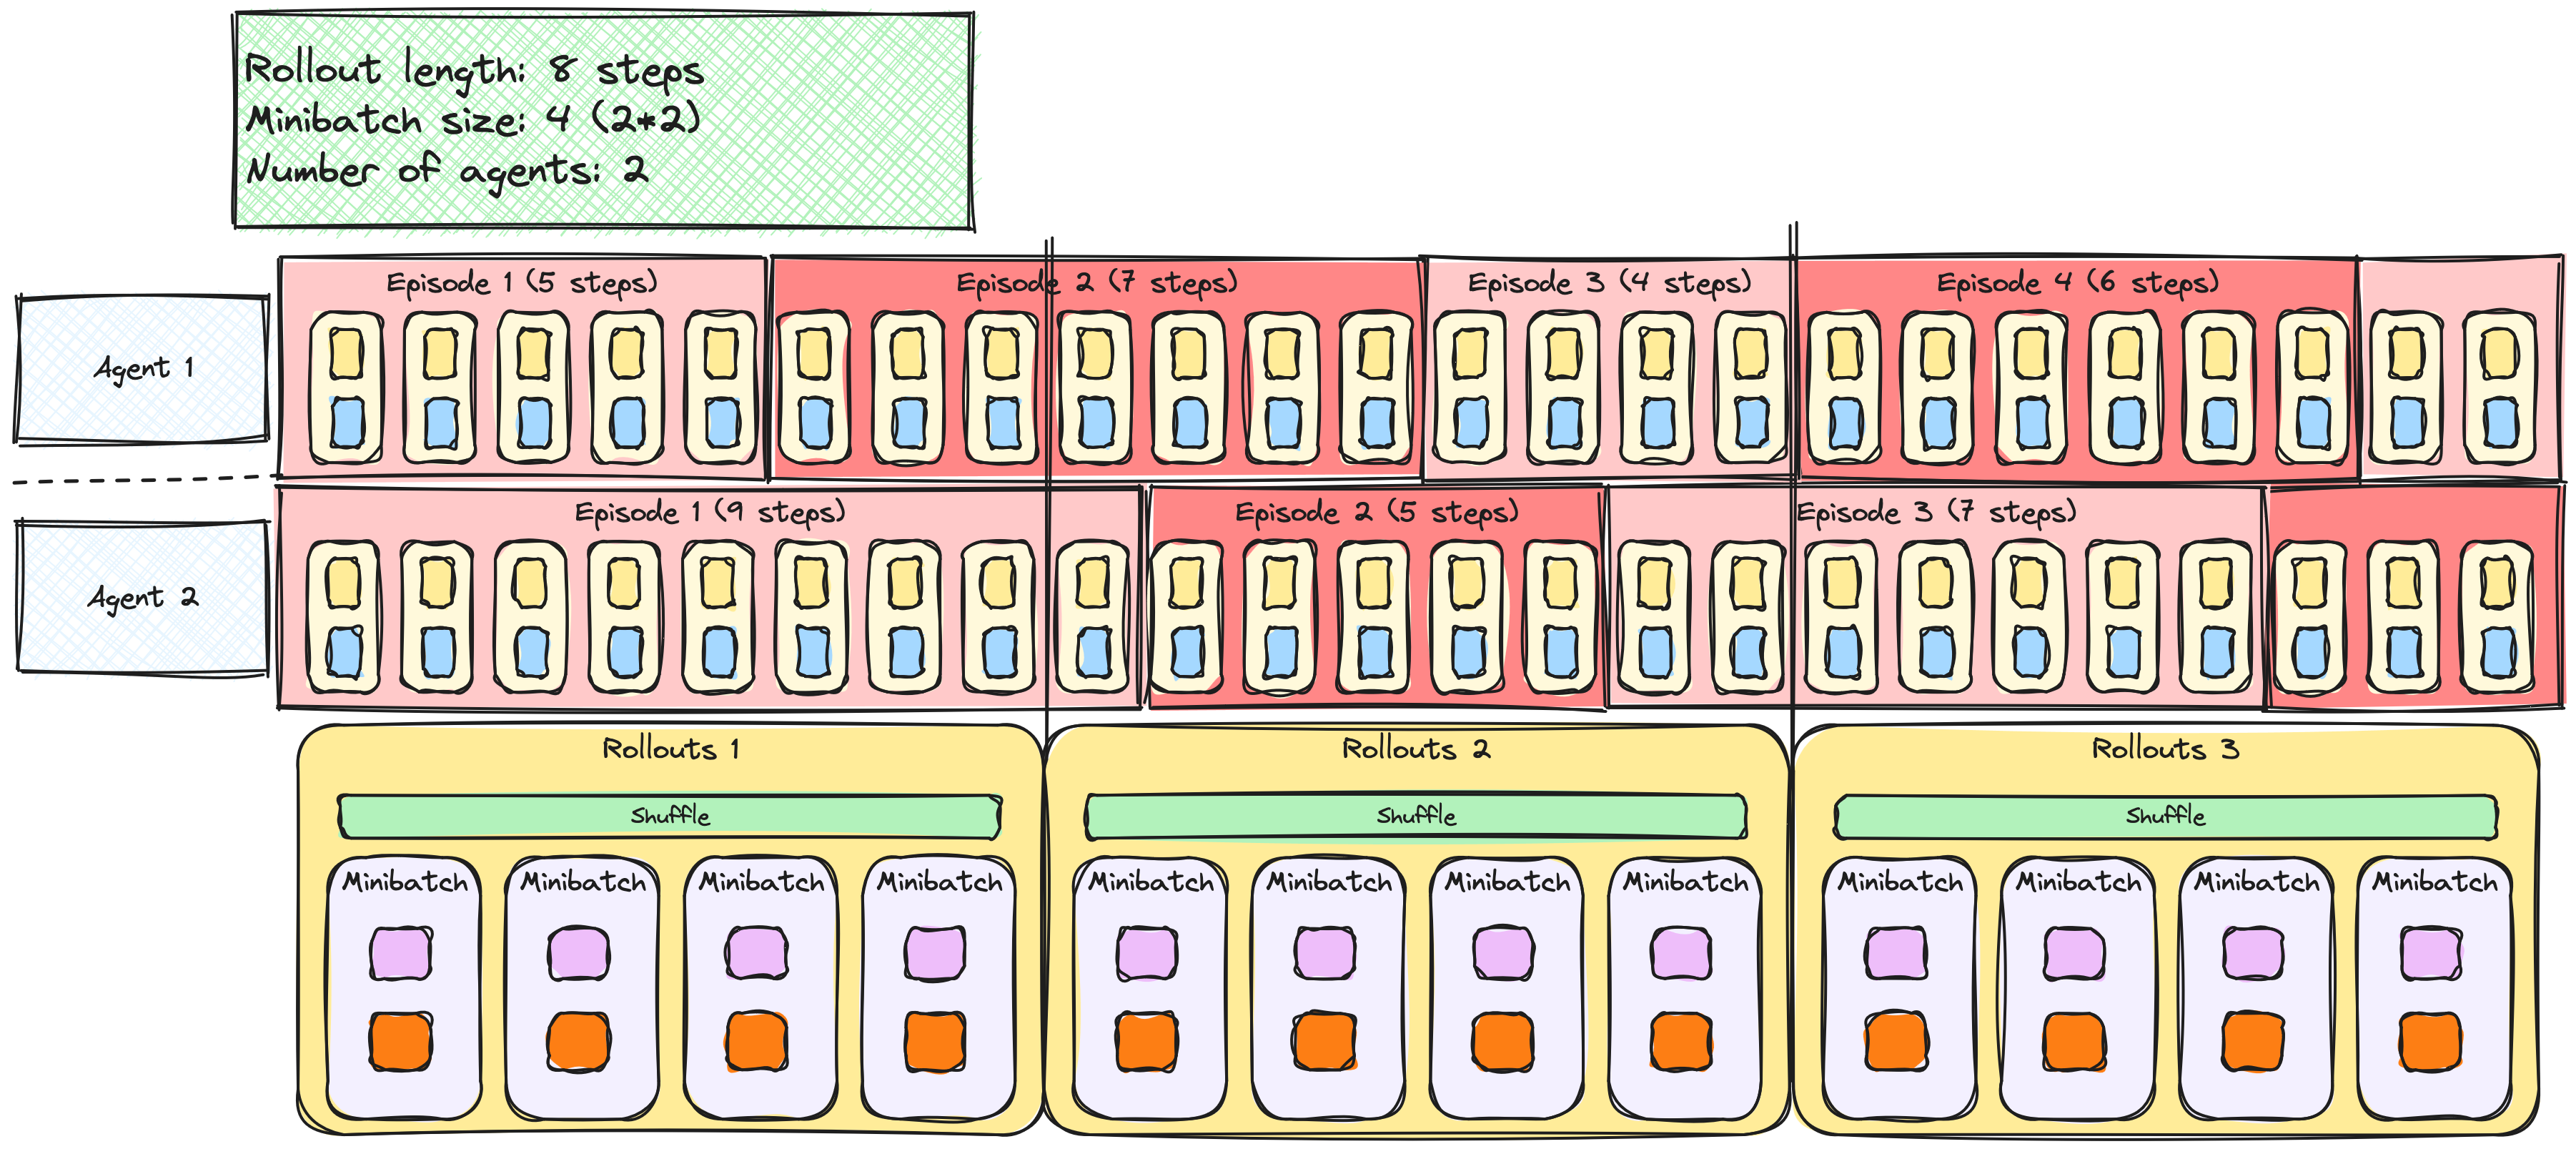
Dwa pasy agentów identyczne jak na poprzednim slajdzie. Poniżej widoczne są 3 pola rollout, których zawartość uległa zmianie. Na górze każdego duże pole oznaczone 'shuffle'. Poniżej każde pole podzielone wzdłuż na 4 pola oznaczone 'minibatch'; w każdym minibatchu pole 'oblicz stratę' i 'zejście gradientowe'. Na górze rysunku legenda: 'Długość rollout: 8 kroków; rozmiar minibatcha: 4 (2x2); liczba agentów: 2'

Głębokie uczenie ze wzmocnieniem w Pythonie

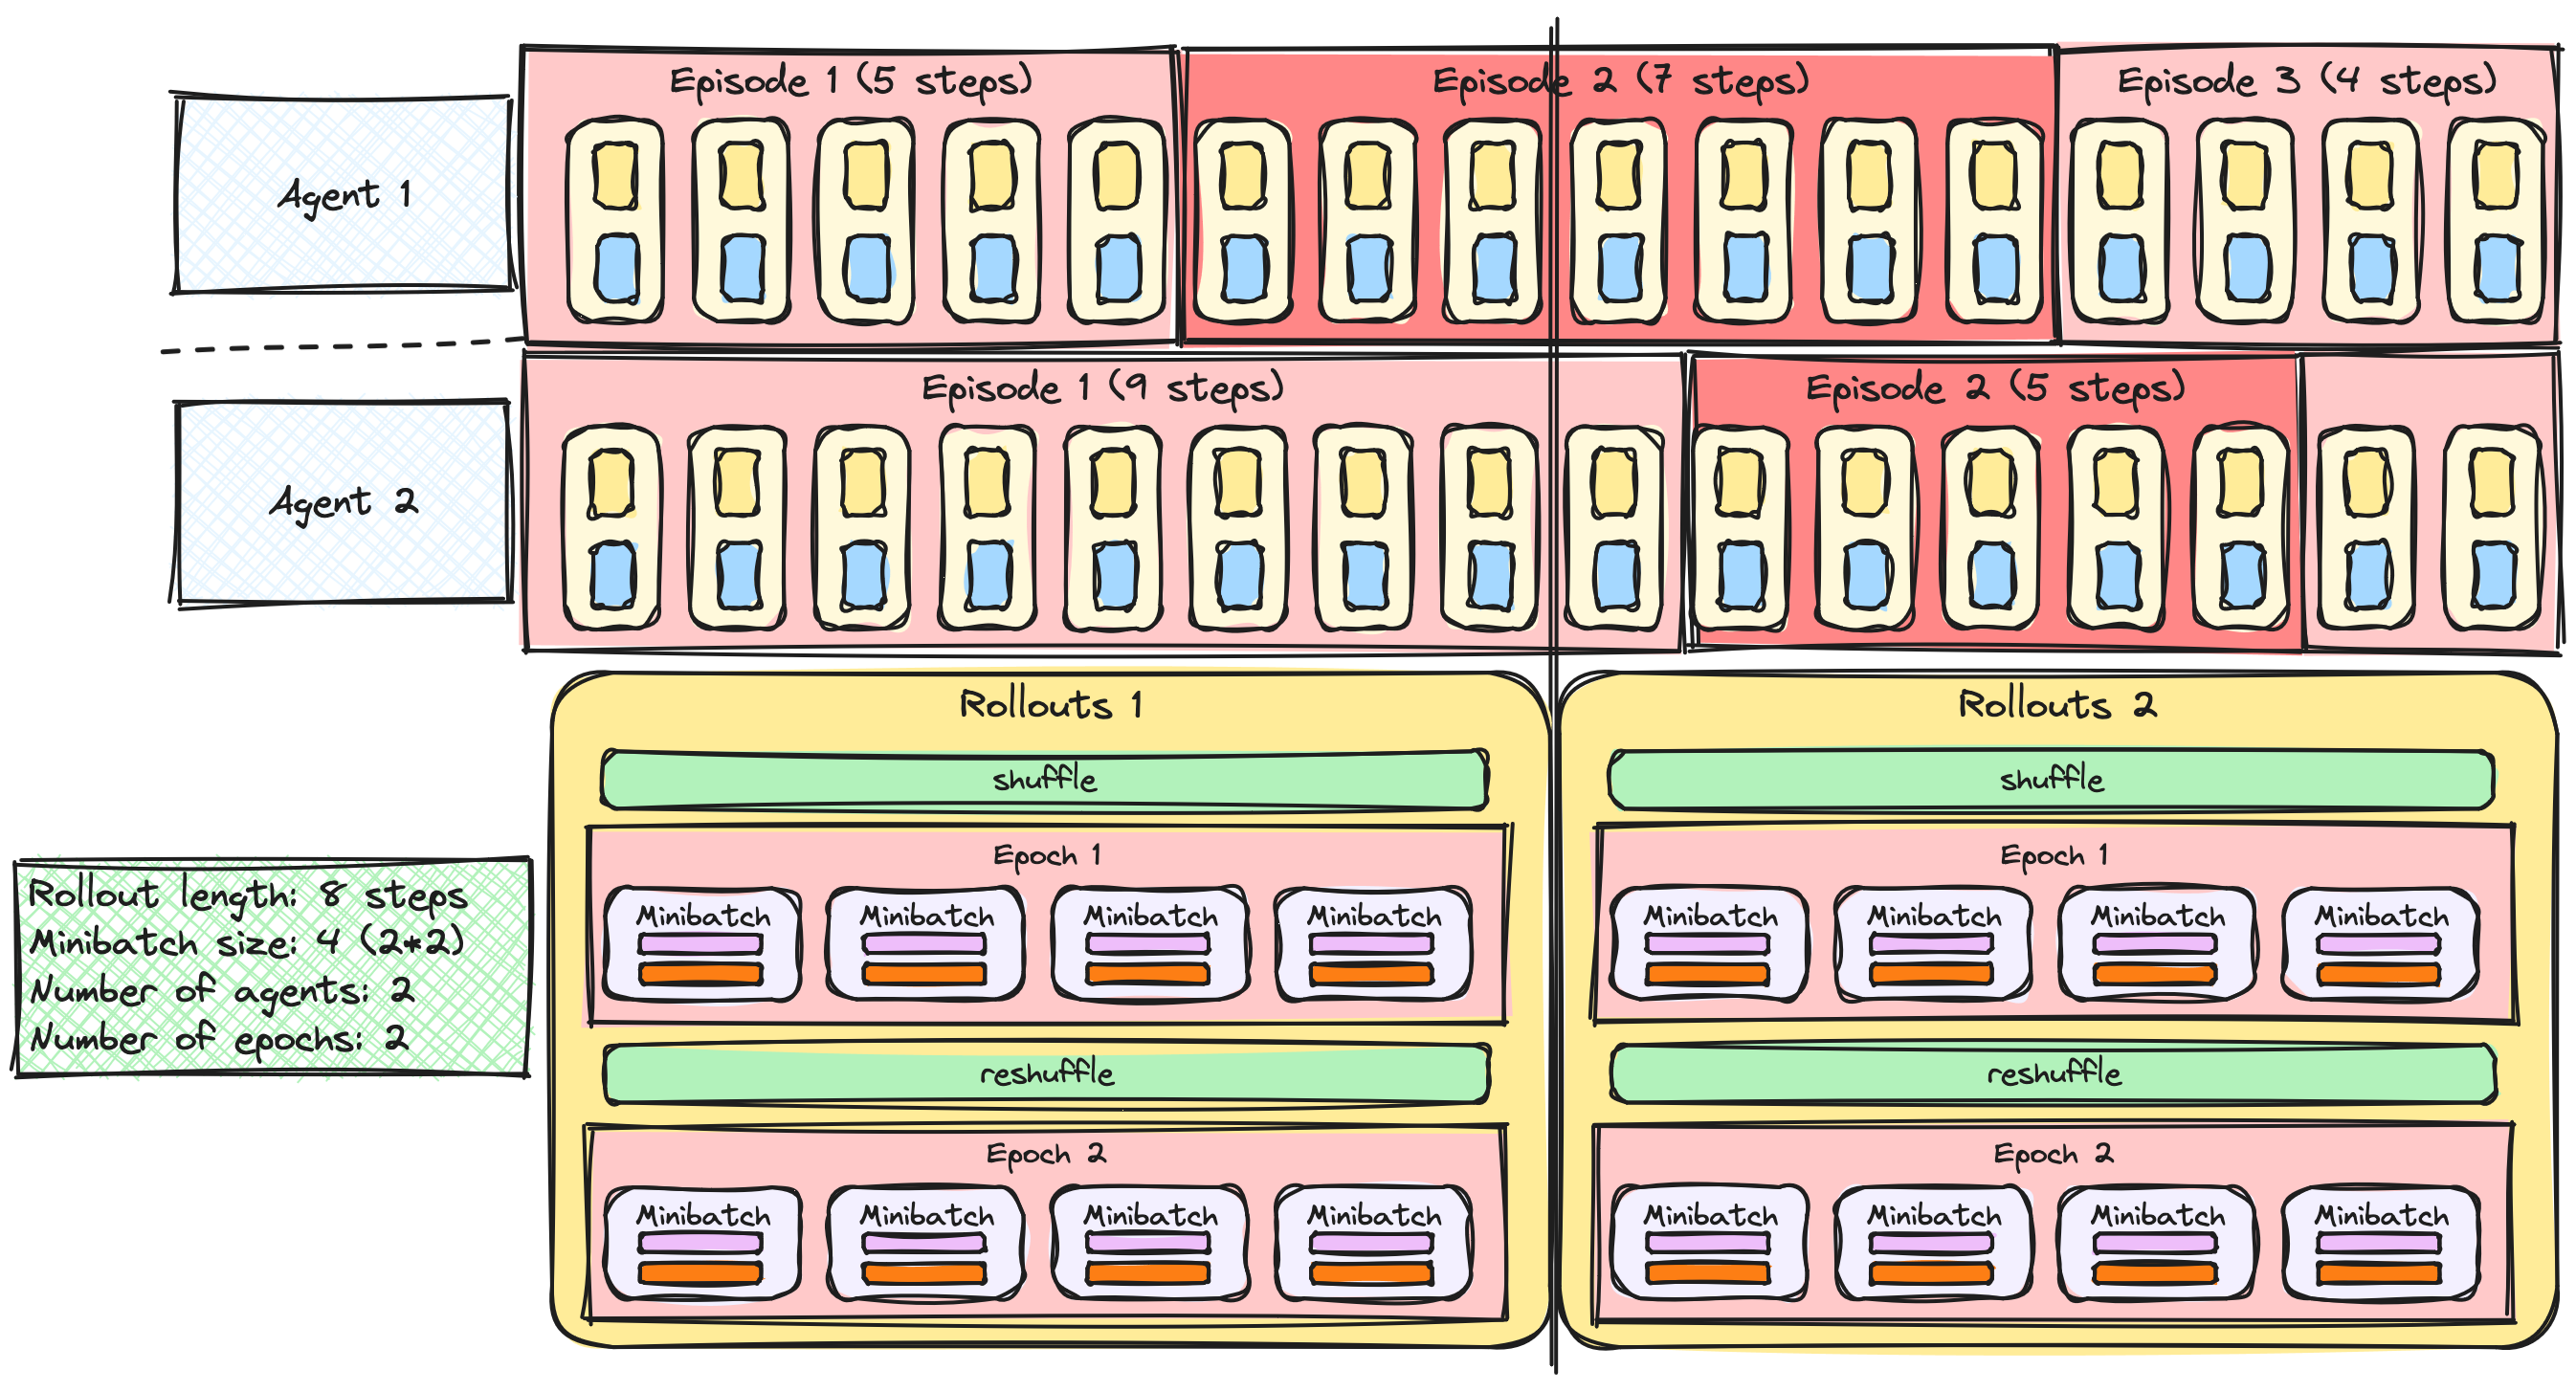
PPO z wieloma epokami

Rysunek podobny do poprzedniego, z tą różnicą, że pola rollout są teraz podzielone pionowo na 4 obszary: na górze etykieta 'shuffle'; drugi to duże pole oznaczone 'epoka 1' zawierające 4 minibatche wzdłuż; trzeci to etykieta 'reshuffle'; ostatni to duże pole oznaczone 'epoka 2', również zawierające 4 minibatche. Legenda: 'Długość rollout: 8 kroków; rozmiar minibatcha: 4 (2x2); liczba agentów: 2; liczba epok: 2'.

Głębokie uczenie ze wzmocnieniem w Pythonie

Czas na ćwiczenia!

Głębokie uczenie ze wzmocnieniem w Pythonie

Preparing Video For Download...